A quoi sert l’OCR ? Tout ce que vous devez savoir
L’OCR transforme vos PDF en données structurées. Notre guide compare technologies, coûts et précision pour vous aider à choisir.
Découvrez comment l’OCR transforme vos documents PDF et images en données structurées. Quelles technologies utiliser ? Quels sont les coûts et la précision ? Faites le bon choix avec notre guide.
Factures, bons de commande, bons de livraison, contrats, devis, quittances, relevés bancaires, certificats... Lorsque vous avez des documents sous forme de PDF ou d'images, les données sont "piégées" et inutilisables pour l'entreprise. Cependant, grâce à un logiciel OCR, vous pouvez convertir vos documents non structurés en informations structurées, vous permettant ainsi de gagner du temps dans vos opérations.
Grâce à l'IA générative, les logiciels OCR ont fait un bond en avant considérable.
Les méthodes traditionnelles : Machine learning & apprentissage supervisé
L’OCR permet de traiter une image numérique pour en extraire la donnée textuelle, et le cas échéant, enrichies (police, gras, titres, mise en page). Traditionnellement, l’analyse OCR s’appuie sur plusieurs couches de traitement :
- Une pré-analyse de l’image : la définition de l’image est améliorée grâce à des filtres, l’image est redressée et recadrée
- Une segmentation du texte : chaque bloc de texte est localisé sur l’image par rapport aux autres
- La reconnaissance des caractères : chaque caractère est comparé à une bibliothèque de formes pour l’identifier, notamment par des analyses via des réseaux neuronaux
- La reconnaissance des formulaires, des tableaux et des valeurs associées : notamment disponible dans certains OCR facture comme Amazon Textract.
- Le post-traitement : selon des règles statistiques, des erreurs sont éliminées.
Néanmoins, il existe 2 limites à l’apprentissage supervisé :
- Absence de compréhension du langage. La machine ne tient pas compte de la signification des mots qui sont extraits, ce qui pose un problème de qualité de l’extraction. Les documents plus complexes (par exemple, les devis ou les contrats) renvoient des erreurs.
- Gestion des exceptions. L’apprentissage ayant été réalisé sur un nombre limité de documents, il existe souvent des cas rares auxquels l’IA n’a encore pas été confrontée.
La révolution des LLM : précision et personnalisation
L’OCR reposait principalement sur l’apprentissage supervisé : les machines étaient entraînées en étiquetant manuellement les résultats sur les images.
Désormais, avec l’avènement des LLM, on entre dans une nouvelle ère de l’intelligent document processing, basé sur un apprentissage non supervisé.. Cela signifie que les machines apprennent de manière générique, sans nécessiter de labellisation précise. Les résultats obtenus sont nettement meilleurs, avec une précision accrue et une capacité à traiter des documents complexes sans l’intervention humaine intensive requise auparavant.
Le comparatif Computer vision & LLM
Voici un tableau comparatif des différences des performances entre les OCR basé sur la computer vision et les OCR basé sur des LLM.
La technologie de traitement de document Koncile combine le meilleur de la computer vision et des LLM pour obtenir les meilleurs résultats
PDF, JPEG, PNG, document scanné ou pris en photo : quelles différences ?
PDF searchable ou consultable
Votre fichier PDF a été produit par un logiciel, vous pouvez sélectionner le texte dans le document. On parle de PDF “searchable” ou consultable.
Verdict : Dans ce cas, la reconnaissance de caractères ne sera pas nécessaire. Le texte brut existe déjà dans le fichier. En revanche, la “mise en page” doit être captée pour hiérarchiser les informations.
PDF scanné ou numérisé à partir d’un document papier
Le fichier PDF ne contient pas les informations textuelles. Le logiciel d’OCR devra réaliser la reconnaissance de caractères puis la détection de la mise en page. La nature du fichier (PDF, PNG ou JPEG) est généralement indifférente pour le traitement.
Document pris en photo
De même que pour un PDF scanné, les étapes de reconnaissance de caractères et de mise en page seront nécessaires. Attention, il existe un risque d’erreurs plus grand avec
Format électronique ou EDI
S’agissant des factures, les formats types “Facture-X” sont des PDF auquel sont attachés un fichier sous format XML. L’information est alors directement exploitable en base de donnée.
Néanmoins, il est souvent possible que le fichier PDF contienne plus d’informations que le fichier XML, notamment l’information du ligne à ligne des factures.
Document avec écriture manuscrite
La détection de l’existence de signature donne aujourd’hui de très bon résultats. La reconnaissance des caractères de l’OCR écriture manuscrite est assez variable. Les lettres capitales sont bien captées, mais l’écriture cursive peut donner lieu à des erreurs.
Quels documents peuvent être océrisés ?
Pour répondre à cette question, 2 critères doivent être regardés de près
- La variabilité du document : si les documents contiennent toujours les mêmes informations, sous le même format, la captation sera aisé
- La longueur du document : des documents courts sont aisément traitables, la taille du document augmente de confusion entre plusieurs informations
Documents courts contenant des informations relativement standardisées
Documents courts avec des formats variables et des informations répétées
Documents longs composés de plusieurs parties
- Contrats
- Ordonnance & documents médicaux
- Rapport d’expertise
- Documentation douanière
- Documents fiscaux
- Dossier immobilier
Quelles informations peuvent-être captées dans un document ?
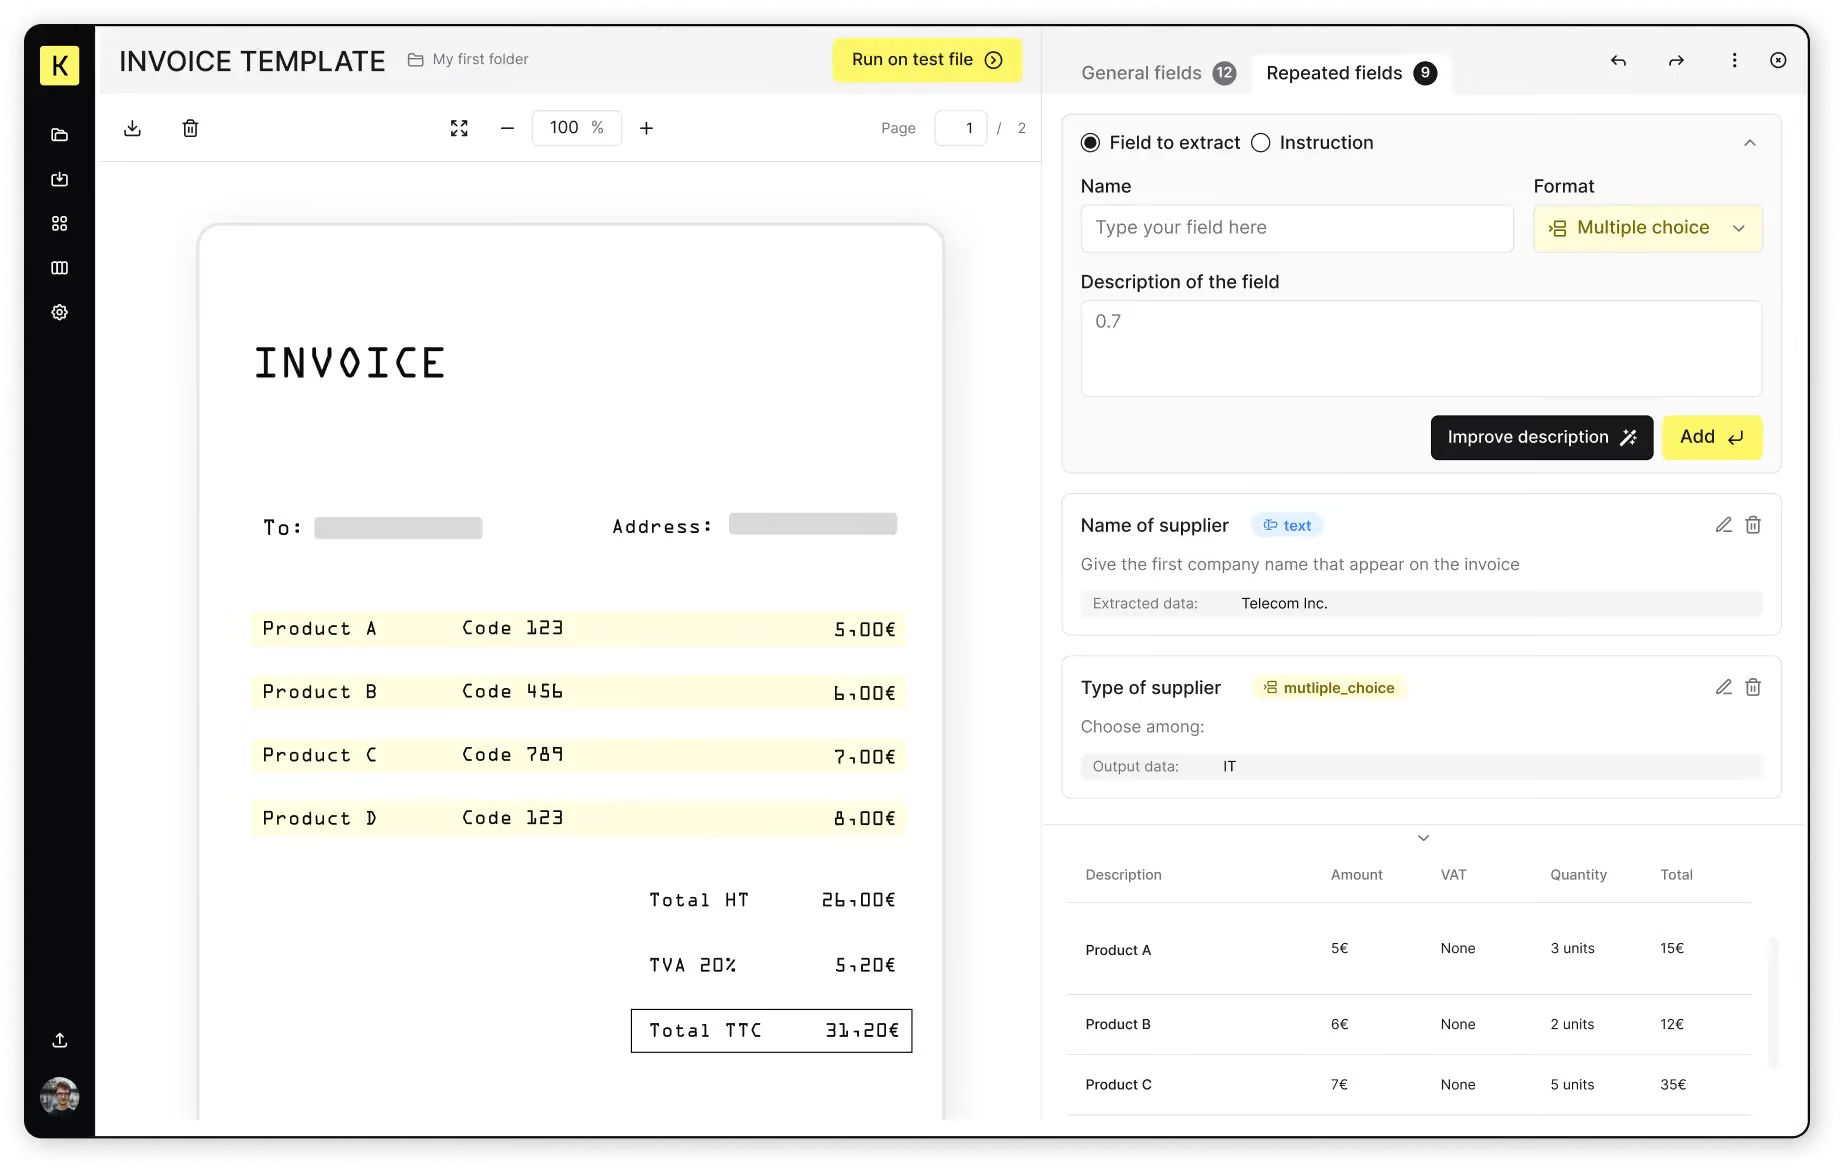
Les OCR proposent une liste standard pour chaque type de documents. Grâce aux LLM, vous pouvez aujourd’hui aller plus loin en définissant vous même les champs qui font sens pour votre cas d’usage. La plateforme Koncile permet de spécifier en no code les champs à extraire. Pour gagner en précision, il peut être utile d’indiquer un exemple de résultat à obtenir.
Testez notre logiciel en démo et comparez les résultats avec les OCR traditionnels.
Quels sont les coûts de l’océrisation ?
Le coût de l’océrisation peut varier entre 1 centime à 20 centimes par page.
Il existe également des librairies gratuites en accès libre pour réaliser l’extraction des caractères. A titre d’exemple, la librairie Tesseract qui est désormais sponsorisée par Google, ou encore la librairie GOCR open-source écrite en C qui fonctionne sous Linux, Windows et macOS.
Quelle est la précision moyenne d’un OCR ?
La précision d’un OCR est variable selon l’éditeur logiciel. Aujourd’hui l’extraction du ligne à ligne reste encore un point difficile.
Découvrez notre comparatif complet des différentes solutions OCR.
Quel est le temps de traitement par un OCR ?
De quelques secondes à 1 minute selon le type d’OCR utilisé. Le temps de traitement dépend de la complexité et la longueur du document et de la résolution de l’image.
Des approches multi-traitement, incluant notamment de la détection de texte, puis des LLM peuvent allonger le temps de traitement, tout en améliorant la précision globale.
Nos retours terrain sur l'automatisation documentaire
OCR par intelligence artificielle vs OCR classique : ce qui change vraiment pour vos documents
Un benchmark a mesuré la précision de Gemini 1.5 Pro sur des documents financiers à environ 50%, tandis que GPT-4o atteint 84% sur du contenu juridique. C'est ce que les discours «passez à l'OCR par intelligence artificielle» laissent de côté. Voici une comparaison factuelle entre OCR classique, IA généraliste et OCR par LLM dédié.
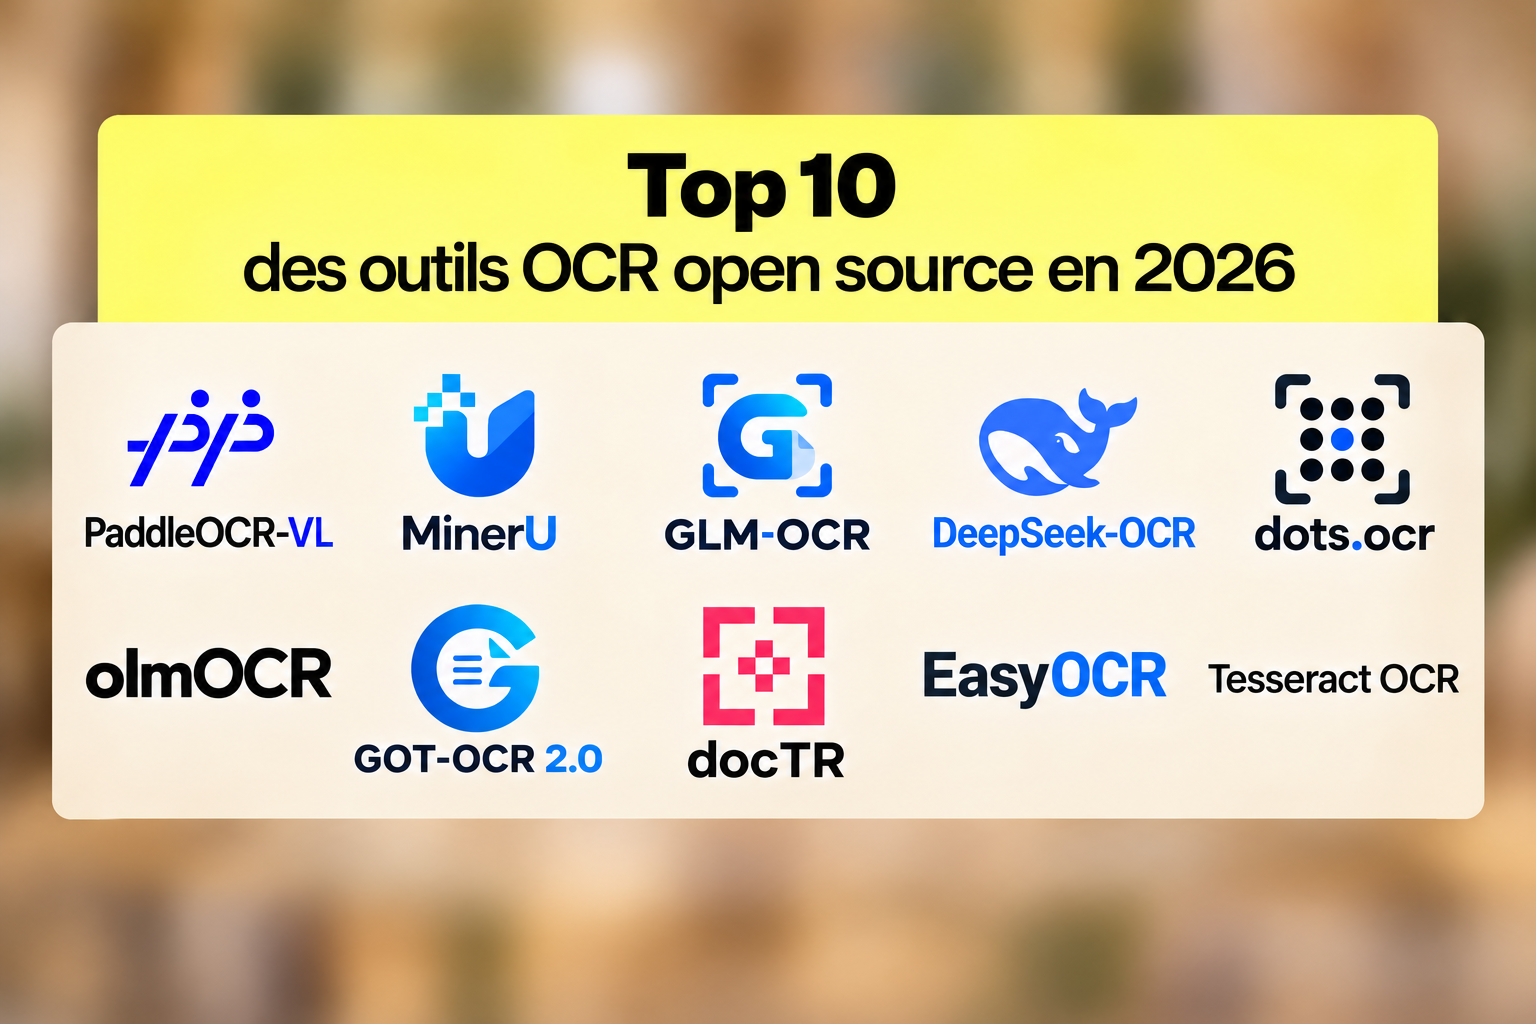
Les 10 meilleurs outils OCR Open Source en 2026
Le classement des OCR open source s'est inversé au cours des dix-huit derniers mois. Un modèle de 0,9 milliard de paramètres lit désormais les documents avec plus de précision qu'un modèle de 235 milliards de paramètres. PaddleOCR-VL obtient un score de 96,34 % sur OmniDocBench v1.6, tandis que Qwen3-VL-235B affiche 89,78 %. Voici les 10 meilleurs moteurs OCR open source en 2026 et comment choisir entre eux.
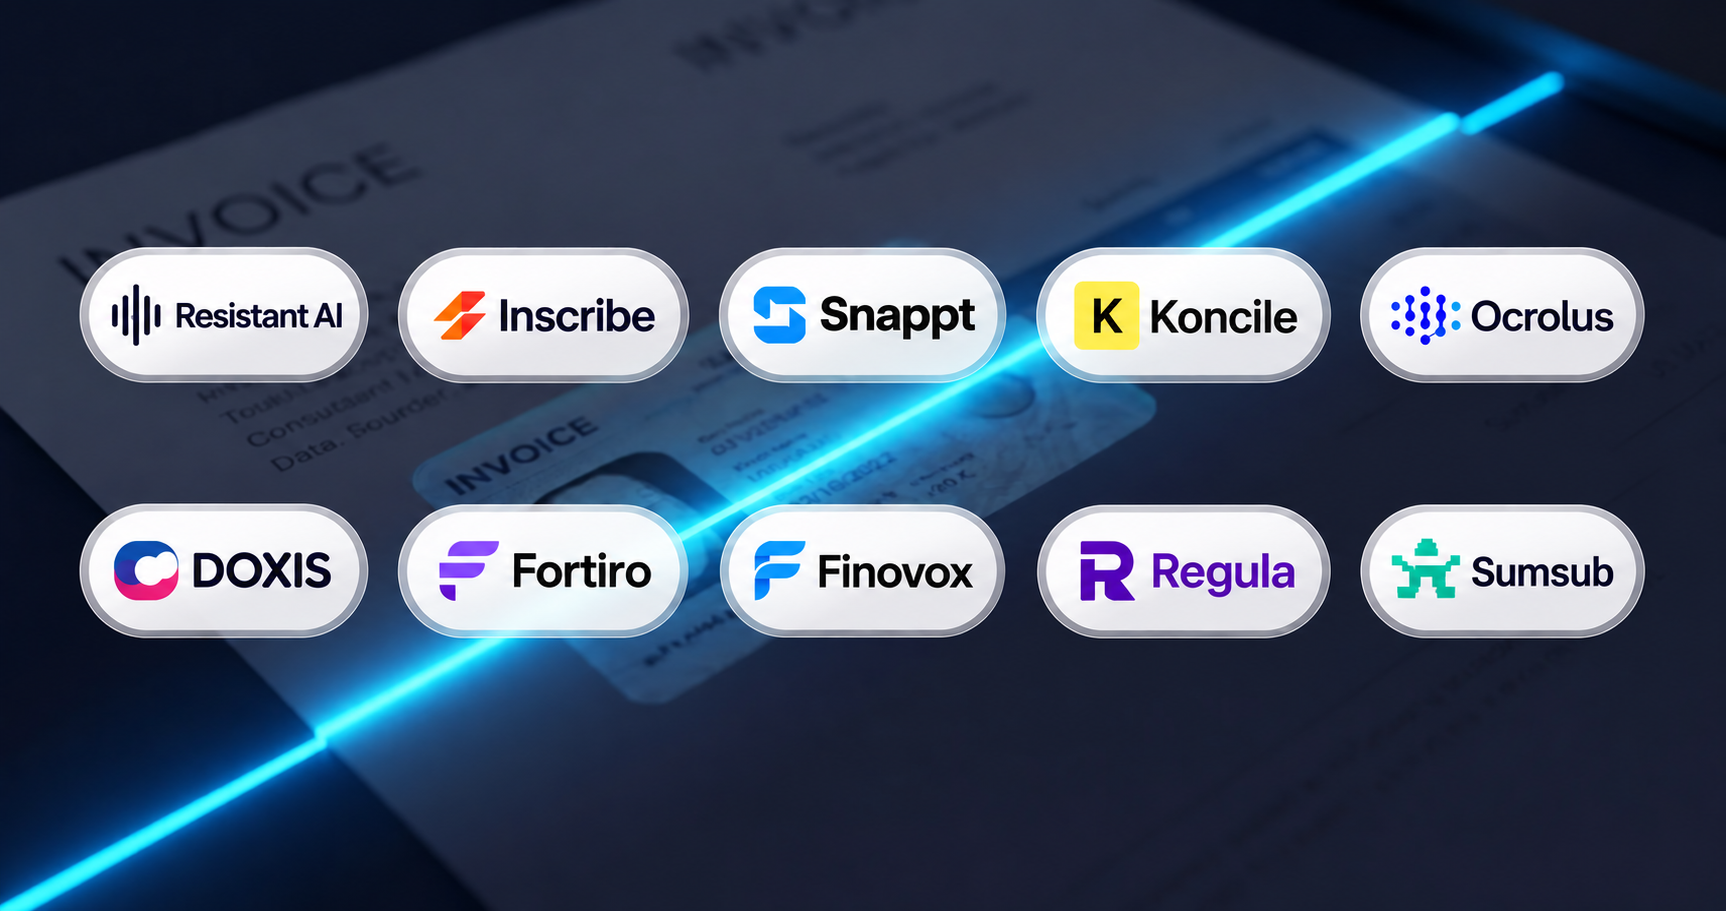
Top 10 des logiciels de détection de fraude documentaire en 2026
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.

Tesseract OCR : toujours le meilleur OCR open source en 2026 ?
Parmi les nombreuses solutions disponibles sur le marché, Tesseract est souvent cité comme l'un des meilleurs logiciels OCR open source. Mais est-il toujours la meilleure solution en 2026 ? Nous analyserons ses performances, avantages, inconvénients et les alternatives OCR open-source.
Des développeurs créent MacDoc, un outil illégal de création de faux passeports
En février 2026, la justice américaine a fermé OnlyFake, un outil de génération de faux documents largement utilisé. Quelques semaines plus tard, un service identique a rouvert sous le nom de MacDoc. Ses faux parviennent à déjouer les contrôles “KYC” de grandes institutions comme Paypal, Airbnb ou Coinbase.