OCR par intelligence artificielle vs OCR classique : ce qui change vraiment pour vos documents
OCR classique, IA de vision généraliste et OCR par LLM dédié comparés sur des données réelles, pas des promesses commerciales.
Un benchmark a mesuré la précision de Gemini 1.5 Pro sur des documents financiers à environ 50%, tandis que GPT-4o atteint 84% sur du contenu juridique. C'est ce que les discours «passez à l'OCR par intelligence artificielle» laissent de côté. Voici une comparaison factuelle entre OCR classique, IA généraliste et OCR par LLM dédié.
L'IA généraliste lit mieux les documents que l'OCR classique, mais pas de façon uniforme : un benchmark a mesuré sa précision à seulement 50 pour cent sur des documents financiers. Voici une comparaison factuelle entre OCR classique, IA de vision généraliste et OCR par intelligence artificielle dédié, et comment migrer sans casser ce qui fonctionne déjà.
Cet écart est précisément ce que la plupart des discours «passez à l'OCR IA» laissent de côté. Les modèles de vision généralistes comprennent réellement mieux un document que l'OCR classique, mais «mieux» n'est pas uniforme, et les documents financiers et de conformité, ceux que la plupart des entreprises cherchent justement à automatiser, ne sont pas là où ces modèles sont les plus performants par défaut.
Ceci n'est pas un argument contre l'OCR IA. C'est un argument pour être précis sur ce que l'on obtient réellement. Il existe trois choses distinctes que l'on regroupe sous l'appellation «OCR IA», et les confondre est exactement là où les migrations échouent. Pour l'explication plus approfondie du mécanisme sous-jacent, la manière dont un LLM comprend le contexte d'un document au lieu de le retranscrire simplement, voir notre article complémentaire sur pourquoi l'OCR par LLM surpasse l'OCR classique Cet article traite du côté pratique : ce qui change, ce qui ne change pas, où se situe réellement le risque, et comment migrer sans casser un flux qui fonctionne déjà suffisamment bien.
Trois choses que l'on appelle «OCR par intelligence artificielle», et ce ne sont pas le même produit

1. L'OCR traditionnel lit des caractères. Tesseract, le moteur d'ABBYY, la plupart des logiciels de numérisation. Il convertit des pixels en texte par reconnaissance de formes face à des caractères connus, puis transmet le texte brut à un script ou à un humain chargé d'en déterminer le sens. Rapide, peu coûteux, fonctionne sur CPU, entièrement déterministe : la même entrée produit toujours la même sortie.
2. Un LLM de vision généraliste est GPT-4o d'OpenAI, Gemini de Google ou Claude d'Anthropic, appelé directement sur une image de document ou un PDF. C'est ce que la plupart des gens entendent par « utiliser ChatGPT pour de l'OCR », et c'est aussi une API OCR au sens le plus large du terme. Il lit le document et le comprend, dans le sens où il peut répondre à « quel est le total de cette facture » plutôt que de simplement retourner chaque caractère qu'il voit. Il n'est pas conçu spécifiquement pour cette tâche, et sa précision varie selon le domaine documentaire d'une manière qu'il est facile de manquer jusqu'à ce qu'on la rencontre.
3. Un pipeline OCR par LLM conçu pour la tâche utilise lui aussi un modèle de langage pour lire et comprendre le document, mais l'enveloppe dans une logique de validation pensée pour cet usage : score de confiance par champ, contrôles de règles métier (ce total est-il vraiment juste), classification avant extraction, et une traçabilité jusqu'à la source. C'est la catégorie dans laquelle se situe Koncile, aux côtés de quelques autres éditeurs conçus spécifiquement pour l'extraction documentaire plutôt que pour la conversation généraliste.
La confusion entre la deuxième et la troisième catégorie est là où se produit la majorité des déceptions. Un modèle généraliste peut extraire un chiffre avec assurance et se tromper, sans que rien dans sa sortie ne signale que ce chiffre mérite une vérification.
Où l'OCR traditionnel reste la bonne réponse
Autant le dire clairement : l'OCR classique n'a pas cessé de fonctionner. Sur un scan propre et net de texte imprimé standard, la précision au caractère près des bons moteurs traditionnels se situe entre 95 et 98 pour cent, et ce sans GPU, sans appel API à un fournisseur de modèle, et sans aucune variance d'une exécution à l'autre. Si vos documents sont véritablement simples et homogènes, l'OCR par modèle est moins coûteux à faire tourner et plus facile à auditer que toute solution basée sur l'IA, précisément parce qu'il fait moins de choses.
La vraie raison pour laquelle les organisations s'en éloignent n'est pas qu'il s'est dégradé. C'est que le volume et la variété des documents ont dépassé ce pour quoi un système à règles avait été conçu, et que le coût de maintenance à poursuivre chaque nouvelle mise en page finit par dépasser le coût de l'outil lui-même.
Où ça casse réellement, et pourquoi l'échec ne se ressemble pas avec l'IA
L'OCR traditionnel et l'extraction par IA ne diffèrent pas seulement en précision. Ils diffèrent dans la manière dont ils échouent, et cette différence compte davantage que le pourcentage affiché.
L'OCR classique échoue bruyamment. Un caractère brouillé, un champ manquant, un tableau aplati en texte linéaire illisible : ces erreurs sont visibles à l'inspection, et c'est exactement pour cela que des décennies de flux documentaires ont construit une revue manuelle autour de leur détection. Les formulaires complexes et les documents multi-structures font chuter les moteurs traditionnels dans une fourchette de 40 à 60 pour cent de précision, et tout le monde en aval sait s'y attendre et vérifier.
L'extraction par IA échoue silencieusement. La recherche comparant les deux le souligne directement : les erreurs d'OCR ont tendance à être évidentes (texte manquant, caractères visiblement faux), tandis que les erreurs de LLM ont tendance à être subtiles, une valeur plausible mais incorrecte qui passe au premier coup d'œil et nécessite une vérification contre le document source pour être repérée. Un modèle qui affirme avec assurance un total faux est un problème plus difficile qu'un modèle qui le brouille visiblement, parce que le premier ne déclenche pas le réflexe humain de double vérification.
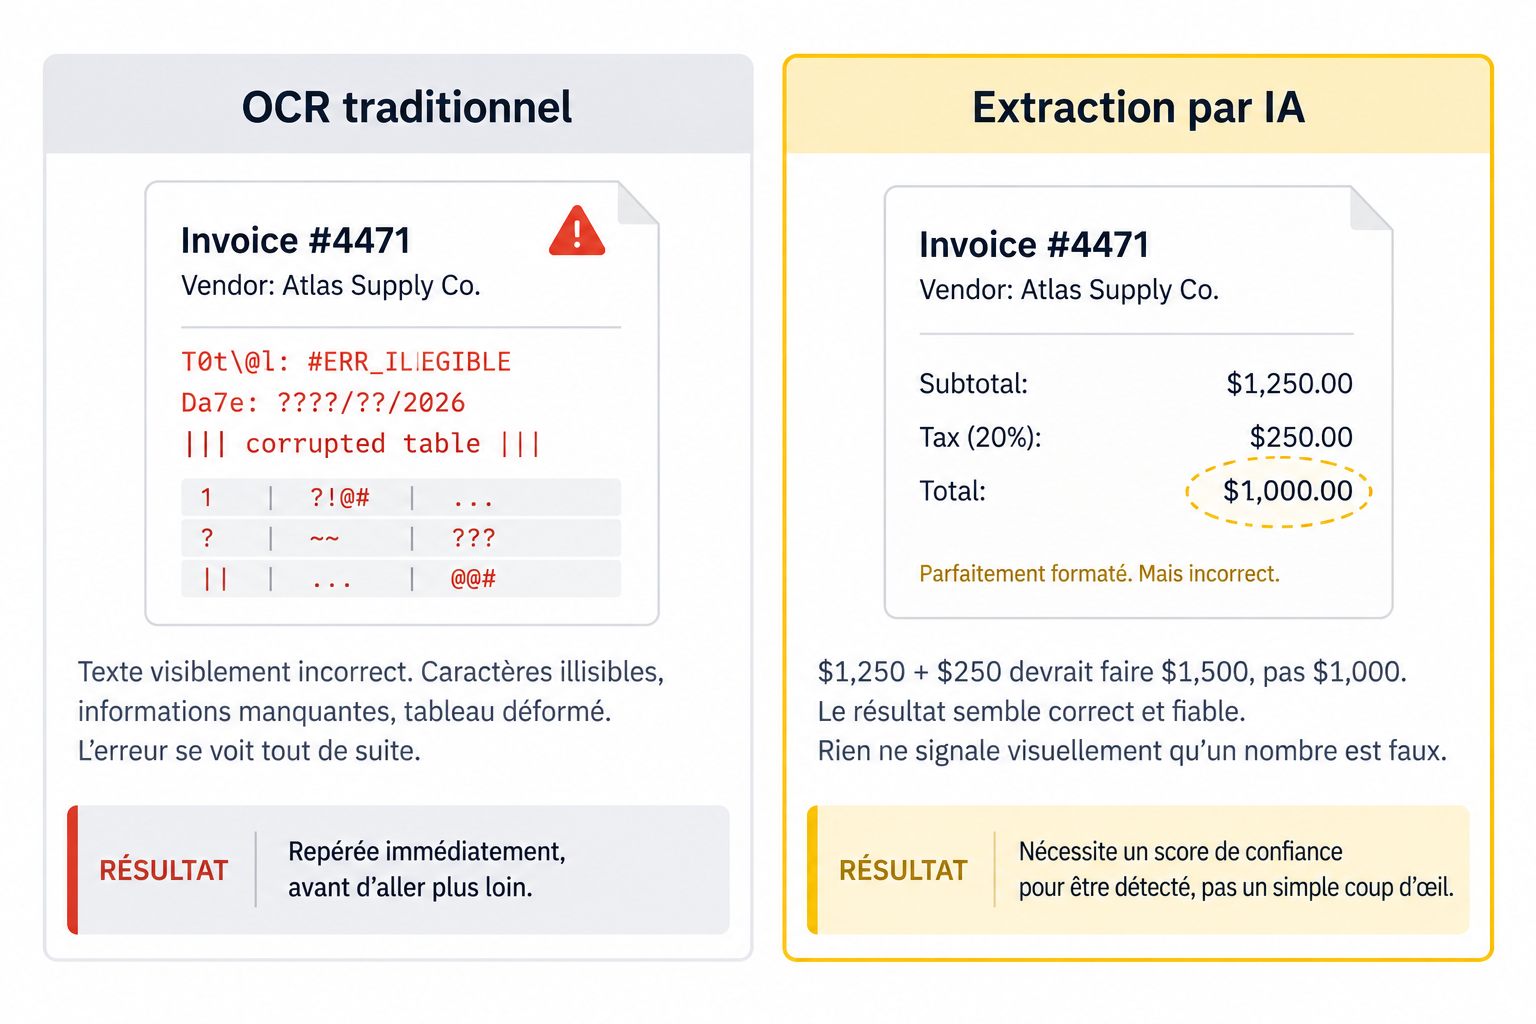
C'est précisément pourquoi le score de confiance compte davantage avec l'extraction par IA qu'il n'a jamais compté avec l'OCR classique. Ce n'est pas une fonctionnalité accessoire. C'est le mécanisme qui transforme un échec silencieux en échec visible.
Le problème des hallucinations, dit sans détour
Même au sein de la génération actuelle de modèles spécialisés dans les documents, l'architecture sous-jacente porte encore un risque. Des analyses techniques récentes des modèles vision-langage de pointe orientés OCR notent que la plupart effectuent encore la détection de mise en page comme une étape séparée avant la reconnaissance, ce qui signifie qu'une erreur dans l'étape de mise en page se propage dans tout ce qui est extrait ensuite, même dans des systèmes conçus spécifiquement pour les documents plutôt que pour la conversation généraliste.
En pratique, cela se traduit par un modèle qui extrait une valeur d'apparence réelle depuis le mauvais endroit de la page, ou qui fusionne deux champs qui auraient dû rester séparés, le tout en renvoyant une sortie parfaitement mise en forme. Rien de tout cela n'est une raison d'éviter l'extraction par IA. C'est une raison d'exiger une logique de validation par-dessus, plutôt que de faire confiance à la sortie du modèle comme on ferait confiance à une calculatrice.
Trois niveaux, comparés directement
Voici le comparatif OCR promis en introduction, presente comme une question de capacité plutôt que d'opinion.
| Critère | OCR traditionnel | IA de vision généraliste | OCR par LLM dédié |
|---|---|---|---|
| Précision, texte imprimé propre | 95-98% | 90-95% | 90-98% |
| Précision, mises en page complexes | 40-60% | 65-75% | Approfondi |
| Gère la variance de mise en page sans nouveau modèle | Non | Oui | Oui |
| Mode d'échec en cas d'erreur | Évident (brouillé, manquant) | Subtil (plausible, silencieux) | Signalé (score de confiance) |
| Score de confiance par champ | Non | Non | Oui |
| Validation par règles métier (totaux, dates) | Non | Non | Oui |
| Classification du document avant extraction | Non | Partielle | Oui |
| Infrastructure | CPU | API hébergée | API hébergée |
| Constance de la sortie, même entrée | Déterministe | Variable | Variable, scoreée |
| Conçu spécifiquement pour l'extraction documentaire | Oui | Non | Oui |
«Approfondi» désigne une capacité intégrée dès la conception de l'architecture, plutôt qu'une capacité générale appliquée aux documents. Les fourchettes de précision proviennent de benchmarks tiers indépendants cités dans la section Sources, pas de chiffres communiqués par les éditeurs, et varient selon le domaine et la qualité documentaire. Les chiffres de la colonne OCR par LLM dédié reflètent l'architecture propre à Koncile et n'ont pas été testés de manière indépendante sur le même corpus que les deux autres colonnes.
Ce qui change réellement, par type de document
1. Relevés bancaires et documents financiers
Tableaux denses, petites polices, relevés multi-pages, et exactement le domaine où les modèles de vision généralistes ont montré la plus grande variance de précision lors de tests indépendants. C'est aussi là où l'écart entre « lire les chiffres » et « vérifier que les chiffres se recoupent » compte le plus : un solde courant qui ne correspond pas à la liste des transactions est un échec de logique métier qu'un pipeline conçu pour la tâche est fait pour attraper, pas quelque chose qu'un modèle généraliste vérifie sauf à l'avoir explicitement prévu. Quiconque évalue l'extraction de relevés bancaires devrait tester ce point précisément avant de s'engager, sur de vrais relevés, pas sur un échantillon propre. Meelo l'a fait sur ses relevés multi-comptes : passer de dix à plus de quatre-vingt-quinze pour cent d'identification correcte des comptes s'est joué dans le paramétrage, pas dans la technologie.
2. OCR facture et OCR comptabilité fournisseurs
Le problème central des comptes fournisseurs a toujours été l'incohérence de mise en page : chaque fournisseur formate sa facture différemment, et l'OCR traditionnel a besoin d'un nouveau modèle à chaque changement. C'est le cas d'usage où l'extraction par IA montre le gain le plus net et le moins contesté, parce que « comprendre qu'il s'agit d'une facture quelle que soit sa mise en page » est proche du problème idéal pour un modèle de langage. La partie difficile reste tout ce qui suit l'extraction : vérifier un total de ligne face au total de la facture, signaler un doublon dans la file de factures du mois dernier, rapprocher avec un bon de commande. La même logique de validation s'applique aux notes de frais, ou l'OCR classique bute sur la meme variete de formats et de tickets de caisse que sur les factures. C'est de la logique de validation, pas de l'extraction, et c'est là où un appel à un modèle généraliste s'arrête et où un pipeline conçu pour la tâche continue.
3. Formulaires et écriture manuscrite
L'écriture manuscrite est le cas où l'amélioration est la plus nette et encore incomplète. Les modèles vision-langage traitent l'écriture manuscrite lisible nettement mieux que l'OCR classique, en grande partie parce qu'ils peuvent déduire un caractère ambigu à partir du contexte environnant, comme le ferait un lecteur humain. L'écriture cursive et les formulaires mélangeant champs imprimés et manuscrits sur la même page restent véritablement difficiles pour toutes les options du marché, basées sur l'IA ou non. Traitez les affirmations de précision sur l'écriture manuscrite avec plus de scepticisme que toute autre catégorie, et testez sur vos pires échantillons réels avant de faire confiance à un chiffre de fiche produit.
4. Documents d'identité et KYC
Les documents d'identité, justificatifs de domicile et dossiers d'onboarding varient par pays et par format d'une manière qui pénalise spécifiquement les modèles rigides. L'extraction par IA gère bien cette variance de format. L'exigence la plus difficile dans cette catégorie n'est généralement pas la précision d'extraction, c'est de vérifier que le document lui-même n'a pas été altéré, ce qui est un problème différent de bien le lire, et qui mérite d'être confirmé auprès de tout éditeur plutôt que supposé inclus avec une bonne extraction. Sur un dossier de souscription auto, la cohérence entre les pièces compte autant que chaque pièce : c'est ce que Toyota Assurances contrôle sur ses neuf documents par dossier.
Migrer hors de l'OCR historique sans casser ce qui fonctionne déjà
Le chemin réaliste est parallèle, pas une bascule brutale. Choisissez un flux à fort volume, faites tourner la nouvelle solution OCR aux côtés de l'existante sans rien retirer, et définissez ce que vous mesurez et comparez réellement avant de commencer : précision d'extraction face à un échantillon vérifié manuellement, délai entre réception du document et donnée exploitable, et taux de revue manuelle. Sans ces chiffres actés à l'avance, « le nouveau système semble plus rapide » devient la seule preuve disponible, et ce n'est pas une preuve.
Laissez cette phase parallèle durer assez longtemps pour couvrir votre variété documentaire réelle, pas seulement un lot pilote propre, puisque tout l'argument du changement repose sur la manière dont le système gère les cas limites qui cassent l'OCR par modèle en premier lieu. Étendez par type de document une fois les chiffres confirmés, pas par équipe ou par géographie, puisque la précision sur les factures ne dit presque rien sur la précision sur les documents d'identité. Retirez le composant historique en dernier, une fois que son remplacant a fait ses preuves sur le volume et la variété exacts qu'il remplace, pas avant.
La place de Koncile dans tout ça
Koncile est conçu comme la troisième catégorie décrite plus haut : un pipeline d'extraction par LLM avec une validation intégrée autour, pas un modèle généraliste appelé directement sur un document. Les documents sont classifiés avant extraction, de sorte que le système sait qu'il regarde une facture ou un relevé bancaire avant de commencer à en extraire les champs. Chaque valeur extraite porte un score de confiance et une citation vers son emplacement dans le document source, de sorte qu'un champ à faible confiance est visible comme tel plutôt que présenté avec la même certitude que le reste. Une validation par règles métier s'applique par-dessus, la même logique que celle derrière le contrôle automatisé des factures : les totaux sont recalculés, les relations entre champs sont vérifiées, et les incohérences sont signalées plutôt qu'acceptées silencieusement.
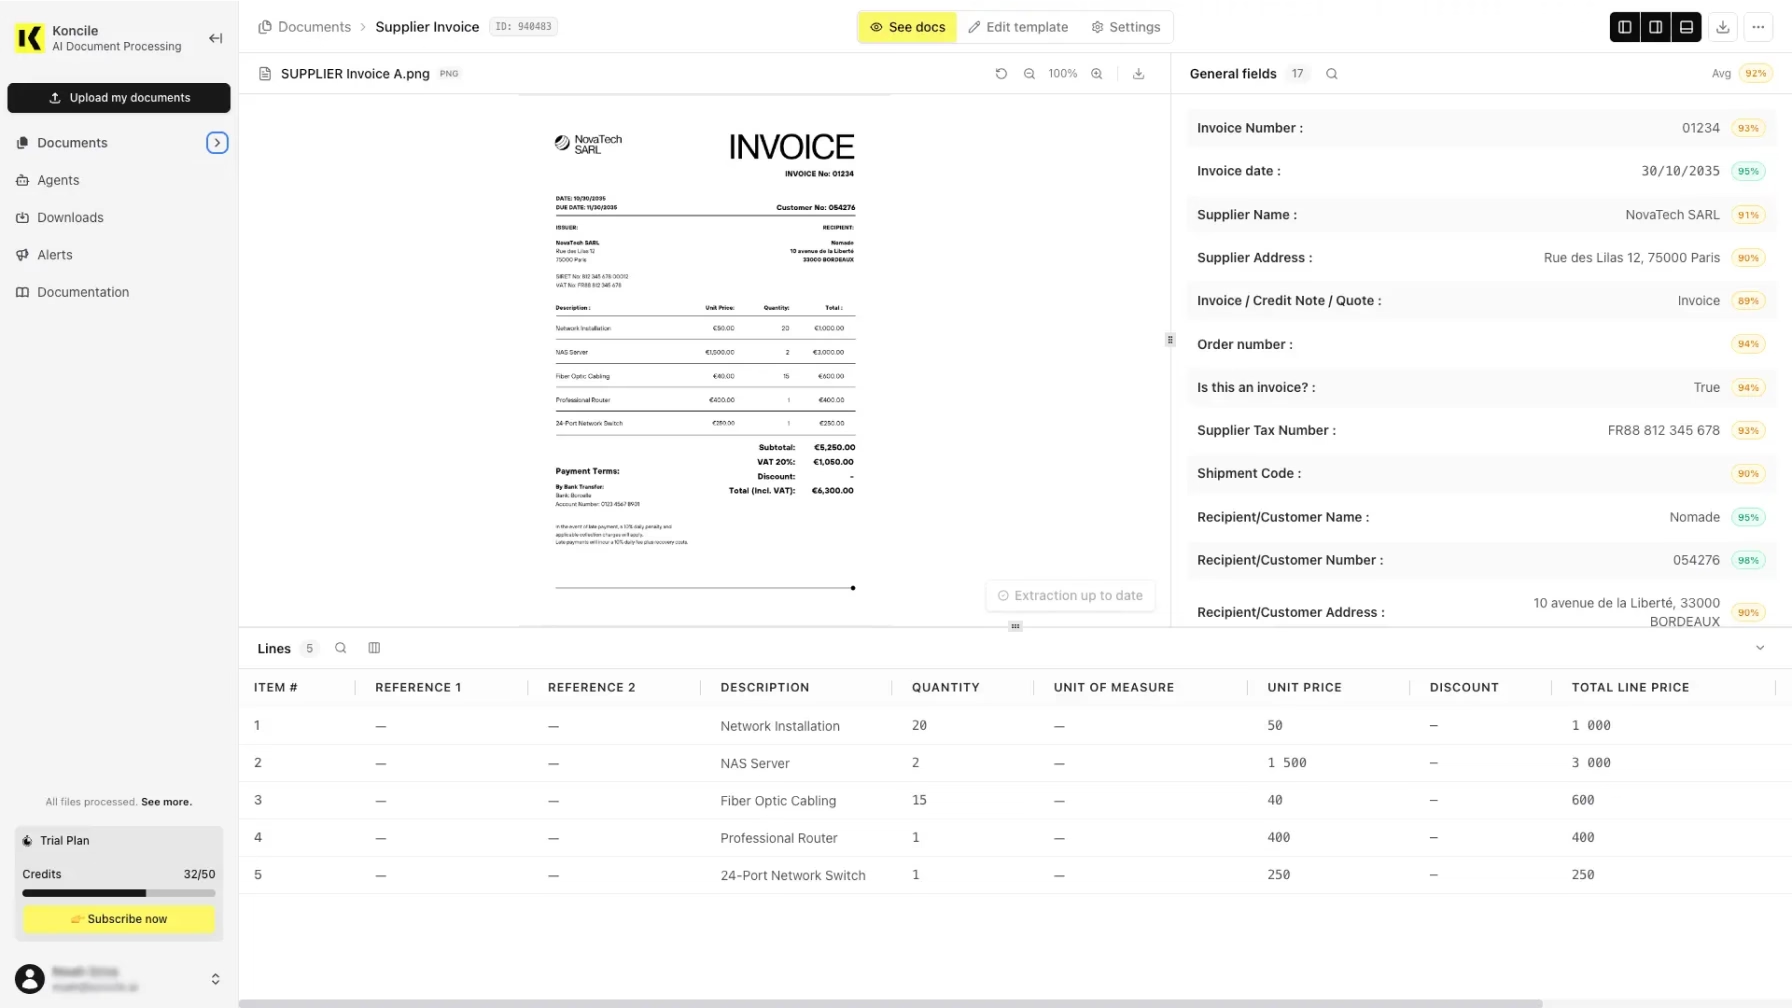
Cela couvre les factures, relevés bancaires, documents d'identité, dossiers KYC, documents logistiques, et contrats, via une plateforme no-code ou une API REST, sans modèles prédéfinis et sans le coût de reconfiguration qui rendait l'OCR historique coûteux à maintenir en premier lieu. Cela ne supprime pas le besoin de valider la sortie d'un nouvel éditeur face à vos propres documents avant de lui faire confiance en production. Rien dans cette catégorie ne mérite cette confiance par défaut, y compris Koncile.
Vers où cela se dirige
Le traitement OCR ne s'arrete plus a la simple lecture de caracteres. La raison pour laquelle ce changement compte au-delà de la simple précision, c'est ce que devient possible une fois qu'un système comprend un document au lieu de le retranscrire simplement : vérifier une clause spécifique dans un contrat à travers tout un portefeuille, signaler automatiquement chaque facture au-dessus d'un seuil, attraper une incohérence numérique avant qu'elle n'atteigne la comptabilité plutôt qu'après. Lire le texte a toujours été la première étape. Raisonner sur ce que le texte signifie, et attraper ce qui ne colle pas, est la partie que le traitement intelligent des documents change réellement dans le fonctionnement d'un back-office.
Vos questions sur l'OCR IA face à l'OCR traditionnel
Utiliser ChatGPT ou Gemini sur un PDF, est-ce la même chose que l'OCR IA ?
C'est une version de l'OCR IA, et celle avec le moins de validation intégrée. Les modèles de vision généralistes lisent et comprennent les documents nettement mieux que l'OCR classique, mais leur précision varie selon le domaine documentaire, et ils n'ont pas été conçus avec un score de confiance, une validation par règles métier ou une classification documentaire pensée spécifiquement pour des flux d'extraction. Pour un document isolé, c'est un outil raisonnable. Pour un flux de production traitant des centaines de documents par jour, l'absence de validation intégrée est exactement là où les problèmes finissent par apparaître.
L'OCR IA hallucine-t-il ?
Oui, et le mode de défaillance est précisément qu'il peut extraire une valeur assurée, plausible et fausse sans aucun signe visible que quelque chose s'est mal passé. C'est une différence documentée avec l'OCR classique, dont les erreurs ont tendance à être évidentes plutôt que subtiles. Le score de confiance et la validation par règles métier sont les mécanismes qui attrapent cela avant que l'information n'atteigne un système en aval.
L'OCR IA est-il vraiment plus précis que l'OCR traditionnel ?
Sur du texte imprimé propre et standard, l'écart est réel mais pas spectaculaire : un bon OCR traditionnel atteint 95 à 98 pour cent, l'extraction par IA est comparable ou légèrement supérieure. Sur des formulaires complexes et des documents multi-structures, l'OCR traditionnel chute à environ 40 à 60 pour cent tandis que les approches par IA tiennent nettement mieux, couramment citées entre 65 et 75 pour cent et davantage pour les systèmes conçus spécifiquement pour la tâche. L'écart se creuse précisément quand la complexité documentaire augmente, ce qui correspond aussi exactement à l'endroit où les coûts de maintenance de l'OCR historique sont les plus élevés.
Puis-je faire tourner l'OCR IA et mon système OCR existant en même temps ?
Oui, et c'est le chemin de migration recommandé plutôt qu'une bascule complète. Faire tourner les deux en parallèle sur le même volume documentaire permet de comparer la précision d'extraction et les taux de revue manuelle sur des données réelles avant de retirer quoi que ce soit, ce qui élimine l'essentiel du risque qui rend les migrations dangereuses en apparence.
L'OCR IA nécessite-t-il un GPU ?
Si vous hébergez vous-même un modèle vision-langage open source, oui, généralement. Si vous utilisez une API hébergée, qu'il s'agisse d'un fournisseur de modèle généraliste ou d'une API OCR conçue pour la tâche, l'infrastructure devient le problème du fournisseur plutôt que le vôtre. C'est l'un des facteurs de coût les plus souvent négligés quand une équipe compare auto-hébergement et solution hébergée.
Quelle est la différence entre l'OCR IA et le traitement intelligent des documents ?
L'OCR IA désigne spécifiquement la couche d'extraction : lire et comprendre un document. Le traitement intelligent des documents est la catégorie plus large qui inclut ce qui se passe après l'extraction : classification, validation, routage et intégration dans les systèmes métier. L'OCR IA est généralement le composant qui rend l'IDP moderne possible, pas un terme qui le remplace.
L'OCR IA vaut-il le coût pour un faible volume de documents ?
Rarement sur le seul critère du coût. L'argument en faveur de l'extraction par IA se renforce avec la variété et le volume documentaires, puisque c'est précisément ce qui met en échec les systèmes basés sur des modèles et génère leur coût de maintenance caché. Un volume faible et stable de documents au format homogène est exactement le cas où l'OCR traditionnel reste le choix le moins cher, le plus simple et parfaitement raisonnable.
Pourquoi la précision varie-t-elle autant entre différents modèles d'IA sur le même type de document ?
Parce que les modèles vision-langage généralistes sont entraînés sur un large mélange de contenus, pas spécialisés pour les documents financiers ou métier en particulier, et cela se traduit par une véritable variance de performance selon le domaine. C'est une raison précise et documentée de tester tout modèle, conçu spécifiquement pour la tâche ou généraliste, sur vos propres types de documents avant de faire confiance à un score de benchmark mesuré sur les documents de quelqu'un d'autre.
Sources
- Vellum AI, Document Data Extraction in 2026: LLMs vs OCRs. Comparaison des modes d'échec entre OCR et LLM, et recherche Omni AI sur la précision d'extraction de bout en bout.
- Firstsource, Vision Language Model (VLM)-Based Information Extraction. Fourchettes de précision entre OCR traditionnel et extraction GenAI selon la complexité documentaire et l'écriture manuscrite.
- Benchmarking Vision-Language Models on Optical Character Recognition in Dynamic Video Environments, arXiv 2502.06445. Variance de précision par domaine entre GPT-4o, Gemini 1.5 Pro et les moteurs OCR traditionnels.
- HunyuanOCR Technical Report, arXiv 2511.19575. Propagation d'erreurs de détection de mise en page dans les modèles vision-langage orientés OCR de dernière génération.
- Koncile, Why LLM OCRs Are the Future of Intelligent Document Processing. Article complémentaire sur le mécanisme sous-jacent de l'extraction sensible au contexte.
Nos retours terrain sur l'automatisation documentaire
Les 5 meilleures solutions OCR françaises pour extraire les données de vos documents
Cinq solutions OCR françaises permettent aujourd'hui d'extraire automatiquement les données de vos factures, contrats et documents comptables grâce à la reconnaissance optique de caractères, avec un hébergement localisé en France. On les présente ici.
Traitement de documents et détection de fraude : construire ou acheter ?
Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.
Dans la santé, un OCR se juge sur ce qu’il signale, pas sur ce qu’il lit
Tous les éditeurs d’OCR annoncent des taux de précision élevés, et la plupart les tiennent. Sur un document de santé, ce n’est pas le bon critère d’achat. Ce qui compte, c’est ce que l’outil fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule.

Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques
Amazon Textract est formellement éligible HIPAA depuis octobre 2019. La plupart des comparatifs OCR santé ne le vérifient jamais pour les autres outils de leur liste. Voici une reconstruction qui vérifie le statut de conformité directement, et qui regarde ce que les vrais essais cliniques sur les scribes IA ambiants ont trouvé, pas seulement le marketing.
Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026
Un freelance qui envoie une douzaine de factures par mois peut dépasser le plafond du forfait le moins cher de Xero dès la troisième semaine, et FreshBooks plafonne à cinq clients. Le chiffre affiché sur une page tarifaire est rarement celui que vous payez réellement. Voici une comparaison honnête de QuickBooks, Xero, Wave et FreshBooks, pensée pour une entreprise d'une seule personne.