Top 10 des logiciels de détection de fraude documentaire en 2026
Dix plateformes comparées aux cinq points de rupture réels des documents falsifiés, et non aux promesses marketing des éditeurs.
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.
Pour 8,99 $, un site nommé PaystubHero vous vend une fiche de paie présentée comme « approuvée par Snappt ». La page s'intitule « Comment contourner Snappt en 2026 » et elle se classe en première page de Google pour cette requête.
Snappt est l'un des plus grands éditeurs de détection de fraude documentaire en Amérique du Nord. Il a analysé plus de 14 millions de documents et revendique une précision de 99,8 %. Une petite industrie s'est désormais constituée pour concevoir des produits destinés spécifiquement à le déjouer, ainsi que ses concurrents, et ces produits se vendent ouvertement sur le web indexé plutôt que sur un forum du darknet.
C'est l'état du marché cette année. Les éditeurs de détection publient des chiffres de précision. Les services de fraude documentaire publient des méthodes pour contourner ces mêmes éditeurs. Aucune de ces deux séries d'affirmations n'a jamais été testée de manière indépendante.
Ce comparatif adopte donc une approche différente. Plus tôt cette année, nous avons enquêté sur MacDoc, un générateur de faux passeports relancé après la fermeture de son prédécesseur par la justice fédérale américaine. Démonter ce moteur nous a permis de comprendre précisément comment un faux document moderne est fabriqué, et surtout, exactement où il finit par se briser. Nous utilisons ici ces cinq points de rupture comme critères d'évaluation, car une plateforme de détection ne vaut que ce qu'elle parvient à intercepter face à une attaque réelle.
Les 10 plateformes comparées
Chaque plateforme est notée sur les cinq points que les outils de détection ratent le plus souvent. Ces cinq points sont expliqués dans la section ci-dessous, et chaque éditeur est ensuite présenté en détail.
| Plateforme | Retouches partielles par IA | Analyse du fichier brut | Données de référence émetteurs | Contrôles inter-documents | Vérification 2D-DOC |
|---|---|---|---|---|---|
| Koncile | Oui | Avancé | Avancé (mis à jour quotidiennement) | Avancé | Oui |
| Resistant AI | Partiel | Avancé | Oui | Limité | Non |
| Inscribe | Partiel | Oui | Oui | Avancé | Non |
| Snappt | Partiel | Oui | Avancé (+2 000 institutions) | Oui | Non |
| Ocrolus | Limité | Partiel | Oui | Oui | Non |
| Doxis AI.dp | Partiel | Oui | Limité | Limité | Non |
| Fortiro | Partiel | Oui | Oui | Oui | Non |
| Finovox | Partiel | Oui | Oui | Oui | Oui |
| Regula | Limité | Oui | Avancé (bibliothèque de modèles) | Non | Oui |
| Sumsub | Limité | Partiel | Limité | Limité | Partiel |
Sources : documentations éditeurs et pages produits publiques, consultées en septembre 2026. Koncile (ligne mise en évidence) est la seule plateforme de ce tableau à couvrir l'ensemble des cinq contrôles en une seule passe. Aucun benchmark indépendant multi-éditeurs n'existe sur ce marché, chaque fonctionnalité annoncée provient donc directement de l'éditeur concerné.
Une remarque sur les chiffres de précision que vous allez lire
Chaque chiffre de ce marché est autodéclaré. Snappt annonce 99,8 %. Resistant AI publie 99,2 % sur son propre site et 99,92 % sur sa fiche AWS Marketplace. Ocrolus indique un taux de vrais positifs supérieur à 90 %. Koncile ne publie aucun chiffre de précision phare, pour la raison exposée ci-après.
Aucun benchmark indépendant n'existe entre ces éditeurs. Personne n'a fait passer un corpus commun de faux documents connus à travers chacun d'eux et publié les résultats. Tant que ce ne sera pas fait, considérez chaque pourcentage de cette page, y compris ceux qui nous concernent, comme une affirmation marketing plutôt qu'une mesure. Demandez à tout éditeur présélectionné de traiter vos propres documents dans le cadre d'un test (proof of concept), et accordez plus de poids à ce que vous observez qu'à ce qu'il publie.
L'ordre ci-dessous reflète le degré de spécialisation en détection de fraude documentaire, des spécialistes forensiques et sémantiques jusqu'aux plateformes où la détection de fraude n'est qu'un module d'un produit plus large. Ce n'est pas un classement universel. La dernière section indique quelle plateforme convient à quelle situation, et pour plusieurs cas d'usage courants, la réponse n'est pas la plateforme en tête de liste.
Koncile, une détection en trois couches fondée sur des contrôles propres à chaque document
Sa détection de fraude documentaire s'organise en trois couches, avec plus de 150 tests individuels appliqués à chaque document.
L'analyse forensique vient en premier. Plusieurs couches de modèles de ML tournent en parallèle, chacune entraînée sur une classe différente de manipulation, car aucun détecteur unique ne couvre l'ensemble des façons dont un document peut être altéré. Un modèle cible l'usage du tampon de duplication dans des outils comme Photoshop. Un autre cible les empreintes d'IA insérées dans des documents par ailleurs authentiques, comme une petite image fabriquée déposée sur un vrai reçu. D'autres traitent les modifications post-capture, les artefacts de réenregistrement et la reconstruction des calques.
L'analyse des métadonnées et du fichier brut vient en deuxième position, et elle va bien au-delà de la surface. Les fraudeurs négligents laissent des traces évidentes, comme une chaîne « producer » Canva sur un relevé bancaire. Les plus prudents les suppriment. Mais toute modification d'un PDF laisse quelque chose dans la structure brute du fichier, et dans certains cas, les valeurs d'origine restent récupérables, révélant exactement quel champ a été modifié. En parallèle fonctionne une base de référence des caractéristiques de métadonnées attendues par type de document et par émetteur, y compris par banque individuelle, mise à jour quotidiennement. Un relevé dont la structure de fichier s'écarte trop de ce que cette banque produit réellement est signalé, même si rien ne semble anormal à l'écran.
Les contrôles de contexte et de règles métier viennent en troisième position, et ils sont délibérément spécifiques à chaque type de document plutôt que génériques. Leur valeur réside dans le fait d'encoder ce qu'un type de document donné doit contenir : recalcul des totaux et des taux de TVA, validation des identifiants selon des formats connus, vérification des règles réglementaires propres à cette catégorie de document. La vérification auprès de bases de données tierces s'effectue lorsqu'une source appropriée existe. Les documents porteurs d'un 2D-DOC, y compris les documents d'identité européens et certaines factures, sont vérifiés par rapport à la clé publique de l'autorité émettrice.
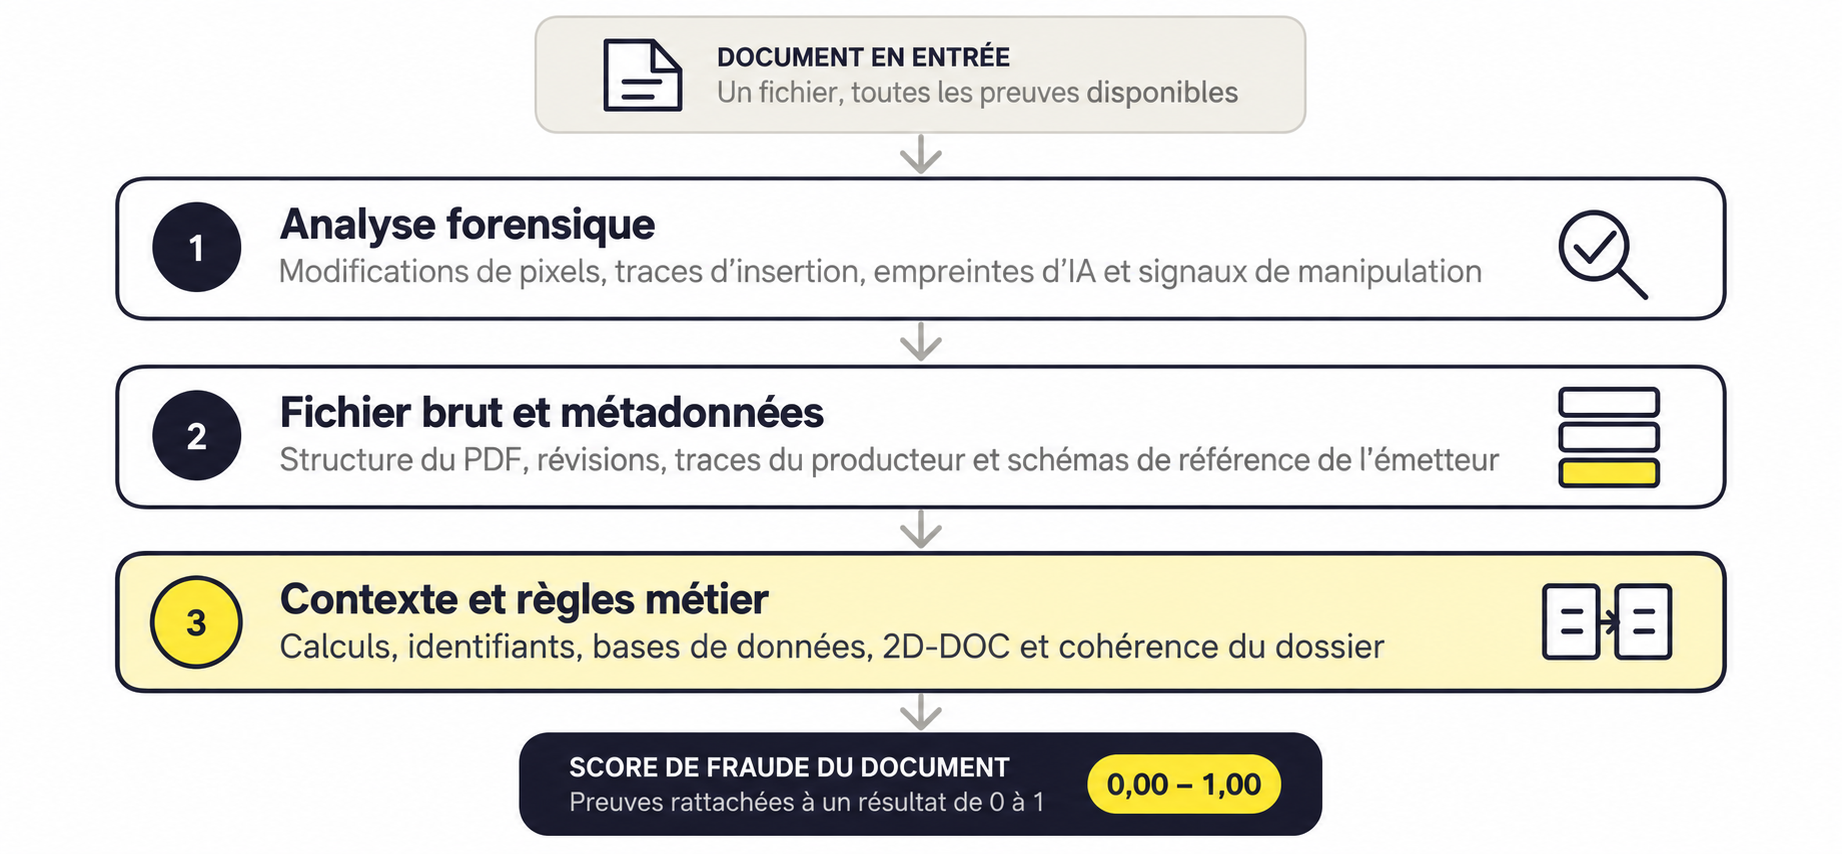
Les familles de documents couvertes en profondeur sont les relevés bancaires, les documents d'assurance, les fiches de paie, les factures, les documents d'identité, les documents de demande de prêt et les documents KYB des entreprises. Chaque document renvoie un score de risque compris entre 0 et 1, et l'extraction ainsi que le contrôle de fraude s'effectuent en une seule passe plutôt qu'à travers deux intégrations distinctes.
Le traitement s'exécute sur une infrastructure certifiée ISO 27001, avec conformité SOC 2, RGPD et HDS, et hébergement dans l'UE disponible. L'intégration couvre une plateforme no-code, une API REST vers les ERP, SIRH et processus de crédit, ainsi que Zapier, n8n et Power Automate. Il n'existe pas de couche biométrique d'identité, les parcours d'onboarding grand public devront donc s'appuyer sur un outil distinct pour la détection de vivacité et la vérification faciale.
Idéal pour : les équipes finance, risque et achats, là où la fraude se niche dans les chiffres plutôt que dans les pixels.
Resistant AI, la détection forensique à grande échelle
Resistant AI a levé 25 millions de dollars en série B en octobre 2025, avec le soutien d'Experian et de GV, ce qui constitue la plus importante levée de fonds récente dans cette catégorie spécifique et un signal raisonnable de la direction que prend la détection forensique.
Fondée en Tchéquie, la plateforme examine chaque document selon plus de 500 critères portant sur le contenu et la mise en page, la qualité de création, les signaux d'insertion et de manipulation, ainsi que l'empreinte de l'appareil, avant de rendre un verdict Fiable, Avertissement ou Risque élevé. Elle s'est étendue à des détecteurs d'IA générative spécifiquement dédiés à la fraude générée par IA.
Au regard des cinq critères, elle excelle sur les traces de métadonnées, les artefacts de calques et l'analyse de police, soit la pile forensique classique poussée à une profondeur inhabituelle. Elle est plus légère sur la vérification des règles métier, car elle évalue le document plutôt que le dossier qui l'entoure. L'intégration s'effectue via une API en temps réel, avec des connecteurs bâtis sur Google Cloud Document AI et ABBYY Vantage.
Idéal pour : les prêteurs, banques et assureurs confrontés à un volume élevé de détection de fraude documentaire, là où l'étendue forensique compte plus que la logique métier propre à un secteur.
Inscribe, la détection de fraude documentaire agentique pour les services financiers
Inscribe affirme avoir créé cette catégorie en 2017, et que cela se vérifie ou non, l'éditeur affiche le plus long historique continu parmi les acteurs « fraude d'abord » de cette liste.
Entre 2024 et 2025, l'éditeur est passé à un modèle agentique : des agents IA qui lisent la mise en forme, la structure, les métadonnées et les indices contextuels d'un document, puis recoupent les informations à travers tous les documents d'un même dossier. Ce raisonnement inter-documents est l'aspect le plus intéressant, car il s'attaque au problème de cohérence plutôt qu'au problème des pixels. Un faussaire peut fabriquer une fiche de paie parfaite. En fabriquer trois qui concordent entre elles et avec un relevé bancaire est bien plus difficile.
L'éditeur a ajouté en 2025 un détecteur dédié aux documents générés par IA.
Idéal pour : les équipes risque et souscription nord-américaines dans la banque, le crédit et la fintech. Approche API-first, tarification sur devis, conformité SOC 2 et ISO 27001.
Snappt, la détection de fraude documentaire pour les dossiers de location
Aucun acteur de ce marché n'a de preuve de position plus claire que Snappt, et elle vient d'une source inhabituelle : c'est l'éditeur que les services de fraude documentaire citent nommément dans leurs publicités.
Fondé en 2019 et concentré presque exclusivement sur la gestion des biens résidentiels collectifs (multifamily) aux États-Unis, Snappt examine plus de 10 000 propriétés de données par document, en les comparant à un référentiel constitué à partir de plus de 2 000 établissements financiers. L'éditeur déclare avoir analysé 14 millions de documents et évité 1,9 milliard de dollars de créances douteuses. Une équipe dédiée, Fraud Forensics, met à jour en continu les modèles de détection, ce qui compte davantage que n'importe quel chiffre de précision figé.
Sa contrepartie est son étroitesse. Snappt est conçu pour les fiches de paie et les relevés bancaires dans un processus de location. Pointez-le vers une facture fournisseur ou une déclaration en douane, et ce n'est plus le bon outil. La vérification d'identité passe par un partenariat avec CLEAR plutôt qu'en interne, couvrant plus de 30 contrôles sur plus de 4 600 types de pièces d'identité.
Idéal pour : les gestionnaires immobiliers et équipes de location dans l'immobilier résidentiel collectif américain. Si vous n'êtes pas dans ce secteur, regardez ailleurs.
Ocrolus, une extraction OCR d'abord dotée d'une couche antifraude
Ocrolus aborde la détection de fraude par l'angle opposé à tous les autres acteurs de cette liste, ce qui façonne à la fois ses forces et ses lacunes.
L'entreprise a bâti sa réputation sur la capture de documents et la précision de l'OCR pour les services financiers, en particulier l'analyse de relevés bancaires à grande échelle, avant d'y ajouter Ocrolus Detect. La qualité d'extraction est réellement solide, et si votre principale difficulté consiste à transformer des scans mal formatés en données propres, le contrôle de fraude n'étant qu'une exigence secondaire, cet ordre de priorités peut vous convenir.
La couche antifraude est plus légère que chez les plateformes « fraude d'abord ». L'éditeur annonce un taux de vrais positifs supérieur à 90 %, une affirmation nettement plus modeste que les chiffres supérieurs à 99 % avancés ailleurs sur cette page, et sans doute plus honnête. Il s'agit d'une plateforme OCR à laquelle des contrôles de fraude ont été ajoutés, plutôt que d'une plateforme antifraude partant du grand livre comptable.
Idéal pour : les prêteurs et fintechs à fort volume d'OCR de relevés bancaires qui recherchent l'extraction et le contrôle antifraude chez un même fournisseur.
Klippa DocHorizon (désormais Doxis AI.dp), le traitement documentaire et le contrôle antifraude sur une seule plateforme
Ce changement de nom compte pour quiconque effectue une recherche : Klippa DocHorizon fait désormais partie du groupe SER et opère sous le nom de Doxis AI.dp. Les comparatifs plus anciens le listent encore sous son ancien nom.
Le produit associe le traitement intelligent de documents à un module antifraude, combinant une analyse forensique d'image multicouche pour détecter le copier-coller, le montage et les traces Photoshop, une analyse forensique des métadonnées EXIF, et une détection de contenu deepfake généré par IA. Il rend un verdict en moins de cinq secondes par document.
Son atout est la consolidation. Disposer de l'OCR, de l'analyse de fraude et de la vérification sur une seule plateforme certifiée ISO 27001 et hébergée exclusivement dans l'UE simplifie l'achat par rapport à l'assemblage de trois fournisseurs distincts, et les connecteurs ERP préconstruits réduisent significativement le travail d'intégration.
Idéal pour : les entreprises qui souhaitent le traitement documentaire et le contrôle antifraude au sein d'un même processus et d'un même contrat.
Fortiro, la fraude documentaire financière pour le crédit et l'onboarding
Fortiro est l'un des acteurs les plus ciblés de cette liste, conçu spécifiquement autour de la fraude documentaire financière dans le crédit et l'onboarding, plutôt que comme un module antifraude greffé sur autre chose.
L'éditeur se concentre sur les familles de documents où se trouve réellement l'argent : fiches de paie, relevés bancaires, documents fiscaux et justificatifs de revenus. Cette spécialisation permet des contrôles plus poussés sur ces formats précis qu'une plateforme généraliste n'y parvient habituellement, et implique moins de travail de configuration pour les équipes dont l'ensemble documentaire correspond.
C'est un éditeur plus petit que Resistant AI ou Inscribe, ce qui joue dans les deux sens : moins éprouvé à très grande échelle, mais plus réactif sur la feuille de route et le support.
Idéal pour : les équipes crédit et onboarding dont l'exposition à la fraude se concentre presque entièrement sur les documents de revenus et bancaires.
Finovox, les conventions documentaires françaises et la vérification 2D-DOC
Finovox est l'option française du marché domestique, et pour les organisations traitant des documents administratifs français, cela pèse concrètement au-delà d'une simple préférence.
Une détection calibrée sur les conventions documentaires françaises compte plus qu'il n'y paraît. Le schéma de signature 2D-DOC utilisé sur les documents d'identité français, les avis d'imposition et les justificatifs de domicile exige de lire un Data Matrix par rapport à une clé publique publiée par l'administration. Une plateforme dépourvue de cette capacité ne peut tout simplement pas réaliser le contrôle le plus fiable disponible sur ces documents. Les conventions des bulletins de salaire français, les références URSSAF et les formats d'avis d'imposition sont tout aussi spécifiques.
Finovox se positionne autour de l'assurance, de la banque, de l'immobilier et des RH, où la détection de fraude bancaire et les sinistres d'assurance se recoupent fortement.
Idéal pour : les organisations traitant des documents administratifs français, en particulier dans l'assurance et l'immobilier.
Regula, la comparaison mondiale de modèles de documents d'identité
L'atout de Regula est sa base de données, l'élément que ses concurrents ont le plus de mal à reproduire.
L'entreprise entretient l'une des bibliothèques de modèles de documents d'identité les plus complètes qui existent, couvrant des spécimens de documents du monde entier avec, pour chacun, les éléments de sécurité, la mise en page et les spécifications de la zone de lecture optique (MRZ). La détection compare le document soumis au modèle de référence pour ce pays et cette version exacts.
Pour l'OCR des documents d'identité et la vérification de passeports, c'est un avantage réel, qui répond directement aux points de rupture liés à la MRZ et à la mise en forme décrits plus haut. Pour la fraude documentaire financière, les factures et les relevés bancaires, c'est en revanche une catégorie d'outil totalement inadaptée. Disponible sous forme de SDK et d'API, y compris en déploiement hors ligne, une exigence de certains environnements réglementés.
Idéal pour : le contrôle aux frontières, le voyage, et toute organisation vérifiant en profondeur des documents d'identité internationaux.
Sumsub, le KYC, l'AML et les contrôles documentaires unifiés
Sumsub couvre le périmètre le plus large de cette liste, en combinant l'OCR pour le KYC, le filtrage AML, la détection de vivacité, la vérification d'entreprise et les contrôles de faux documents derrière une seule intégration.
Cette étendue est à la fois l'argument de vente et la réserve à émettre. Un seul fournisseur couvrant l'identité, le filtrage des sanctions et l'authenticité documentaire élimine plusieurs casse-têtes d'achat et d'intégration. Mais l'étendue se paie généralement au prix de la profondeur, et les contrôles de faux documents de Sumsub ne sont ni aussi poussés sur le plan forensique qu'un spécialiste comme Resistant AI, ni aussi approfondis sur le plan sémantique pour les documents financiers B2B que les plateformes conçues pour cela.
Il est à noter que Sumsub figure parmi les éditeurs dont les forums de fraude discutent les moyens de déjouer, un indicateur en creux de sa part de marché.
Idéal pour : les plateformes crypto, fintech et marketplace ayant besoin de KYC, d'AML et de contrôles documentaires au sein d'un même contrat.
La catégorie adjacente : la vérification d'identité
Onfido (désormais rattaché à Entrust), Jumio, Mitek et ComplyCube figurent dans la plupart des comparatifs de ce type, et ce sont des plateformes performantes, mais elles répondent à une autre question.
La vérification d'identité cherche à savoir si une personne est bien celle qu'elle prétend être. La détection de fraude documentaire cherche à savoir si un document est bien ce qu'il prétend être. Ces deux approches se recoupent sur les cartes d'identité et les passeports, et divergent totalement partout ailleurs. Onfido couvre 195 pays et 2 500 types de documents. Jumio a lancé en 2025 une détection de vivacité résistante aux deepfakes, puis étendu son offre à une surveillance continue post-onboarding en avril 2026. Mitek, historiquement ancré dans la vérification de chèques, a ajouté en février 2026 la détection de deepfakes, de morphing facial et d'injection.
Aucun d'entre eux ne vous dira si une facture fournisseur a été altérée, car ce n'est pas leur vocation. Si votre exposition concerne l'onboarding grand public à l'échelle internationale, commencez par ces acteurs. Si votre exposition concerne une facture falsifiée ou un relevé bancaire trafiqué au sein d'une relation B2B, ce n'est pas la bonne présélection.
Les 5 failles des outils de détection de fraude, et comment les surmonter
L'IA générative a changé la nature de ce problème, mais pas de la manière que suggère la plupart des articles sur le sujet. Les faux documents numériques ont augmenté de 244 % en un an. Les outils en difficulté sont ceux conçus pour repérer des pixels clonés et des données EXIF modifiées, car les faux qui comptent aujourd'hui ne présentent ni l'un ni l'autre.
Cinq failles structurelles subsistent, et c'est sur elles qu'une plateforme de détection doit être jugée.
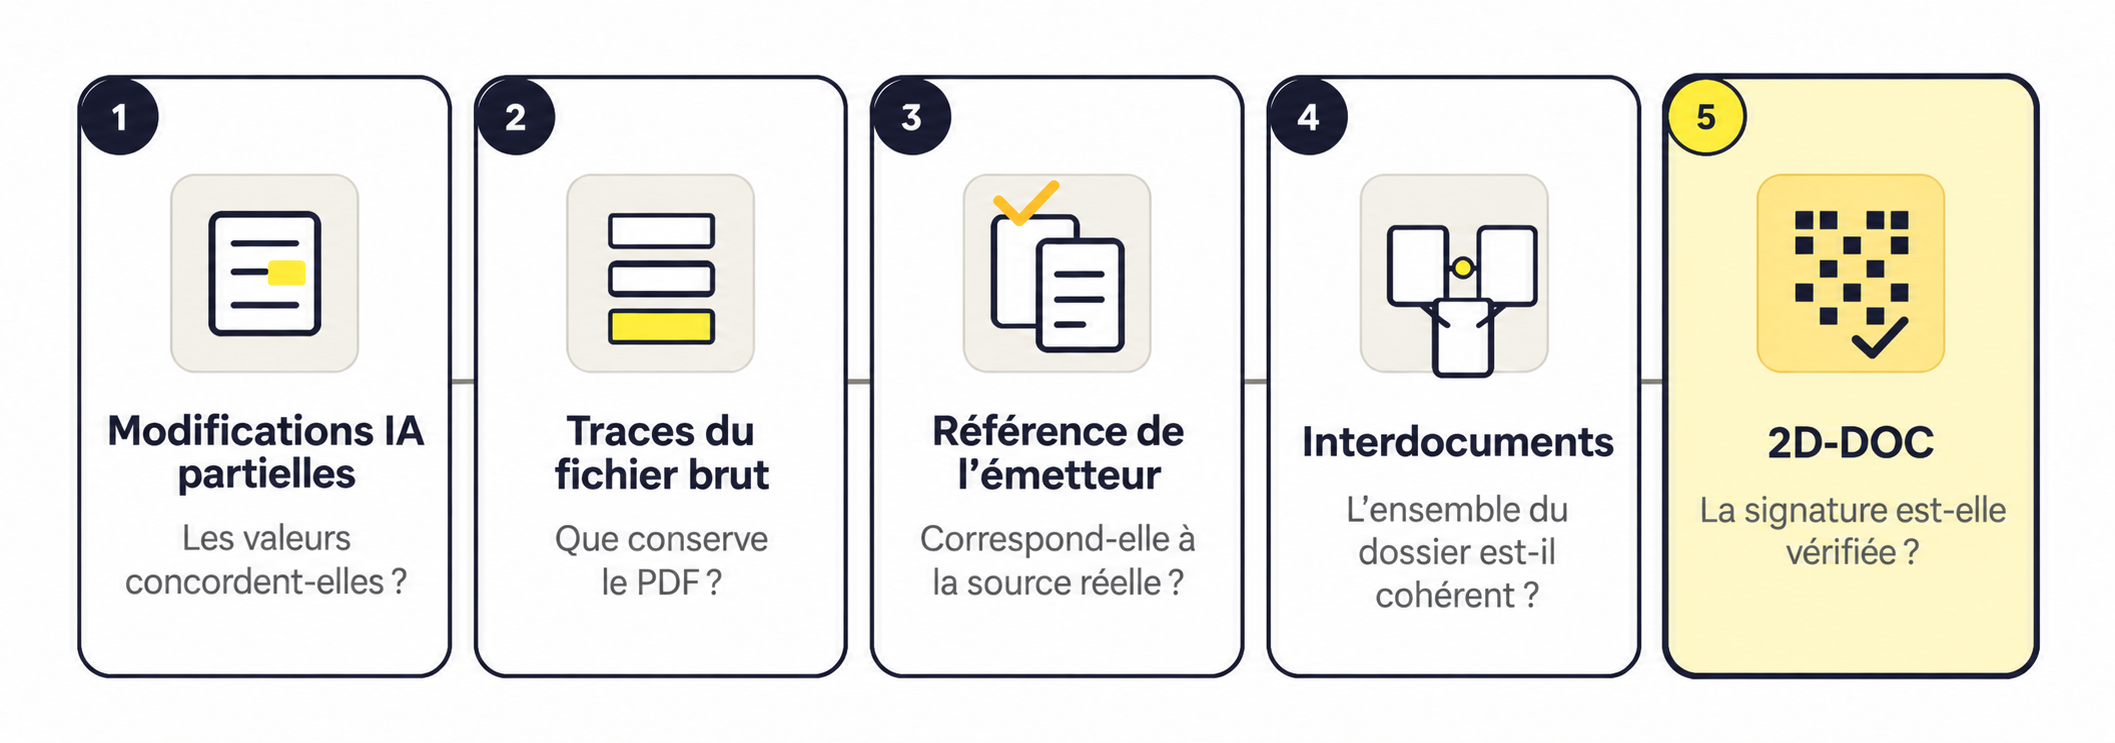
1. Les documents partiellement modifiés par IA.
C'est le cas le plus difficile, et la plupart des outils restent aujourd'hui impuissants face à lui.
Il faut distinguer deux choses souvent confondues. Un document dont l'image est entièrement générée par IA reste relativement facile à repérer. L'œil humain le remarque souvent, les artefacts du modèle sont détectables, et les fraudeurs oublient fréquemment de supprimer les métadonnées qui les trahissent.
Le cas difficile est celui d'un document authentique dont l'IA n'a modifié qu'une partie. Un vrai relevé bancaire avec trois chiffres changés. Une vraie fiche de paie dont le montant brut a été ajusté. Il n'y a aucun artefact de montage puisque rien n'a été collé. Il n'y a aucune signature de tampon de duplication puisque rien n'a été cloné. Les modèles de détection par ML traditionnels sont entraînés à repérer des schémas de manipulation qui, tout simplement, ne sont pas présents, et ils rendent un verdict propre sur un document qui a pourtant été altéré à l'endroit précis qui compte. Les détecter exige de lire ce que disent les chiffres plutôt que d'observer l'apparence des pixels.
2. Les métadonnées et les traces dans le fichier brut.
Certains fraudeurs laissent des traces évidentes. Un PDF passé par Canva se trahit dans la chaîne « producer ». D'autres sont plus prudents et suppriment entièrement les métadonnées visibles.
Toute modification d'un PDF laisse des traces quelque part dans la structure brute du fichier, quel que soit le contenu des métadonnées visibles. Révisions d'objets, historique d'enregistrements incrémentaux, anomalies dans la table de références croisées, incohérences dans les sous-ensembles de polices. Dans certains cas, le contenu antérieur à la modification reste récupérable dans le fichier, ce qui révèle non seulement qu'un document a été altéré, mais aussi exactement où. Il s'agit d'un problème d'analyse du fichier brut, non de simple lecture de métadonnées, et cette distinction sépare les plateformes capables de repérer des fraudeurs prudents de celles qui ne détectent que les négligents.
3. Les artefacts de calques et de modification.
Les éditeurs d'images fonctionnent par calques, et les calques laissent des zones plates et uniformes là où du texte a été inséré. Des chiffres posés sur une surface parfaitement lisse constituent un signe révélateur, et les algorithmes de détection peuvent reconstituer la pile de calques a posteriori. L'usage du tampon de duplication dans Photoshop laisse également un motif reconnaissable. Il en va de même pour les éléments générés par IA insérés dans un document par ailleurs authentique, comme un petit logo ou une image de produit fabriquée et déposée sur un vrai reçu.
4. Les incohérences de police et de mise en forme.
Les documents d'identité utilisent des polices propriétaires non disponibles dans le commerce, et un faussaire ne peut jamais faire mieux que s'en approcher. La comparaison avec des références extraites de dizaines de milliers de documents authentiques permet de repérer l'écart. Les écarts de mise en forme fonctionnent de la même manière : ordre des composants d'une adresse, longueur des codes alphanumériques, conventions de ponctuation. Le générateur laisse la main à un humain, et les humains ne connaissent pas le format uniforme exact utilisé par une administration.
5. La vérification des codes-barres et cryptographique.
Tout document porteur d'un 2D-DOC, d'un code QR ou d'un Data Matrix pose un problème pour un faussaire. Le Data Matrix d'une carte d'identité française est signé par une clé privée détenue uniquement par France Titres. Un faussaire peut générer un code aux données d'apparence correcte mais à la signature invalide, ou coller un code valide dérobé sur une autre carte, auquel cas la signature se vérifie mais le contenu ne correspond pas au titulaire. Les deux cas sont détectables par quiconque lit correctement le code, et ce contrôle est quasiment probant à lui seul.
Sous ces cinq points se cache une sixième question, qui ne relève pas d'une propriété du document lui-même. Les chiffres se recoupent-ils ? Les totaux sont-ils justes, le taux de TVA correspond-il à la juridiction, les dates et les parties concordent-elles à travers tous les fichiers d'un même dossier ? Les faux générés ou modifiés par IA sont visuellement irréprochables. Ils sont bien plus défaillants sur la cohérence interne, et plus défaillants encore sur la cohérence avec les autres documents d'un même dossier.
Comment choisir son logiciel de détection de fraude documentaire en 2026
Commencez par le document, pas par l'éditeur.
Si votre fraude se présente sous forme de factures falsifiées, de relevés bancaires altérés ou de fiches de paie manipulées, vous avez besoin de contrôles sémantiques et inter-documents, pas seulement d'analyse forensique. Une facture générée aux métadonnées propres passe un contrôle forensique mais échoue à un recalcul de TVA. Koncile, Inscribe et Fortiro sont conçus autour de cette logique. C'est également le cas d'un logiciel de vérification de factures bien configuré, et associer le scoring de fraude à une détection des factures en double permet de combler une faille que l'analyse forensique seule laisse ouverte.
Si votre fraude se présente sous forme de dossiers de location, Snappt dispose de données plus pertinentes que quiconque.
Si elle se présente sous forme de documents d'identité provenant de nombreux pays, la bibliothèque de modèles de Regula ou les spécialistes de l'identité mentionnés plus haut surpasseront n'importe quel généraliste.
Si vous traitez des documents porteurs d'un 2D-DOC, dont des cartes d'identité européennes, des avis d'imposition français et certaines factures, vérifiez que la plateforme peut authentifier le Data Matrix par rapport à la clé publique de l'autorité émettrice. Plusieurs acteurs de cette liste ne le peuvent pas, alors qu'il s'agit du contrôle isolé le plus probant disponible sur ces documents.
Si vous avez besoin d'extraction et de contrôle antifraude en une seule passe, le choix se restreint rapidement : Koncile, Doxis AI.dp et Ocrolus, à peu près dans cet ordre selon que vous privilégiez la profondeur antifraude ou le volume d'OCR.
Trois questions à poser à tout éditeur avant de signer. Demandez-lui de traiter cinquante de vos propres documents, y compris d'éventuels faux déjà identifiés que vous auriez conservés, et de vous montrer le résultat. Demandez ce qu'il advient du score de confiance lorsqu'un document est limite, et si un humain le réexamine. Demandez précisément comment ils détectent un document authentique dont seuls quelques chiffres ont été modifiés, car c'est le cas que la plupart des outils gèrent le plus mal.
Ce qui est certain, c'est que l'analyse forensique visuelle seule ne suffit plus à trancher. Les faux générés par IA sont parfaits au pixel près. Ce qu'ils ne peuvent pas simuler, c'est la cohérence : des totaux qui se recoupent, des identifiants fiscaux qui se vérifient, des dates et des parties qui concordent à travers tous les documents d'un dossier. La défense la plus solide lit les données, pas seulement l'image.
FAQ
Quelle est la précision des logiciels de détection de la fraude documentaire ?
Tous les chiffres de précision publiés sur ce marché sont autodéclarés et aucun n'a fait l'objet d'une vérification indépendante. Snappt revendique 99,8 %, Resistant AI affiche 99,2 % sur son site web et 99,92 % sur sa fiche AWS, tandis qu'Ocrolus annonce plus de 90 % de vrais positifs. Il n'existe aucun jeu de données benchmark commun à l'ensemble des éditeurs. La seule mesure pertinente est un test de concept (PoC) réalisé sur vos propres documents, en y incluant des faux que vous avez déjà détectés manuellement.
Les logiciels de détection de fraude peuvent-ils repérer les documents générés par IA ?
Cela dépend du type de falsification. Un document dont l'image est entièrement générée par IA est relativement simple à intercepter : les artéfacts sont détectables et les fraudeurs laissent souvent des métadonnées. Le cas complexe concerne un document authentique dont l'IA n'a modifié que quelques valeurs, comme un véritable relevé bancaire avec trois chiffres altérés. Rien n'ayant été collé ou cloné, les modèles classiques de falsification ne trouvent aucun motif de manipulation et renvoient un résultat conforme. Détecter ces cas exige de vérifier la cohérence même des données. Notre guide sur la fraude documentaire par deepfake traite ce sujet en détail.
Quelle est la différence entre la détection de la fraude documentaire et la vérification d'identité ?
La vérification d'identité confirme qu'une personne est bien celle qu'elle prétend être, en s'appuyant sur la biométrie et le contrôle de pièces d'identité. La détection de la fraude documentaire confirme qu'un document est authentique et non altéré, ce qui s'applique aussi bien aux factures, relevés bancaires, bulletins de paie et contrats qu'aux cartes d'identité. Elles se recoupent sur les pièces d'identité, mais divergent pour tout le reste. Acquérir une plateforme d'identité pour contrer la fraude aux factures est une erreur fréquente et coûteuse.
Les logiciels gratuits de détection de falsification documentaire valent-ils la peine d'être utilisés ?
Les solutions open source sont utiles pour un test de concept ou pour comprendre le fonctionnement de la détection visuelle, mais elles ne sont pas prêtes pour la production. Elles ne disposent pas des bases de données de référence, des bibliothèques de signatures de générateurs maintenues à jour ni des moteurs de règles métier nécessaires à une détection fiable, et la plupart ne sont plus maintenues. Pour tout processus présentant un risque financier réel, elles constituent un outil d'apprentissage, pas un dispositif de contrôle.
Quels sont les documents les plus souvent falsifiés ?
Les bulletins de paie, avis d'imposition, relevés d'identité bancaire ou de compte, attestations de sinistralité d'assurance et pièces d'identité. Chacun sert de justificatif dans le cadre d'une décision à fort enjeu : location, octroi de crédit, souscription d'assurance ou entrée en relation (onboarding). La falsification est rarement l'objectif final ; elle sert simplement à franchir le contrôle d'accès.
La détection de la fraude documentaire peut-elle s'exécuter via une API ?
La majorité des plateformes de ce secteur s'appuient sur une approche API-first, et au-delà d'un faible volume, c'est la seule méthode de déploiement pertinente. Vérifiez spécifiquement si le score de fraude est exécuté lors de la même requête d'extraction ou s'il nécessite une seconde intégration : faire appel à deux fournisseurs implique deux contrats, deux budgets de latence et deux points de rupture potentiels dans le flux de traitement.
En quoi la détection de fraude OCR diffère-t-elle de l'OCR standard ?
L'OCR standard convertit une image en texte. La détection de fraude basée sur l'OCR utilise ces données structurées extraites comme entrée d'une couche de vérification : recalcul des totaux, validation des identifiants par rapport aux formats connus et croisement des valeurs sur l'ensemble des documents d'un même dossier. L'extraction est le moyen ; la vérification est la finalité.
Combien doit coûter un système de détection de la fraude ?
La tarification dans ce domaine est presque exclusivement sur devis et dépend des volumes, ce qui rend la comparaison publique difficile. Attendez-vous à un prix par document pour les volumes réguliers et à des frais de plateforme pour les comptes entreprises. Le calcul le plus pertinent reste celui du risque encouru : un seul document falsifié qui valide à tort un prêt, un bail ou une entrée en relation coûte généralement plus cher qu'une année entière d'analyse automatisée.
Qu'est-ce qu'un logiciel de détection de la fraude documentaire ?
Un logiciel de détection de la fraude documentaire vérifie si un document transmis est authentique et n'a pas été altéré. Il combine l'analyse forensique d'image, l'inspection du fichier brut et de ses métadonnées, ainsi que des contrôles de règles métier qui recalculent les montants et croisent les données entre plusieurs documents. Il se distingue de la vérification d'identité, qui contrôle un individu plutôt qu'un document.
Comment détecter un faux relevé bancaire ?
La détection des faux relevés bancaires repose sur trois niveaux de contrôle : l'analyse forensique de l'image pour détecter les artéfacts de retouche, l'inspection du fichier PDF brut pour trouver des traces de modification invisibles dans les métadonnées de surface, et la comparaison avec la structure de fichier attendue de la banque émettrice. Le recalcul du solde progressif permet d'intercepter les altérations qui échappent aux contrôles visuels.
Qu'est-ce que la vérification 2D-DOC ?
Le 2D-DOC est un code-barres Data Matrix signé utilisé en France sur les justificatifs de domicile, avis d'imposition et documents d'identité. Il est signé au moyen d'une clé privée détenue par l'autorité émettrice. Un fraudeur peut générer un code avec une signature invalide ou coller un code valide issu d'un autre document, deux manipulations qui restent détectables. La vérification consiste à lire le code avec la clé publique officielle de l'autorité et à comparer les données décodées avec les informations imprimées sur le document.
La détection de la fraude documentaire fonctionne-t-elle sur les factures ?
Oui, et les factures comptent parmi les documents d'entreprise les plus souvent falsifiés. La détection combine des contrôles forensiques et la validation de règles métier : recalcul du détail des lignes et de la TVA, vérification du numéro d'identification fiscale du fournisseur (SIREN/TVA intracommunautaire), détection des doublons déjà traités et croisement avec les bons de commande et bons de livraison du même dossier.
Sources
Entrust, Onfido Identity Fraud Report. Étude sur la croissance de la fraude documentaire numérique et la fréquence des attaques par deepfake.
Koncile, Des développeurs lancent MacDoc, un générateur illégal de faux passeports. Enquête originale sur les mécanismes des générateurs de faux documents, août 2026.
Département de la Justice des États-Unis, communiqué de presse sur les charges et le plaidoyer de culpabilité de l'opérateur d'OnlyFake.
Resistant AI, annonce de levée de fonds en série B, octobre 2025.
Documentation éditeur et pages de tarification publiques de chaque plateforme listée, consultées en septembre 2026.
Observations de terrain issues des échanges avec les clients de Koncile et des données de la plateforme.
Nos retours terrain sur l'automatisation documentaire
Les 5 meilleures solutions OCR françaises pour extraire les données de vos documents
Cinq solutions OCR françaises permettent aujourd'hui d'extraire automatiquement les données de vos factures, contrats et documents comptables grâce à la reconnaissance optique de caractères, avec un hébergement localisé en France. On les présente ici.
Traitement de documents et détection de fraude : construire ou acheter ?
Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.
Dans la santé, un OCR se juge sur ce qu’il signale, pas sur ce qu’il lit
Tous les éditeurs d’OCR annoncent des taux de précision élevés, et la plupart les tiennent. Sur un document de santé, ce n’est pas le bon critère d’achat. Ce qui compte, c’est ce que l’outil fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule.

Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques
Amazon Textract est formellement éligible HIPAA depuis octobre 2019. La plupart des comparatifs OCR santé ne le vérifient jamais pour les autres outils de leur liste. Voici une reconstruction qui vérifie le statut de conformité directement, et qui regarde ce que les vrais essais cliniques sur les scribes IA ambiants ont trouvé, pas seulement le marketing.
Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026
Un freelance qui envoie une douzaine de factures par mois peut dépasser le plafond du forfait le moins cher de Xero dès la troisième semaine, et FreshBooks plafonne à cinq clients. Le chiffre affiché sur une page tarifaire est rarement celui que vous payez réellement. Voici une comparaison honnête de QuickBooks, Xero, Wave et FreshBooks, pensée pour une entreprise d'une seule personne.