Classement des meilleurs OCR pour l'écriture manuscrite en 2026
Comparatif des meilleurs OCR capables de lire et structurer automatiquement l’écriture manuscrite avec fiabilité en 2026.
Reconnaître l’écriture manuscrite reste l’un des plus grands défis pour les technologies OCR. Entre variations de style, documents scannés de qualité variable et contextes métier exigeants (santé, RH, logistique…), toutes les solutions ne se valent pas. Dans cet article, nous avons comparé les meilleurs OCR capables de lire et structurer automatiquement des documents manuscrits en 2026, avec un objectif clair : fiabilité, gain de temps et intégration dans vos outils métiers.
Sur une ligne manuscrite propre issue d'un jeu de données de recherche, les meilleurs modèles d'IA généralistes atteignent aujourd'hui un taux d'erreur par caractère de 1,75 %. C'est mieux que les modèles spécialisés dans l'écriture manuscrite, construits exactement pour cette tâche, qui tournent autour de 9 %. Sur quarante neuf formulaires médicaux manuscrits réels, le meilleur modèle de 2026 plafonne à 85 % de champs lus correctement.
Les deux sont vrais, et l'écart entre eux est le sujet. Lire du manuscrit est quasiment résolu. En faire des données exploitables par un logiciel métier ne l'est pas. Nous avons testé six outils sur les trois mêmes documents, de la ligne isolée à une vraie facture.
L'OCR fonctionne-t-il sur l'écriture manuscrite ?
L'OCR traditionnel compare des pixels à des formes de caractères connues. L'écriture manuscrite n'a pas de formes connues. La documentation de Tesseract répond en une phrase : c'est possible, « mais ça ne marchera pas très bien, car Tesseract est conçu pour du texte imprimé ».1 C'est la position du moteur open source le plus déployé au monde.
Les modèles de vision et langage ne comparent aucune forme. Ils déduisent un caractère ambigu des mots qui l'entourent, comme un lecteur déchiffre l'ordonnance d'un médecin. Ce passage de la reconnaissance de formes à la lecture contextuelle est la seule raison pour laquelle le manuscrit est devenu traitable.
La preuve la plus claire que le manuscrit reste le cas dur, c'est ce sur quoi les fournisseurs cloud s'engagent. AWS Textract extrait l'imprimé dans six langues et le manuscrit en anglais uniquement.2 Azure AI Document Intelligence lit l'imprimé dans environ trois cents langues et le manuscrit dans douze, dont le français.3 Mêmes moteurs, mêmes sociétés, un facteur vingt cinq sur la couverture.
Ce que mesurent vraiment les benchmarks
Le manuscrit se mesure avec le taux d'erreur par caractère, ou CER : la proportion de caractères à insérer, supprimer ou remplacer pour transformer la sortie machine en texte correct. Un CER de 2 % signifie deux caractères faux sur cent. La référence est IAM, construit à l'université de Berne à partir de phrases du corpus LOB : 657 scripteurs, 1 539 pages numérisées et 13 353 lignes annotées, en anglais uniquement, sous licence de recherche.4
Mesurée dessus, la dernière décennie ressemble à ceci.
Les 1,75 % viennent d'un benchmark 2025 relu par les pairs, qui oppose huit modèles multimodaux à Transkribus sans aucun exemple fourni.5 Son second résultat compte autant : ces modèles montrent une « capacité limitée à corriger seuls leurs erreurs ». Ils lisent bien, ils ne savent pas quand ils ont mal lu.
Changez de document. Un benchmark d'avril 2026 a opposé dix sept modèles, propriétaires et open source, à quarante neuf formulaires médicaux manuscrits réels. Le meilleur atteint environ 85 % de champs corrects, et l'un des mieux classés invente du contenu dans 6 % des cas.6 Même effondrement sur OmniDocBench, où la distance d'édition de GPT-4o passe de 0,157 sur des pages de livre à 0,607 sur des notes manuscrites.7
Le benchmark à regarder dépend de ce que vous achetez. Pour une transcription, les chiffres IAM. Pour des champs dans une base, ceux des formulaires, et rien de publié ne dépasse aujourd'hui les 85 à 90 % sans une couche construite autour du modèle.
Notre protocole de test
Chaque outil a reçu les trois mêmes documents, sans réglage ni instruction taillée pour un fournisseur. Les trois forment une montée en difficulté volontaire.
Test 1, une ligne manuscrite isolée issue d'IAM. Transcription pure, aucune mise en page.
Test 2, un formulaire manuscrit issu de FUNSD, 199 formulaires numérisés de qualité inégale, 31 485 mots et 9 707 entités annotées, publiés pour la compréhension de formulaires plutôt que la transcription.8 Libellés imprimés et valeurs manuscrites cohabitent, et c'est là que le vrai travail commence.
Test 3, une facture américaine portant une signature manuscrite. Un document métier où le manuscrit occupe une petite zone d'une page imprimée, et où la sortie attendue est un nom, pas une forme.
Documents de test

Pen to Print

Édité par Serendi en application web, mobile, bureau et API REST, c'est le seul outil du comparatif conçu pour le manuscrit et rien d'autre. À partir de 9,99 $ par mois pour 100 pages, accès API à partir de 29,99 $ pour 1 000 pages, dix pages offertes pour essayer. L'éditeur annonce 98,7 % de précision au mot.9
Test sur une ligne manuscrite isolée
Pen to Print s'en sort correctement. Aucune erreur visible dans la transcription.

Test sur formulaire manuscrit
Le texte a été correctement reconnu, mais chaque bloc détecté revient sur une ligne distincte. Pen to Print ne distingue pas l'imprimé du manuscrit : la sortie reste brute, structurée par des retours à la ligne.

Test sur signature manuscrite de facture
Comme au test 2, la donnée manuscrite est correctement extraite. Il faut retrouver la ligne « Signature : dave » en bas de la sortie.

Résultat des 3 tests
Pen to Print passe les trois tests. Un transcripteur efficace, y compris sur des documents mêlant manuscrit et imprimé. La limite est le format de sortie, à peine structuré : récupérer une valeur précise reste manuel. Bon pour numériser des notes, mauvais pour alimenter un système.
TrOCR

Un modèle de Microsoft Research à poids ouverts, publié en 2021, toujours la référence open source du manuscrit. Architecture encodeur décodeur, un encodeur d'image BEiT alimentant un décodeur de texte RoBERTa, trois tailles de 62 à 558 millions de paramètres. La variante large annonce un CER de 2,89 sur IAM.10 Une ligne de sa fiche modèle explique tout ce qui suit : il est destiné aux « images d'une seule ligne de texte ».
Test sur une ligne manuscrite isolée
TrOCR a extrait le texte parfaitement, jusqu'au moindre détail. Test 1 réussi, ce que son CER publié promettait.

Test sur formulaire manuscrit
La sortie parle d'elle même. TrOCR n'a pas compris la structure du document et a renvoyé « ITV », sans doute un fragment du texte. Le modèle n'a aucune analyse de mise en page : une page structurée avec des champs manuscrits sort de son périmètre.

Test sur signature manuscrite de facture
Au lieu d'un nom, le modèle a produit des caractères non alphabétiques : la signature a été traitée comme une forme visuelle plutôt que comme de l'écriture.

Résultat des 3 tests
TrOCR tombe sur deux tests sur trois. Sans couche contextuelle, il n'a aucun moyen de les traiter. Sur la reconnaissance de ligne pure il est excellent et gratuit. Sur une écriture stylisée comme une signature, et sur un document métier structuré, il s'arrête. Bon choix pour de la transcription brute à grand volume, mauvais pour tout le reste. Même réserve pour la plupart des moteurs OCR open source.
OpenAI

Ce ne sont pas des produits OCR mais des modèles généralistes qui se trouvent bien lire les documents. Les images sont facturées en tokens : l'image est découpée en carrés de 32 pixels, leur nombre multiplié par un coefficient propre au modèle puis ajouté au prompt.11 La documentation vision ne mentionne aucune limite spécifique au manuscrit, et dans le benchmark 2025 cité plus haut, GPT-4o atteint un CER de 1,75 sur les lignes IAM sans entraînement.
Test sur une ligne manuscrite isolée
Tout le texte est revenu, avec une erreur de format : les guillemets présents dans la phrase ont été détectés, et d'autres ajoutés là où il n'y en avait pas. La reconnaissance du manuscrit a fonctionné, la ponctuation non.

Test sur formulaire manuscrit
Sur les champs manuscrits du formulaire, le texte a été extrait sans erreur.

Test sur signature manuscrite de facture
La signature manuscrite a été correctement détectée et transcrite.

Résultat des 3 tests
Une seule erreur, mais instructive. Les guillemets hallucinés n'ont pas empêché l'extraction, mais ils illustrent le mode d'échec d'un modèle généraliste : il n'échoue pas en ne renvoyant rien, il échoue en renvoyant du plausible. Plus difficile à repérer qu'un champ vide.
Gemini

Google arrive deux fois ici. Gemini accepte des PDF jusqu'à 50 Mo ou 1 000 pages, facture une page 258 tokens et a une offre gratuite sur ses modèles Flash.12 Google Cloud Document AI vend par ailleurs Enterprise Document OCR, qui traite le manuscrit dans plus de 200 langues à 1,50 $ les 1 000 pages, avec une détection de manuscrit signalée token par token.13 Dans le benchmark 2026 sur formulaires manuscrits, un modèle Gemini arrive en tête avec environ 85 % de champs corrects.
Test sur une ligne manuscrite isolée
Le texte manuscrit a été intégralement extrait, y compris les guillemets qui avaient piégé l'outil précédent.

Test sur formulaire manuscrit
Parfaitement exécuté. Tous les champs manuscrits ont été extraits correctement.

Test sur signature manuscrite de facture
Réussi également. Gemini a détecté et extrait le nom de la signature manuscrite.

Résultat des 3 tests
Trois tests, aucune erreur. La couche de compréhension fait la différence sur le formulaire et la signature, là où lire les pixels ne suffit pas et où il faut comprendre à quoi sert la zone. Comme brique technologique c'est excellent. Ce qu'elle ne donne pas : un score de confiance par champ, un endroit où définir les champs voulus, ou un moyen de savoir que la réponse produite est fausse.
Mindee

Une API de traitement documentaire vendue au crédit : une page traitée coûte un crédit, 1,5 avec score de confiance.14 La reconnaissance du manuscrit est arrivée sur les reçus en 2023. Contrairement aux trois précédents, ce n'est pas un outil qu'on pointe vers un document : il faut d'abord définir un modèle d'extraction et son schéma de données, ce que nous avons fait pour chaque test.
Test sur une ligne manuscrite isolée
Sur la ligne manuscrite, Mindee a correctement extrait la donnée. Aucune erreur identifiée.

Test sur formulaire manuscrit
Sur des documents plus complexes, Mindee extrait le texte manuscrit à l'intérieur d'un champ défini, ce qui fait sa force et sa contrainte.

Test sur signature manuscrite de facture
La signature manuscrite a été correctement extraite dans le champ créé pour elle.

Résultat des 3 tests
Trois réussites, à une condition. Pour les trois tests il a fallu construire un modèle dédié au texte manuscrit. Une fois configuré, Mindee a identifié les bonnes zones et renvoyé l'information. Option solide, à condition de savoir à l'avance quels champs vous voulez et d'accepter un gabarit par type de document. Comparatif complet ici.
Koncile

Koncile est une plateforme d'extraction documentaire par IA plutôt qu'un moteur OCR : classification, extraction, validation par règles métier et détection de fraude documentaire dans un seul pipeline. Les champs se décrivent en langage naturel, sans modèle à entraîner, et l'extraction de texte manuscrit est un type de champ à part entière, à côté des champs imprimés.
Test sur une ligne manuscrite isolée
Sur la ligne manuscrite isolée, le texte a été extrait avec toutes ses subtilités et sans erreur.

Test sur formulaire manuscrit
Tout a également été correctement extrait. Au delà des noms manuscrits, les dates associées remontent automatiquement, chacune rattachée au bon champ plutôt que renvoyée comme une ligne isolée.

Test sur signature manuscrite de facture
Le nom de la signature a été extrait dans le champ de texte manuscrit dédié, à côté des données imprimées de la facture.

Score global des 3 tests
Trois tests, aucune erreur, et des informations complémentaires remontées aux tests 2 et 3. Les champs d'extraction sont générés à partir de ce qui est détecté dans le document, avec des champs dédiés au manuscrit et des champs structurés pour le reste. Cette séparation rend la sortie exploitable en aval : une valeur lue sur du manuscrit est étiquetée comme telle, donc routable vers un contrôle humain pendant que les champs imprimés passent seuls.
Les résultats côte à côte
| Outil | Ligne | Formulaire | Signature | Erreurs | Ce que vous récupérez |
|---|---|---|---|---|---|
| Pen to Print | Réussi | Réussi | Réussi | 0 | Texte brut, ligne à ligne |
| TrOCR | Réussi | Échec | Échec | 2 | Texte brut, une ligne à la fois |
| OpenAI | Ponctuation | Réussi | Réussi | 1 | Texte libre, format variable |
| Gemini | Réussi | Réussi | Réussi | 0 | Texte libre ou JSON sur demande |
| Mindee | Réussi | Réussi | Réussi | 0 | Champs, gabarit à construire |
| Koncile | Réussi | Réussi | Réussi | 0 | Champs, manuscrit typé à part |
Lisez la dernière colonne d'abord. Quatre outils sur six passent tous les tests et aucun n'est interchangeable, parce que réussir ne veut pas dire la même chose à chaque fois. Pen to Print renvoie des caractères. TrOCR les caractères d'une ligne. OpenAI et Gemini un texte dont la forme dépend de votre demande. Mindee et Koncile des champs, la seule sortie qu'un logiciel métier consomme sans que quelqu'un la réécrive.
Ce que le tableau cache, c'est le document qui n'y figure pas. Chaque outil a reçu trois échantillons propres. La recherche publiée dit que le classement tient sur des lignes propres et s'effondre sur des formulaires réels, et c'est pour cela que le choix qui suit porte sur le pipeline, pas sur la lecture.
Ce qui casse après la transcription
En production, le manuscrit est rarement le point dur. Ce qu'il veut dire, si.
Prenez une ordonnance hospitalière chez un prestataire de soins à domicile. Plusieurs traitements sont imprimés sur la page et un seul est réellement prescrit, signalé par une case cochée. Un transcripteur les renvoie tous. HealthNet Homecare traite plus d'un million de pages par an ainsi, et ce qui a décidé leur choix n'était pas la qualité de transcription : c'était de ne remonter que les lignes cochées, de rapprocher le traitement de leur référentiel médicaments et de confronter le résultat à la saisie des équipes. Environ un dossier sur quarante présente un écart, désormais repéré avant préparation plutôt qu'après. Une posologie manuscrite est exactement le cas que leur score de confiance envoie vers un humain. Le détail est dans le cas client HealthNet Homecare.
Même document, autre contexte : au laboratoire, la secrétaire lit l'ordonnance, identifie chaque examen et le fait correspondre au code de la nomenclature interne. Associée à un bouton sur le scanner chez EPSON, l'ordonnance passe du bac au dossier patient avec les examens déjà codés. Le manuscrit est une étape sur quatre, et les trois autres sont là où partait le temps.
Trois choses séparent un transcripteur d'un pipeline, aucune ne concerne la lecture. Savoir de quel document il s'agit avant d'extraire, pour ne pas traiter un formulaire comme une facture. Rattacher chaque valeur à un champ nommé plutôt qu'à un numéro de ligne. Signaler l'incertitude valeur par valeur, pour qu'une file de relecture existe. Sans cette troisième, 85 % de champs corrects signifie que 15 % de vos enregistrements sont faux en silence.
Quel OCR choisir selon vos besoins ?
La réponse dépend de ce qui arrive au texte une fois lu.
Vous voulez une transcription. Carnets, archives, notes de réunion. Pen to Print le fait bien pour quelques euros par mois, TrOCR gratuitement si vous savez faire tourner un modèle et que vos documents sont des lignes isolées. Aucun des deux ne structure quoi que ce soit.
Vous lisez quelques documents de temps en temps. OpenAI et Gemini sont le chemin le plus rapide, sans installation ni engagement. Surveillez le mode d'échec : ils répondent même quand ils ne devraient pas, et ne donnent rien pour le vérifier.
Vous avez besoin de manuscrit dans un processus métier, en volume, alimentant un ERP, un dossier patient ou un SIRH. C'est là que Mindee et Koncile ont leur place et que les autres cessent d'être candidats. Mindee attend que vous modélisiez chaque type de document en amont. Koncile génère les champs à partir du document, type le manuscrit à part de l'imprimé, note chaque valeur et applique des règles métier par dessus, ce qui transforme 85 % de champs lus en un processus exploitable.
Une règle tient quel que soit votre choix : testez sur vos propres documents, pas sur un échantillon propre. L'écart entre une ligne de benchmark et votre pire scan est plus grand qu'entre deux outils de ce comparatif.
Questions fréquentes
L'OCR fonctionne-t-il sur l'écriture manuscrite ?
Oui, bien mieux qu'il y a deux ans. Sur des lignes manuscrites propres, les modèles d'IA généralistes atteignent un taux d'erreur par caractère autour de 1,75 %, ce qui dépasse les modèles entraînés spécifiquement pour le manuscrit. La précision chute sur des documents réels : sur des formulaires manuscrits, les meilleurs modèles de 2026 lisent environ 85 % des champs correctement. Les moteurs classiques comme Tesseract ne sont pas conçus pour le manuscrit.
Quel est le meilleur OCR pour l'écriture manuscrite ?
Cela dépend de l'usage. Pour de la transcription pure, Pen to Print et TrOCR sont efficaces. Pour lire quelques documents ponctuellement, OpenAI et Gemini sont précis et ne demandent aucune mise en place. Pour de l'extraction structurée qui alimente un logiciel métier, Koncile et Mindee sont les deux options de ce comparatif, et Koncile est celui qui n'impose pas de gabarit par type de document au préalable.
Un OCR peut-il lire une écriture cursive et une signature ?
La cursive est bien gérée par les modèles dotés d'une couche contextuelle, qui déduisent les lettres ambiguës des mots voisins. La signature est un autre problème, plus proche d'un dessin. Dans notre test, le modèle open source a renvoyé des caractères non alphabétiques quand les modèles avec compréhension ont renvoyé le nom. Si vous avez besoin du nom derrière une signature, testez ce cas.
Un OCR manuscrit gratuit suffit-il ?
Pour de la transcription, souvent oui. TrOCR est gratuit et open source, Pen to Print offre dix pages. La limite porte sur la structure plutôt que sur la lecture : les outils gratuits renvoient du texte plat, donc extraire une valeur précise reste manuel. Les OCR manuscrits cloud démarrent autour de 1,50 $ les 1 000 pages.
Quelle précision attendre sur des formulaires médicaux ou métier ?
Nettement moins que les chiffres mis en avant. Une étude de 2026 sur dix sept modèles et des formulaires médicaux manuscrits réels mesure environ 85 % de champs lus correctement pour les meilleurs, avec du contenu inventé dans certains cas. Un score de confiance par champ et un circuit de relecture comptent donc plus que la dernière décimale.
Quelles langues sont couvertes pour le manuscrit ?
Beaucoup moins que pour l'imprimé. AWS Textract ne traite le manuscrit qu'en anglais, contre six langues en imprimé. Azure couvre douze langues manuscrites dont le français, contre environ trois cents en imprimé. Google Cloud Document AI annonce plus de 200 langues. Les plateformes bâties sur des modèles multimodaux sont moins contraintes, mais l'affirmation mérite d'être testée sur votre alphabet.
Sources
- Documentation Tesseract, FAQ, « Can I use Tesseract for handwriting recognition? », tesseract-ocr.github.io
- Amazon Web Services, FAQ Textract, langues et prise en charge du manuscrit, aws.amazon.com
- Microsoft Learn, Azure AI Document Intelligence, langues du modèle Read v4.0, learn.microsoft.com
- FKI, IAM Handwriting Database v3.0, Marti et Bunke, université de Berne, fki.tic.heia-fr.ch
- Crosilla, Klic et Colavizza, « Benchmarking Large Language Models for Handwritten Text Recognition », arXiv 2503.15195, 2025, et Journal of Documentation vol. 81 n° 7. Huit modèles multimodaux opposés à Transkribus sur des corpus anglais, français, allemands et italiens, arxiv.org/abs/2503.15195
- Pather et al., « From Handwriting to Structured Data: Benchmarking AI Digitisation of Handwritten Forms », arXiv 2604.16504, avril 2026. Dix sept modèles sur 49 formulaires médicaux manuscrits réels, arxiv.org/abs/2604.16504
- OmniDocBench, arXiv 2412.07626, distance d'édition par type de page, arxiv.org/abs/2412.07626
- Jaume, Ekenel et Thiran, « FUNSD: A Dataset for Form Understanding in Noisy Scanned Documents », ICDAR-OST 2019, arxiv.org/abs/1905.13538
- Pen to Print, page tarifs, septembre 2026. Précision annoncée par l'éditeur, pen-to-print.com
- Li et al., « TrOCR: Transformer-based Optical Character Recognition with Pre-trained Models », arXiv 2109.10282, tableau 4, arxiv.org/abs/2109.10282
- OpenAI, guide images et vision, facturation en tokens, developers.openai.com
- Google, documentation Gemini API, traitement de documents, ai.google.dev
- Google Cloud, Document AI, tarifs et langues, septembre 2026, cloud.google.com
- Mindee, page tarifs, septembre 2026, mindee.com
Tests réalisés en septembre 2026 sur les trois documents décrits plus haut. Les chiffres publiés ont été vérifiés sur leurs sources primaires ; les tarifs des éditeurs changent souvent et sont à revérifier.
Nos retours terrain sur l'automatisation documentaire
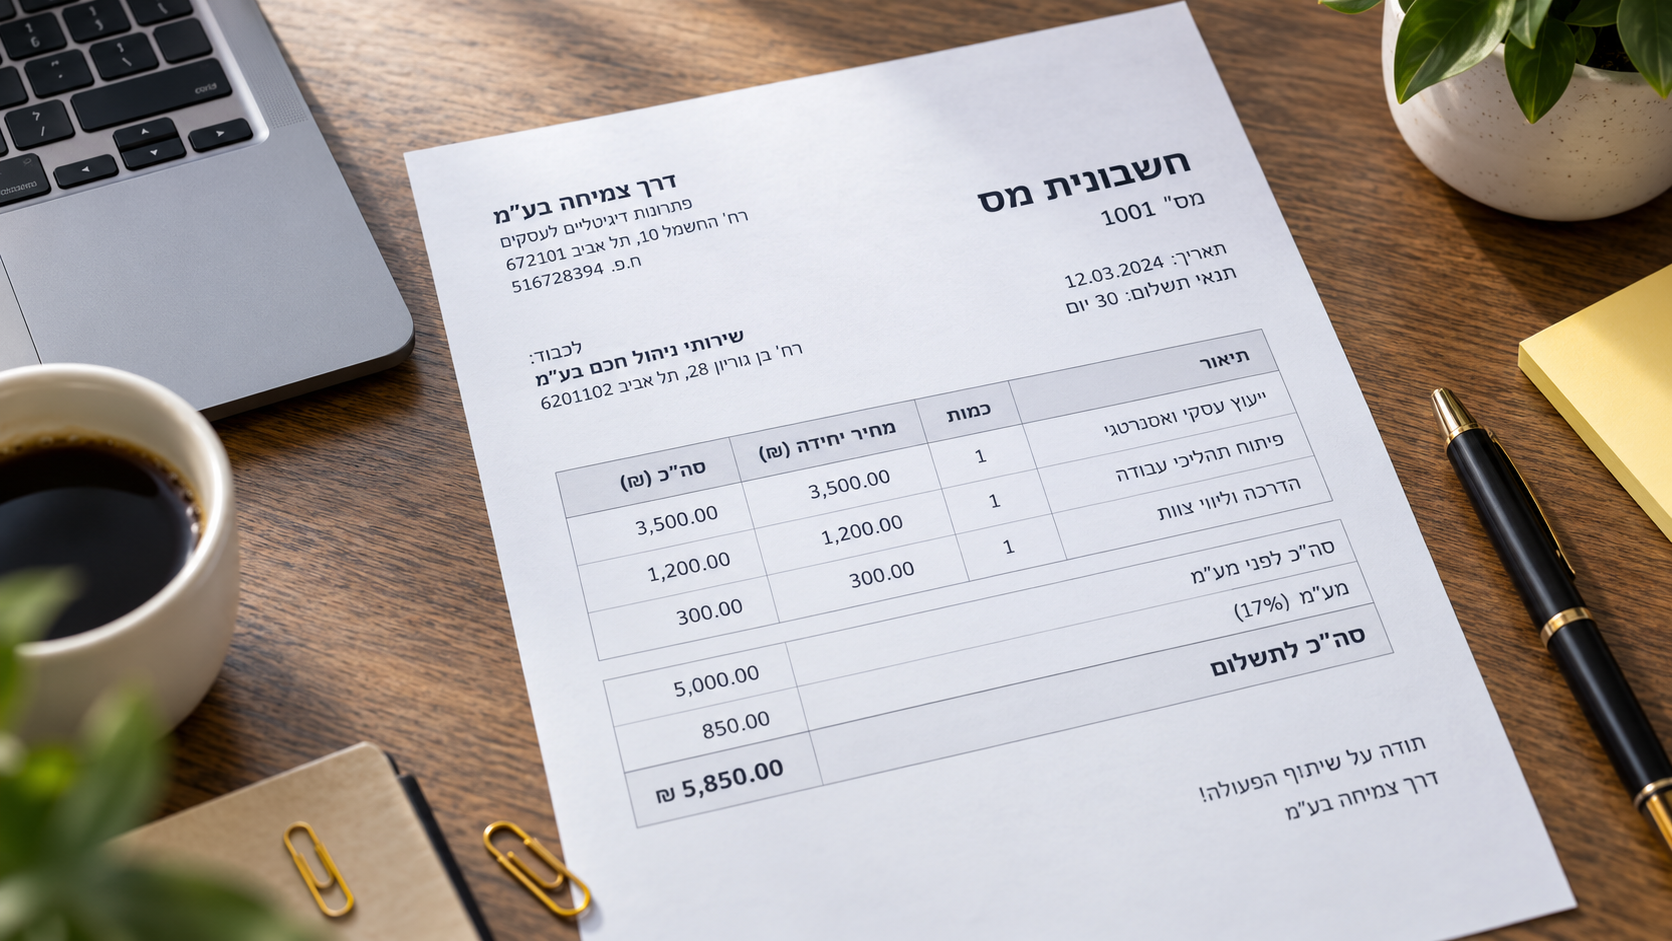
OCR hébreu : ce qui marche sur les documents professionnels
La plupart des éditeurs d'OCR annoncent prendre en charge l'hébreu. Beaucoup moins prennent en charge l'hébreu manuscrit, et aucun ne vous dit que 91 % de précision au caractère peut signifier qu'un mot sur deux est faux.
Détecter un faux relevé de compte : nos 9 méthodes
Le relevé de compte est un document particulièrement sujet à la fraude. Chez Koncile, on détecte jusqu'à 1,4 % de relevés modifiés ou altérés sur un jeu de 150 000 relevés. On parle beaucoup des deepfakes générés par l'IA, mais se focaliser uniquement là dessus aujourd'hui serait une erreur.
OCR par intelligence artificielle vs OCR classique : ce qui change vraiment pour vos documents
Un benchmark a mesuré la précision de Gemini 1.5 Pro sur des documents financiers à environ 50%, tandis que GPT-4o atteint 84% sur du contenu juridique. C'est ce que les discours «passez à l'OCR par intelligence artificielle» laissent de côté. Voici une comparaison factuelle entre OCR classique, IA généraliste et OCR par LLM dédié.
Les 10 meilleurs outils OCR Open Source en 2026
Le classement des OCR open source s'est inversé au cours des dix-huit derniers mois. Un modèle de 0,9 milliard de paramètres lit désormais les documents avec plus de précision qu'un modèle de 235 milliards de paramètres. PaddleOCR-VL obtient un score de 96,34 % sur OmniDocBench v1.6, tandis que Qwen3-VL-235B affiche 89,78 %. Voici les 10 meilleurs moteurs OCR open source en 2026 et comment choisir entre eux.
Top 10 des logiciels de détection de fraude documentaire en 2026
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.