<script type="application/ld+json">
{
"@context": "https://schema.org",
"@graph": [
  {
    "@type": "FAQPage",
    "mainEntity": [
      {
        "@type": "Question",
        "name": "Qu'est-ce que Tesseract OCR et comment ça fonctionne ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Tesseract est un moteur OCR open source capable d'extraire du texte depuis des images ou des PDF scannés. Il fonctionne en plusieurs étapes : détection des zones de texte, segmentation, et reconnaissance de caractères via des modèles entraînés, ce qui permet d'obtenir un texte exploitable."
        }
      },
      {
        "@type": "Question",
        "name": "Tesseract est-il toujours le meilleur OCR open source en 2026 ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Tesseract reste une référence parmi les OCR open source en 2026 pour du texte imprimé et des mises en page simples, sans nécessiter de GPU. Pour les documents complexes, les tableaux ou l'écriture manuscrite, les nouveaux modèles de vision-langage open source (olmOCR, DeepSeek-OCR-2, PaddleOCR-VL) offrent de meilleurs résultats, mais nécessitent un GPU."
        }
      },
      {
        "@type": "Question",
        "name": "Quels sont les principaux avantages de Tesseract OCR ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Tesseract est gratuit, open source, multilingue et largement documenté, avec une communauté active. Il s'intègre facilement dans des scripts et pipelines d'extraction, et permet aux équipes techniques de garder la maîtrise de leur infrastructure et de leurs coûts."
        }
      },
      {
        "@type": "Question",
        "name": "Quelles sont les limites de Tesseract OCR en production ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Tesseract montre ses limites sur les documents bruyants, les scans de mauvaise qualité, les mises en page complexes et les tableaux imbriqués. Il ne comprend pas nativement la structure métier d'un document et nécessite souvent un pré-traitement d'image avancé."
        }
      },
      {
        "@type": "Question",
        "name": "Quelles sont les alternatives OCR open source à Tesseract en 2026 ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "En 2026, les alternatives à Tesseract sont surtout des modèles de vision-langage open source : olmOCR, DeepSeek-OCR-2, dots.ocr, GLM-OCR, PaddleOCR-VL et la famille Qwen-VL. Ils lisent mieux les tableaux et l'écriture manuscrite, mais nécessitent un GPU, contrairement à Tesseract qui tourne sur CPU."
        }
      },
      {
        "@type": "Question",
        "name": "Tesseract OCR nécessite-t-il un prétraitement des images ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Oui, la qualité des résultats dépend fortement du prétraitement. Les images floues, sombres ou inclinées réduisent considérablement la précision. Un nettoyage préalable est souvent indispensable."
        }
      },
      {
        "@type": "Question",
        "name": "Tesseract OCR peut-il reconnaître l'écriture manuscrite ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Non, Tesseract est optimisé pour le texte imprimé. Il présente de faibles performances sur les écritures manuscrites, contrairement aux OCR modernes basés sur des modèles d'IA."
        }
      },
      {
        "@type": "Question",
        "name": "Tesseract fonctionne-t-il bien sur les tableaux et mises en page complexes ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Tesseract a des difficultés avec les tableaux, colonnes multiples et documents complexes. Il n'identifie pas la structure métier et produit souvent un texte désordonné sans traitement supplémentaire."
        }
      },
      {
        "@type": "Question",
        "name": "Comment installer et configurer Tesseract OCR en 2026 ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "L'installation varie selon le système (Windows, Linux ou macOS) via les gestionnaires de paquets ou les binaires officiels. Une configuration supplémentaire est souvent nécessaire pour les langues, le prétraitement ou l'intégration avec des scripts."
        }
      },
      {
        "@type": "Question",
        "name": "Quand privilégier un OCR basé sur l'IA plutôt que Tesseract ?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Un OCR basé sur l'IA est préférable pour des documents variés, avec tableaux complexes, formulaires ou écriture manuscrite, ou lorsqu'il faut extraire des informations précises plutôt que du texte brut. Ces modèles combinent vision par ordinateur et traitement du langage naturel pour comprendre le contexte."
        }
      }
    ]
  },
  {
    "@type": "Review",
    "name": "Analyse technique : Avantages et inconvénients de Tesseract OCR en 2026",
    "reviewBody": "Résumé complet des forces et faiblesses de Tesseract OCR basé sur son usage réel en production et sur les caractéristiques de ses versions récentes.",
    "author": {
      "@type": "Organization",
      "name": "Koncile"
    },
    "itemReviewed": {
      "@type": "SoftwareApplication",
      "name": "Tesseract OCR",
      "applicationCategory": "OCRSoftware",
      "operatingSystem": "Windows, macOS, Linux",
      "offers": {
        "@type": "Offer",
        "price": "0",
        "priceCurrency": "USD",
        "category": "free"
      },
      "aggregateRating": {
        "@type": "AggregateRating",
        "ratingValue": "4",
        "bestRating": "5",
        "ratingCount": "1"
      }
    },
    "reviewRating": {
      "@type": "Rating",
      "ratingValue": "4",
      "bestRating": "5"
    },
    "positiveNotes": {
      "@type": "ItemList",
      "itemListElement": [
        { "@type": "ListItem", "position": 1, "name": "Free and Open-Source" },
        { "@type": "ListItem", "position": 2, "name": "Multilingual Support" },
        { "@type": "ListItem", "position": 3, "name": "Good Accuracy" },
        { "@type": "ListItem", "position": 4, "name": "Easy Integration" },
        { "@type": "ListItem", "position": 5, "name": "Customization" },
        { "@type": "ListItem", "position": 6, "name": "Active Community" },
        { "@type": "ListItem", "position": 7, "name": "Flexible Formats" },
        { "@type": "ListItem", "position": 8, "name": "Mobile and Cloud Adaptability" },
        { "@type": "ListItem", "position": 9, "name": "Easy Automation" }
      ]
    },
    "negativeNotes": {
      "@type": "ItemList",
      "itemListElement": [
        { "@type": "ListItem", "position": 1, "name": "Preprocessing Dependency" },
        { "@type": "ListItem", "position": 2, "name": "Slow for Large Volumes" },
        { "@type": "ListItem", "position": 3, "name": "Complex Customization" },
        { "@type": "ListItem", "position": 4, "name": "Lack of Context Understanding" },
        { "@type": "ListItem", "position": 5, "name": "Works Only with Images" },
        { "@type": "ListItem", "position": 6, "name": "Custom Training is Difficult" },
        { "@type": "ListItem", "position": 7, "name": "Image Quality is Crucial" },
        { "@type": "ListItem", "position": 8, "name": "Handwriting Recognition Limitations" },
        { "@type": "ListItem", "position": 9, "name": "Complex User Interface" },
        { "@type": "ListItem", "position": 10, "name": "Language and Font Performance Fluctuations" },
        { "@type": "ListItem", "position": 11, "name": "Complex Layout Handling Issues" }
      ]
    }
  },
  {
    "@type": "HowTo",
    "name": "Comment choisir un OCR open source en 2026 ?",
    "description": "Guide simplifié pour déterminer si Tesseract ou une alternative open source est la meilleure solution selon vos besoins.",
    "step": [
      {
        "@type": "HowToStep",
        "position": 1,
        "name": "Définir les types de documents à traiter",
        "text": "Identifier si vos documents sont standardisés, manuscrits, scannés avec du bruit ou comportent des tableaux complexes."
      },
      {
        "@type": "HowToStep",
        "position": 2,
        "name": "Tester Tesseract sur un échantillon",
        "text": "Exécuter Tesseract sur un petit jeu de documents représentatifs pour évaluer la précision."
      },
      {
        "@type": "HowToStep",
        "position": 3,
        "name": "Analyser la qualité des scans",
        "text": "Vérifier si le prétraitement nécessaire est compatible avec vos contraintes de temps et de volume."
      },
      {
        "@type": "HowToStep",
        "position": 4,
        "name": "Comparer les limites identifiées",
        "text": "Si vos documents sont complexes, Tesseract peut nécessiter des traitements complémentaires."
      },
      {
        "@type": "HowToStep",
        "position": 5,
        "name": "Tester une alternative open source",
        "text": "Essayer d'autres moteurs comme Cune iForm ou des OCR basés sur l'IA pour comparer les résultats."
      },
      {
        "@type": "HowToStep",
        "position": 6,
        "name": "Sélectionner l'OCR adapté",
        "text": "Choisir la solution offrant le meilleur équilibre entre précision, vitesse, maintenance et coût."
      }
    ]
  }
]
}
</script>

Tesseract OCR : toujours le meilleur OCR open source en 2026 ?

Tesseract est-il encore le meilleur OCR open source en 2026 ? On analyse ses forces, faiblesses et alternatives.
Auteur et Co-fondateur Koncile
par 
Tristan Thommen
Dernière mise à jour : 
September 11, 2026
 - 
8 minutes

Parmi les nombreuses solutions disponibles sur le marché, Tesseract est souvent cité comme l'un des meilleurs logiciels OCR open source. Mais est-il toujours la meilleure solution en 2026 ? Nous analyserons ses performances, avantages, inconvénients et les alternatives OCR open-source.

Qu’est-ce que Tesseract OCR ?

Tesseract OCR est un moteur OCR capable de détecter et d'extraire du texte à partir d'images, permettant ainsi leur transformation en contenus numériques exploitables.

Initialement développé dans les années 1980 par Hewlett-Packard, ce projet a pris une nouvelle dimension depuis qu'il a été pris en charge par Google, qui en assure désormais le développement et la maintenance.

Tesseract est distribué sous licence Apache 2.0 : gratuit, et libre d'être utilisé, modifié ou redistribué sans demander d'autorisation à personne. En pratique, une entreprise peut l'intégrer dans son propre logiciel, l'adapter à ses documents, ou corriger elle-même un bug plutôt que d'attendre un correctif éditeur. C'est aussi ce qui explique sa longévité : plus de vingt ans après sa création, une communauté de développeurs continue de le maintenir.
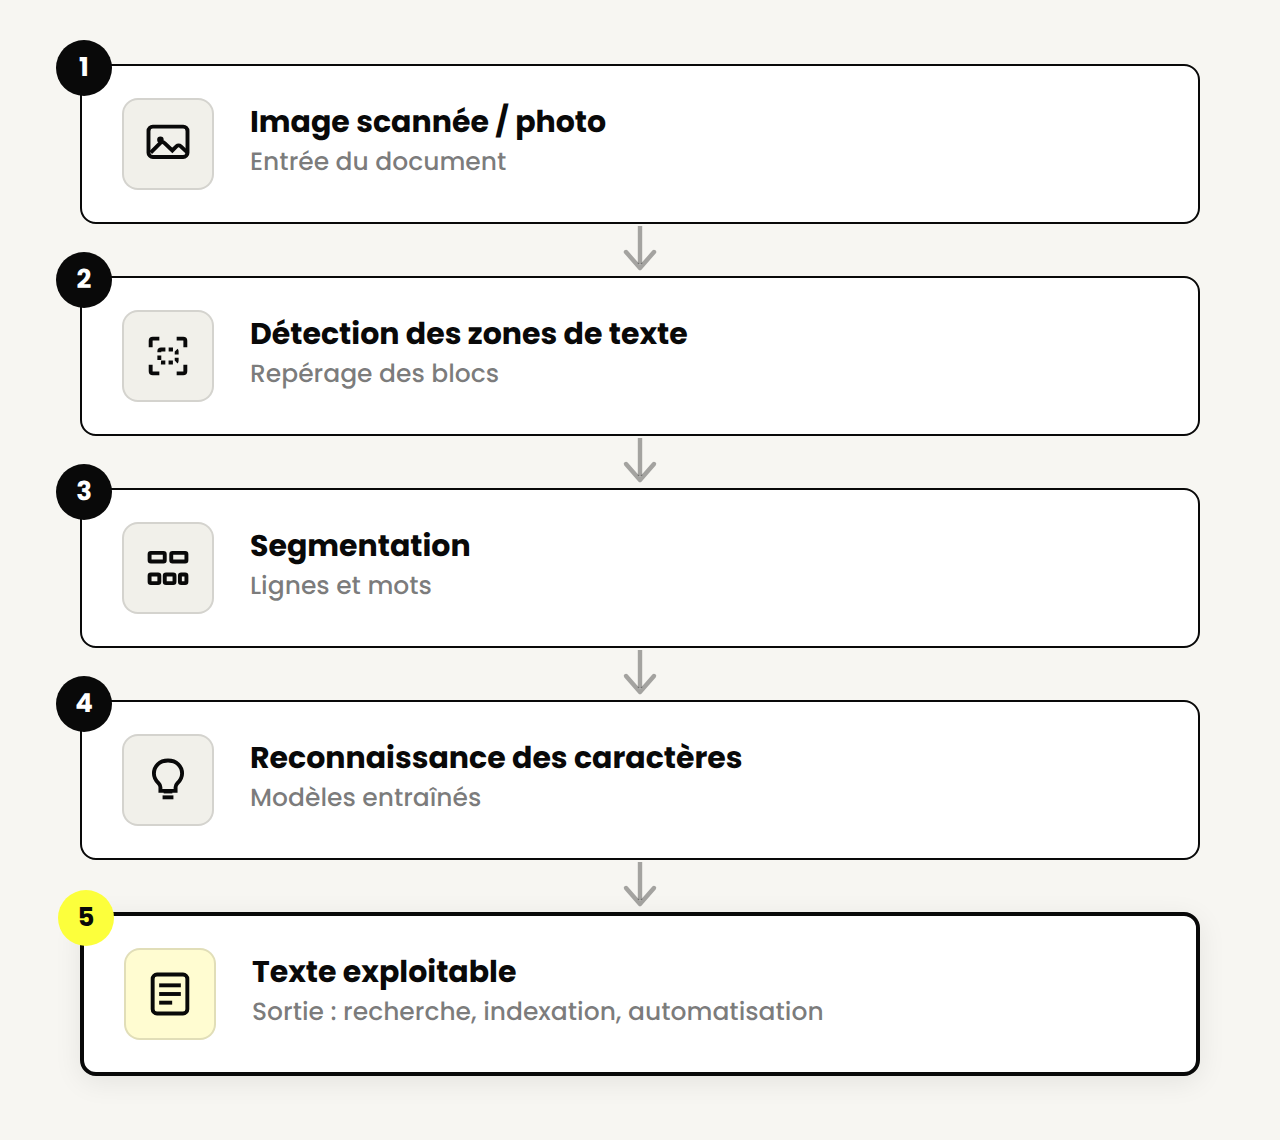
Les grandes étapes du traitement OCR, de l'image scannée au texte exploitable.

Ce que nous avons mesuré : Tesseract face à de vraies factures

Le paragraphe d'introduction promet une analyse des performances de Tesseract. Plutôt qu'une affirmation générale, voici le résultat d'un test que nous avons mené nous-mêmes.

Nous avons fait tourner Tesseract 5.3.4 sur 14 factures reconstituées à partir de mises en page réelles, avec des montants et des lignes de tableau connus à l'avance, volontairement dégradées pour imiter des conditions de scan courantes : bruit, flou léger, faible contraste, photocopie, tampon superposé au texte, et légère rotation. Pour chacune, nous avons vérifié si les totaux et les lignes de tableau attendus étaient retrouvés à l'identique dans le texte brut renvoyé par Tesseract, sans aucun post-traitement ni correction manuelle.

Sur ces 14 factures, Tesseract restitue correctement 81,4 % des 70 champs numériques vérifiés (totaux et lignes de tableau), en 0,44 seconde par page en moyenne, sur un seul thread CPU et sans GPU. Cette moyenne cache un écart net selon le type de dégradation : sur le bruit, le flou léger, une photocopie contrastée ou un tampon superposé au texte, Tesseract retrouve la quasi-totalité des valeurs (100 % dans nos tests). Mais dès qu'une facture est légèrement inclinée, 3 à 5 degrés, rien de plus, ce taux tombe à 31 %. Les colonnes de chiffres se désalignent et le moteur renvoie souvent un texte qui ne contient plus aucun montant, sans jamais signaler d'erreur.
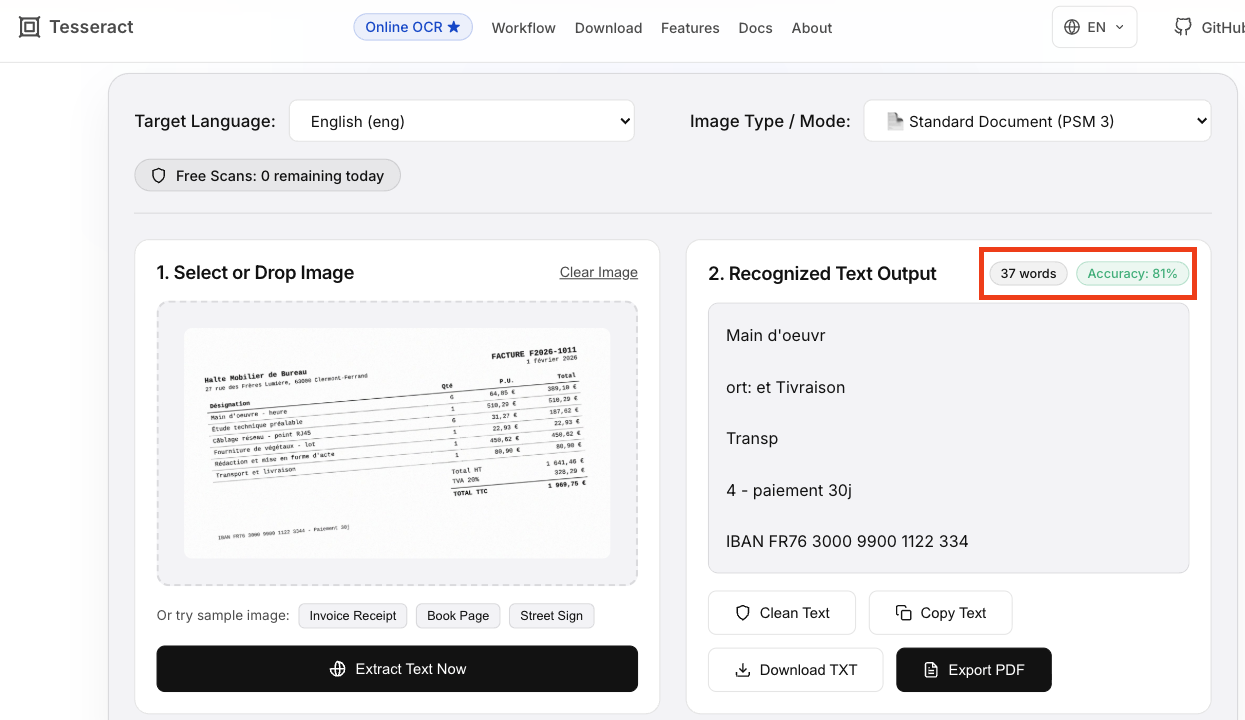
capture d'écran de la page web de Tesseract OCR
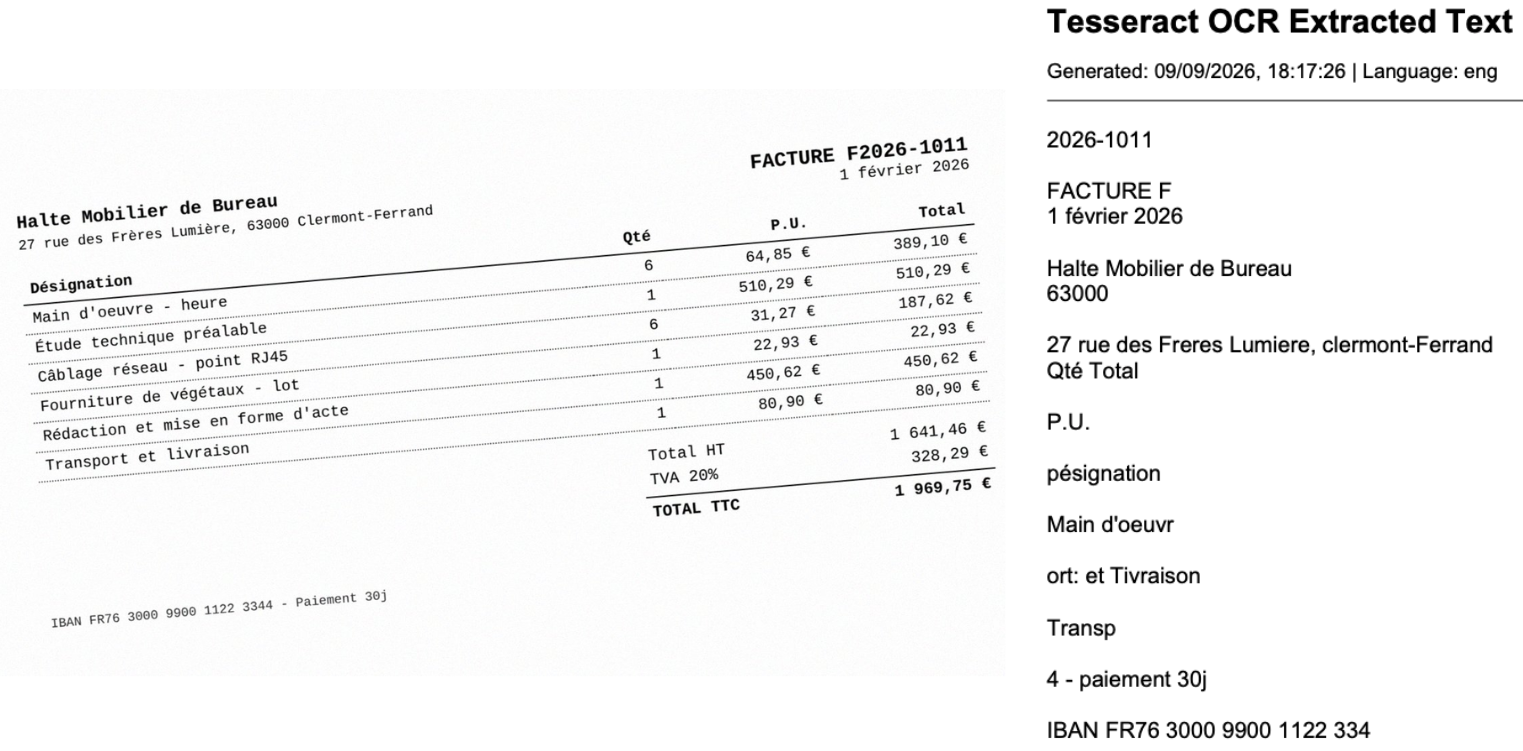
La facture originale à gauche, le texte brut extrait par Tesseract à droite
La facture originale à gauche, le texte brut extrait par Tesseract à droite : aucune ligne de tableau ni le total ne sont retrouvés.

Sur la facture ci-dessus, la rotation ne gêne en rien la lecture humaine, mais Tesseract ne retrouve aucune des six lignes de tableau ni le total de 1 969,75 €, sans émettre la moindre erreur. C'est le point aveugle le plus concret de l'OCR seul : le moteur ne sait jamais dire « je ne suis pas sûr » ou « j'ai échoué ». Sans contrôle humain ou logiciel de vérification en aval, ce type d'erreur silencieuse part directement en comptabilité.

Méthodologie : test mené en septembre 2026 sur un corpus reconstitué, et non sur des factures clients, pour des raisons de confidentialité, ce qui permettait aussi de disposer de valeurs de référence connues à l'avance pour chaque champ. Il ne remplace pas une mesure sur un corpus de production réel, que nous documenterons dans une prochaine mise à jour de cet article, mais donne un ordre de grandeur vérifiable, méthode et données ouvertes à la demande, plutôt qu'un chiffre marketing non sourcé.

Les avantages de l'OCR Tesseract

Les avantages de Tesseract tiennent en une idée : gratuit, éprouvé depuis vingt ans, et capable de tourner sans GPU ni infrastructure lourde.

Avantages Description
Gratuit et open source Entièrement gratuit à utiliser, idéal pour les projets à budget maîtrisé.
Support multilingue Prend en charge plus de 100 langues, adapté aux besoins internationaux.
Bonne précision Fiable sur des documents imprimés propres et bien scannés, dans la plupart des cas d'usage.
Intégration facile Compatible avec Python, C++, Java, C# et de nombreux environnements de développement.
Personnalisation Propose des paramètres ajustables pour adapter le comportement de l'OCR aux contraintes du projet.
Communauté active Mis à jour régulièrement grâce à un large écosystème open source mondial.
Flexibilité des formats Compatible avec différents formats d'image.
Compatible mobile et cloud Peut être déployé sur des environnements mobiles et des infrastructures cloud.
Adapté à l'automatisation S'intègre facilement dans des pipelines de traitement documentaire et d'IA.

Les inconvénients de l'OCR Tesseract

Les inconvénients de Tesseract se concentrent sur tout ce qui sort du texte imprimé propre : tableaux imbriqués, écriture manuscrite, mises en page complexes.

Inconvénients Description
Dépendance au prétraitement Nécessite un prétraitement soigné pour obtenir des résultats fiables.
Lent sur de gros volumes Plus lent que les OCR modernes et les solutions basées sur l'IA pour le traitement à grande échelle.
Personnalisation complexe Une configuration avancée nécessite une solide expertise technique.
Aucune compréhension du contexte Ne comprend pas le sens du document ni son contexte métier.
Traitement limité aux images Ne peut pas traiter les PDF natifs ni d'autres formats non image.
Entraînement personnalisé difficile Entraîner des modèles OCR sur mesure est complexe et chronophage.
Sensible à la qualité d'image La précision chute rapidement avec des scans flous, inclinés ou à faible contraste.
Faible sur l'écriture manuscrite Peu performant sur les textes manuscrits.
Interface complexe Aucune interface graphique ; nécessite des opérations en ligne de commande.
Limites de langues et de polices Les performances varient selon les langues ou polices peu courantes.
Mauvaise gestion des mises en page complexes Peine avec les mises en page multi-colonnes et les tableaux imbriqués.

Un point n'apparaît pas dans le tableau ci-dessus mais mérite d'être souligné pour les usages sensibles : Tesseract, comme tout moteur OCR pur, ne fait que lire du texte, sans aucune capacité à vérifier si le document scanné a été modifié, falsifié ou fabriqué. Pour les secteurs qui manipulent des pièces justificatives à forte valeur (assurance, banque, RH, immobilier), cette limite pousse à combiner l'OCR avec une couche de détection de fraude documentaire dédiée, capable d'analyser la structure du fichier et la cohérence des données extraites, pas seulement leur lisibilité.
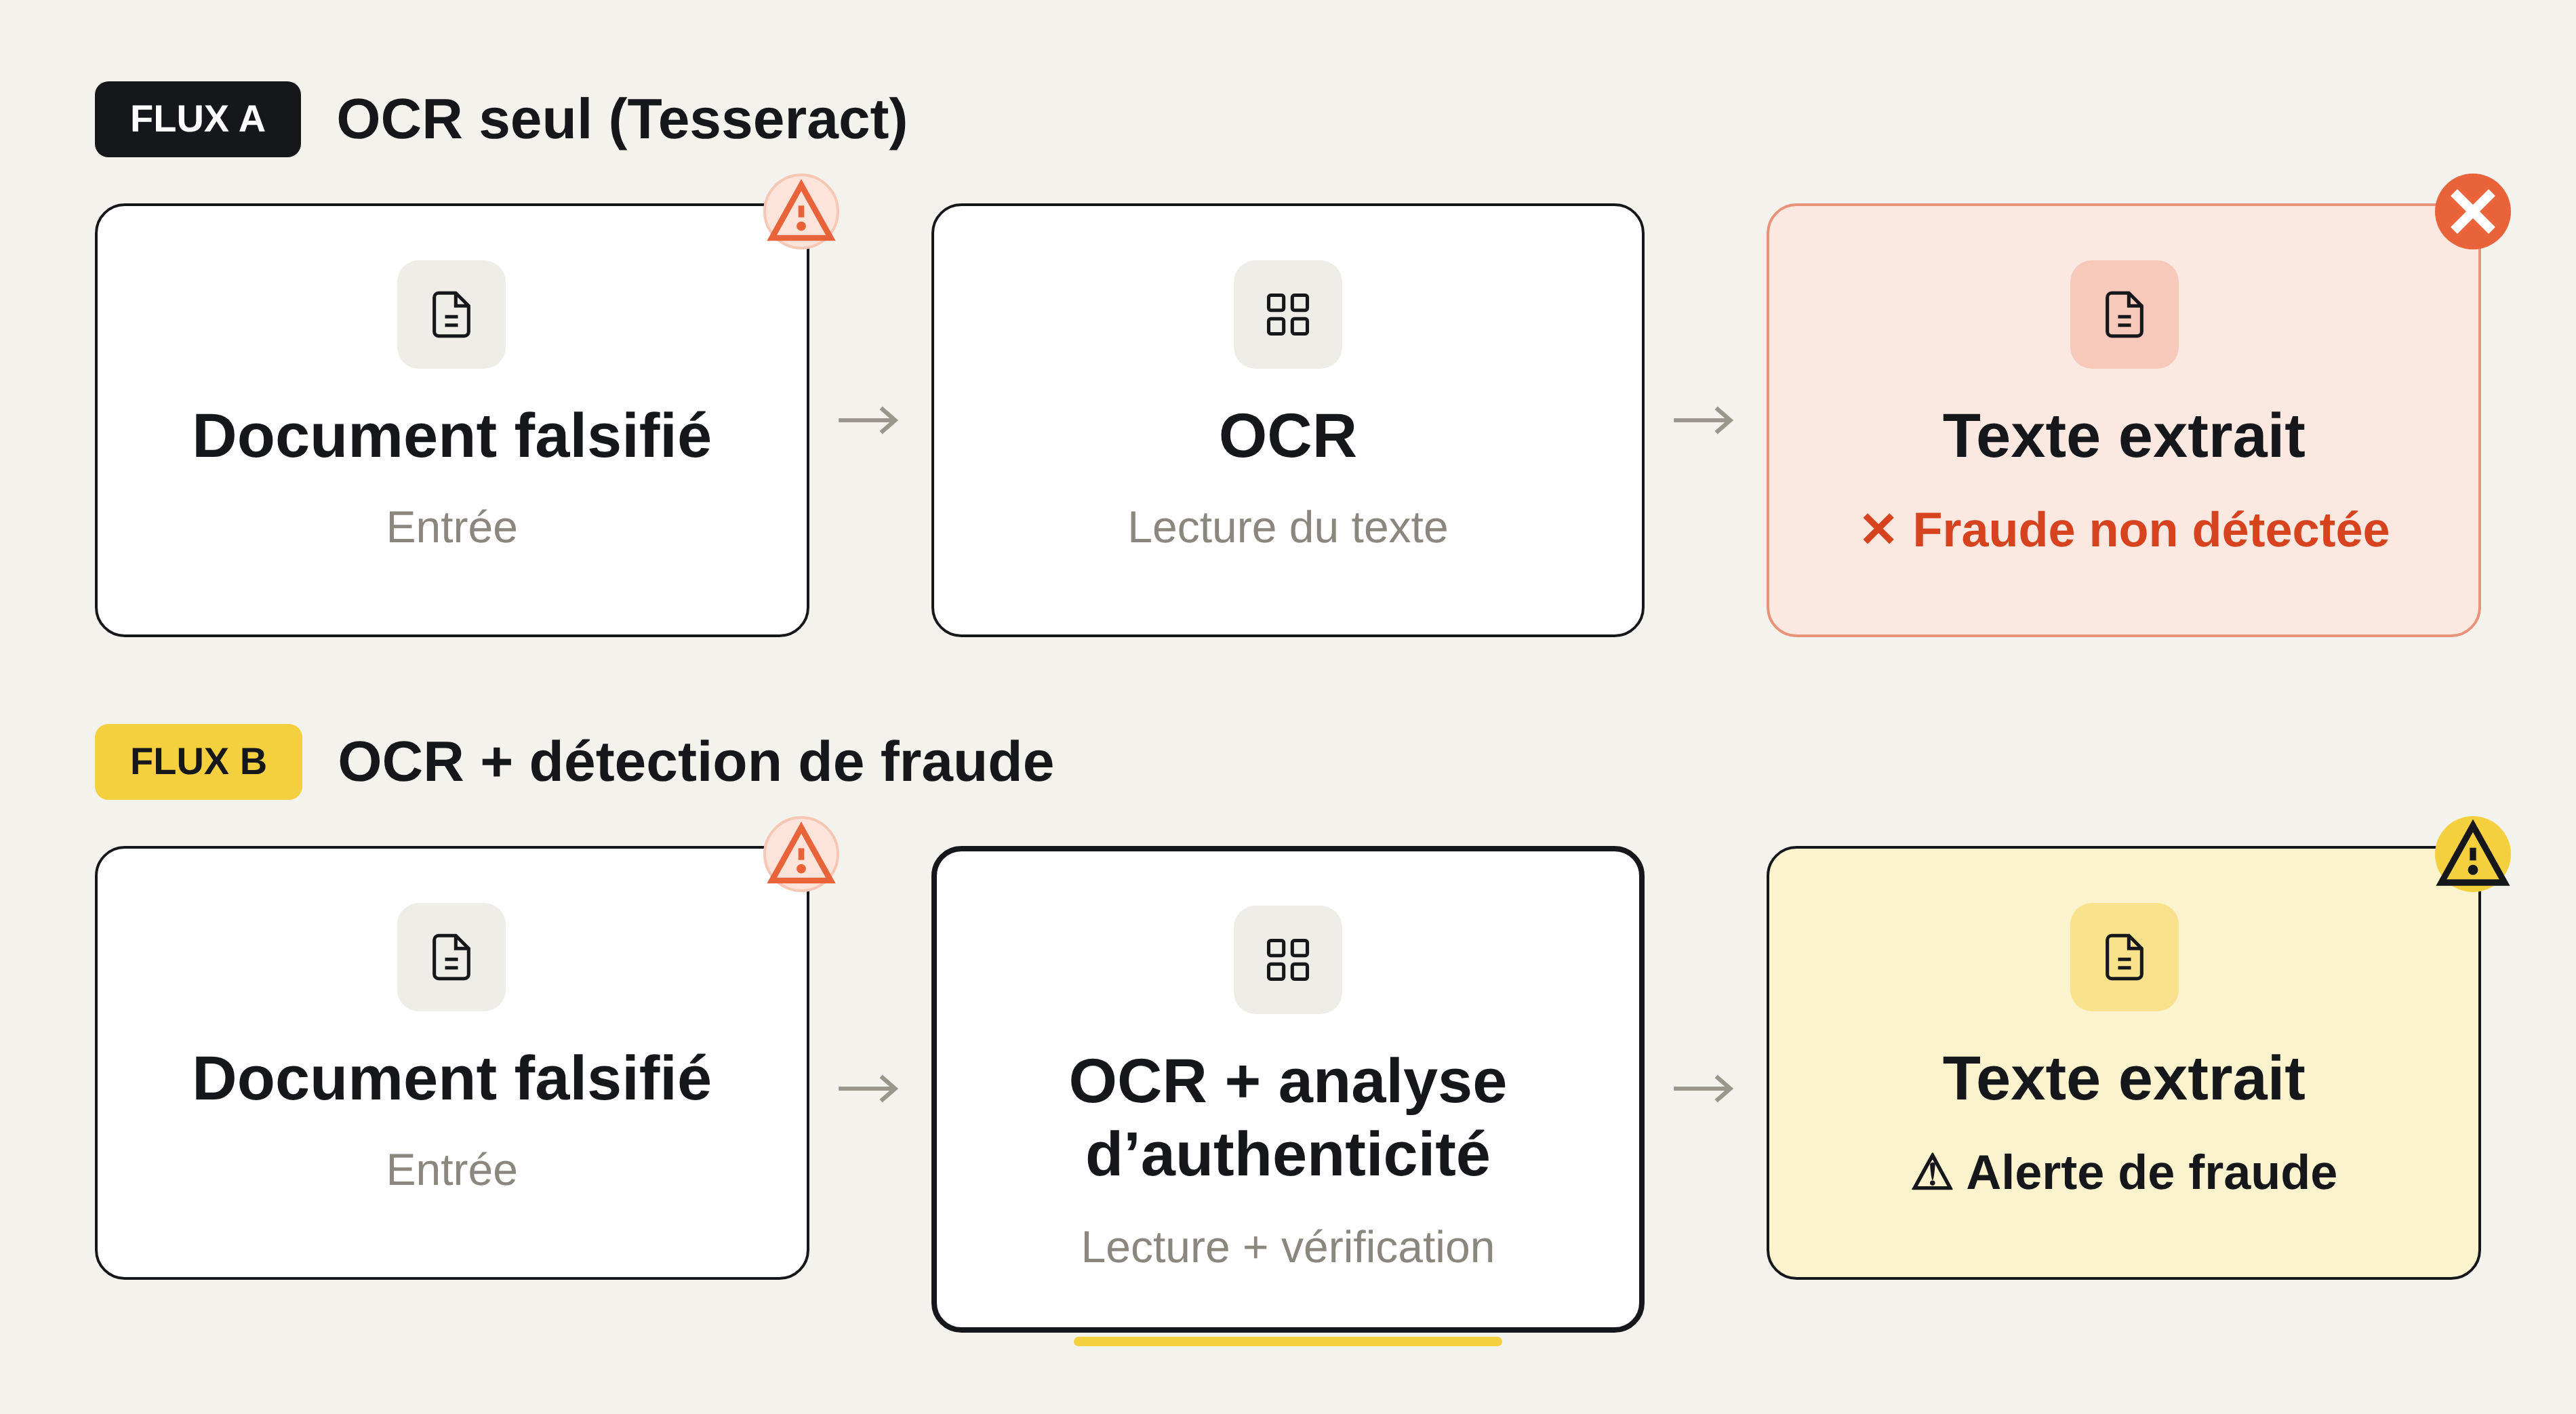
schéma de OCR seul vs OCR + détection de fraude
OCR seul vs OCR + détection de fraude, sur un même document falsifié.

Les alternatives OCR open source à Tesseract

Tesseract demeure l'une des solutions OCR open source les plus populaires et robustes en 2026, en particulier pour des applications standard d'extraction de texte sur des documents propres et imprimés, sans avoir besoin d'un GPU pour fonctionner. Cependant, ses limites sur les mises en page complexes, la reconnaissance manuscrite et la dépendance au prétraitement des images ont ouvert la voie, depuis 2025, à une nouvelle génération d'alternatives open source, des limites particulièrement visibles dans les cas nécessitant une reconnaissance fine des textes à la main, un domaine que nous comparons dans notre analyse dédiée aux OCR écriture manuscrite.

En 2026, les vraies alternatives à Tesseract ne sont plus des moteurs OCR classiques mais des modèles de vision-langage open source, olmOCR, PaddleOCR-VL et DeepSeek-OCR-2 en tête, qui lisent mieux les tableaux et l'écriture manuscrite, au prix d'un GPU. Avant le détail, voici la comparaison directe demandée par plusieurs lecteurs : les sept moteurs cités dans cet article, sur les mêmes critères.

Comparatif moteurs OCR
Moteur Sortie GPU nécessaire Tableaux Manuscrit Licence
Tesseract Open source depuis 2005 Non (CPU) Faible Faible Apache 2.0
olmOCR Février 2025 Oui (12 Go VRAM min.) Bon Bon Apache 2.0
dots.ocr Août 2025 Oui Moyen Non précisé MIT
Qwen-VL Septembre 2025 Oui (variable) Bon Non précisé Apache 2.0
PaddleOCR-VL Octobre 2025 Recommandé (CPU dégradé) Excellent Bon (limité cursif) Apache 2.0
DeepSeek-OCR-2 Janvier 2026 Oui Bon Non précisé MIT
GLM-OCR Mars 2026 Oui (léger, 0,9 Md param.) Bon Bon Apache 2.0

Sources : dépôts GitHub et Hugging Face officiels de chaque projet, consultés en septembre 2026. Tesseract (ligne surlignée) reste la seule solution du tableau à tourner sans GPU.

En 2026, ces alternatives ne sont plus des moteurs OCR classiques comme Tesseract, mais des modèles de vision-langage (VLM) open source : au lieu de repérer des caractères un par un, ils lisent une page comme une image entière, ce qui leur permet de bien mieux gérer les tableaux, l'écriture manuscrite et les mises en page complexes. La contrepartie est matérielle : là où Tesseract tourne sur un simple CPU, ces modèles ont besoin d'un GPU pour fonctionner dans des conditions raisonnables.

Plusieurs de ces modèles se sont imposés depuis 2025. PaddleOCR-VL, développé par Baidu sous licence Apache 2.0, reste le plus léger (0,9 milliard de paramètres) tout en obtenant d'excellents résultats sur les tableaux et les formules, nous comparons en détail sa version classique à Tesseract dans notre analyse PaddleOCR vs Tesseract. olmOCR, publié par l'Allen Institute for AI (AI2) sous licence Apache 2.0, mise sur un modèle plus lourd (7 milliards de paramètres, 12 Go de VRAM minimum) pour bien traiter les équations, les tableaux et le manuscrit. DeepSeek-OCR-2, sorti en janvier 2026, pousse plus loin la lecture des mises en page multi-colonnes et des formules complexes sur plus de 100 langues. dots.ocr, développé par le laboratoire chinois rednote-hilab sous licence MIT, reste très compact (1,7 milliard de paramètres) mais perd en précision sur les tableaux les plus denses. GLM-OCR, de Zhipu AI, descend à 0,9 milliard de paramètres tout en conservant de bons résultats sur l'extraction manuscrite. Et la famille Qwen-VL, publiée par Alibaba sous licence Apache 2.0, couvre l'OCR dans 32 langues avec plusieurs tailles de modèle selon la puissance disponible.

Mistral OCR est souvent cité dans le même contexte, mais n'appartient pas à cette catégorie : c'est une API propriétaire, pas un modèle open source distribuable ou auto-hébergeable, elle mise sur la même compréhension contextuelle, sans les poids du modèle ni la possibilité de l'installer soi-même.

C'est ce que proposent par ailleurs aujourd'hui les solutions d'intelligent document processing, qui associent OCR, compréhension contextuelle et automatisation des processus métier. La vraie question à se poser en 2026 n'est donc plus « Tesseract ou telle alternative », mais « CPU ou GPU » : Tesseract reste le bon choix pour des besoins standards, gratuits et sans infrastructure GPU à gérer, tandis que les VLM open source ou les solutions basées sur l'IA vont nettement plus loin sur les documents complexes, à condition de pouvoir héberger un GPU. Le choix dépendra donc moins de la marque que des priorités réelles, de la complexité des documents et de l'infrastructure disponible.

Concrètement, cela distingue deux usages. Pour de la recherche plein texte ou de l'archivage numérique, retrouver un mot dans un lot de PDF scannés, par exemple, Tesseract suffit largement, gratuitement et sans dépendance à un éditeur. Le relais devient nécessaire dès qu'il faut structurer l'extraction (retrouver la bonne ligne dans un tableau de facture, pas seulement du texte brut), rapprocher automatiquement un document avec un bon de commande ou un paiement, et vérifier qu'il n'a pas été modifié, trois besoins qu'aucun OCR pur, Tesseract inclus, ne couvre. C'est le positionnement de Koncile, qui revendique un taux de succès supérieur à 99 % sur les champs essentiels des factures et plus de 150 signaux de fraude documentaire détectés (chiffres communiqués par Koncile ; contrairement au test Tesseract détaillé plus haut dans cet article, l'entreprise ne publie pas la méthodologie de mesure derrière ces deux chiffres). Les deux piliers sont donc complémentaires : l'extraction structurée d'un côté, le contrôle d'authenticité de l'autre.

Pour aller plus loin, retrouvez notre sélection des 10 meilleurs logiciels OCR open source en 2026.

FAQ
FAQ – Tesseract est-il toujours le meilleur OCR open source en 2026 ?
Qu'est-ce que Tesseract OCR et comment ça fonctionne ?

Tesseract est un moteur OCR open source qui extrait le texte à partir d'images ou de PDF scannés. Il convertit les pixels en caractères en plusieurs étapes : détection des zones de texte, segmentation des lignes et des mots, puis reconnaissance des caractères via des modèles entraînés. Le résultat est un texte exploitable pour la recherche, l'indexation ou l'automatisation de traitements.

Tesseract est-il toujours le meilleur OCR open source en 2026 ?

Tesseract reste une référence parmi les OCR open source en 2026, surtout pour des cas d'usage standards avec du texte bien imprimé et des mises en page simples, sans avoir besoin de GPU. En revanche, pour des documents très structurés, des tableaux complexes ou de la reconnaissance manuscrite avancée, les nouveaux modèles de vision-langage open source (olmOCR, DeepSeek-OCR-2, PaddleOCR-VL, entre autres) offrent de meilleurs résultats, à condition de pouvoir héberger un GPU.

Quels sont les principaux avantages de Tesseract OCR ?

Tesseract est gratuit, open source et largement documenté, avec une communauté active. Il gère de nombreuses langues, s'intègre facilement dans des scripts ou pipelines d'extraction, et fonctionne bien sur des documents standards correctement scannés. Son modèle économique intéresse les équipes techniques qui souhaitent garder la maîtrise de leur infrastructure et de leurs coûts.

Quelles sont les limites de Tesseract OCR en production ?

Tesseract montre ses limites sur les documents bruyants, les scans de mauvaise qualité, les mises en page complexes ou les tableaux imbriqués. Il ne gère pas nativement la compréhension de la structure métier du document, nécessite souvent un pré-traitement d'image avancé et reste peu adapté à la reconnaissance manuscrite moderne.

Quelles sont les alternatives OCR open source à Tesseract en 2026 ?

En 2026, les vraies alternatives ne sont plus des moteurs OCR classiques mais des modèles de vision-langage open source : olmOCR (Allen Institute for AI), DeepSeek-OCR-2, dots.ocr, GLM-OCR, PaddleOCR-VL ou encore la famille Qwen-VL. Ils lisent les tableaux, l'écriture manuscrite et les mises en page complexes nettement mieux que Tesseract, mais nécessitent un GPU pour fonctionner efficacement, là où Tesseract tourne sur un simple CPU.

Quand privilégier un OCR basé sur l'IA plutôt que Tesseract ?

Un OCR basé sur l'IA est à privilégier lorsque les documents sont très variés, comprennent des tableaux complexes, des formulaires, des notes manuscrites, ou lorsqu'il faut extraire des informations précises plutôt que du simple texte brut. Ces solutions combinent vision par ordinateur et traitement du langage naturel pour comprendre le contexte et automatiser les workflows métier de bout en bout.

Les agents qui automatisent vos documents
Prenez les devants sur l’automatisation. Découvrez comment Koncile peut simplifier vos opérations.
Découvrir Koncile
Découvrir Koncile
Nos derniers articles

Nos retours terrain sur l'automatisation documentaire
Toutes les ressources
Top 10 des logiciels de détection de fraude documentaire en 2026
Comparatif

Top 10 des logiciels de détection de fraude documentaire en 2026

Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.

Lire l’article
Tesseract OCR : toujours le meilleur OCR open source en 2026 ?
Analyse

Tesseract OCR : toujours le meilleur OCR open source en 2026 ?

Parmi les nombreuses solutions disponibles sur le marché, Tesseract est souvent cité comme l'un des meilleurs logiciels OCR open source. Mais est-il toujours la meilleure solution en 2026 ? Nous analyserons ses performances, avantages, inconvénients et les alternatives OCR open-source.
Lire l’article
Des développeurs créent MacDoc, un outil illégal de création de faux passeports
actualité

Des développeurs créent MacDoc, un outil illégal de création de faux passeports

En février 2026, la justice américaine a fermé OnlyFake, un outil de génération de faux documents largement utilisé. Quelques semaines plus tard, un service identique a rouvert sous le nom de MacDoc. Ses faux parviennent à déjouer les contrôles “KYC” de grandes institutions comme Paypal, Airbnb ou Coinbase.
Lire l’article
Deepfakes documentaires : détecter les faux que vos contrôles laissent passer (2026)
FEATURE

Deepfakes documentaires : détecter les faux que vos contrôles laissent passer (2026)

En 2026, la fraude documentaire a un nouveau visage : le deepfake documentaire, un faux entièrement généré par IA. D'après l'Identity Fraud Index 2026 de Shufti, c'est la catégorie de fraude qui progresse le plus vite, avec une hausse annualisée estimée à près de 3 900 %. Leur particularité : ils sont propres en surface. Voici comment détecter ceux qui passent encore vos contrôles.
Lire l’article
5 meilleures solutions OCR françaises pour extraire vos données de documents
Comparatif

5 meilleures solutions OCR françaises pour extraire vos données de documents

Cinq solutions OCR françaises permettent aujourd'hui d'extraire automatiquement les données de vos factures, contrats et documents comptables grâce à la reconnaissance optique de caractères, avec un hébergement localisé en France. On les présente ici.

Lire l’article