OCR hébreu : ce qui marche sur les documents professionnels
Ce que les éditeurs d'OCR promettent vraiment sur l'hébreu, ce que disent les chiffres publiés, et les documents israéliens qui se vérifient tout seuls.
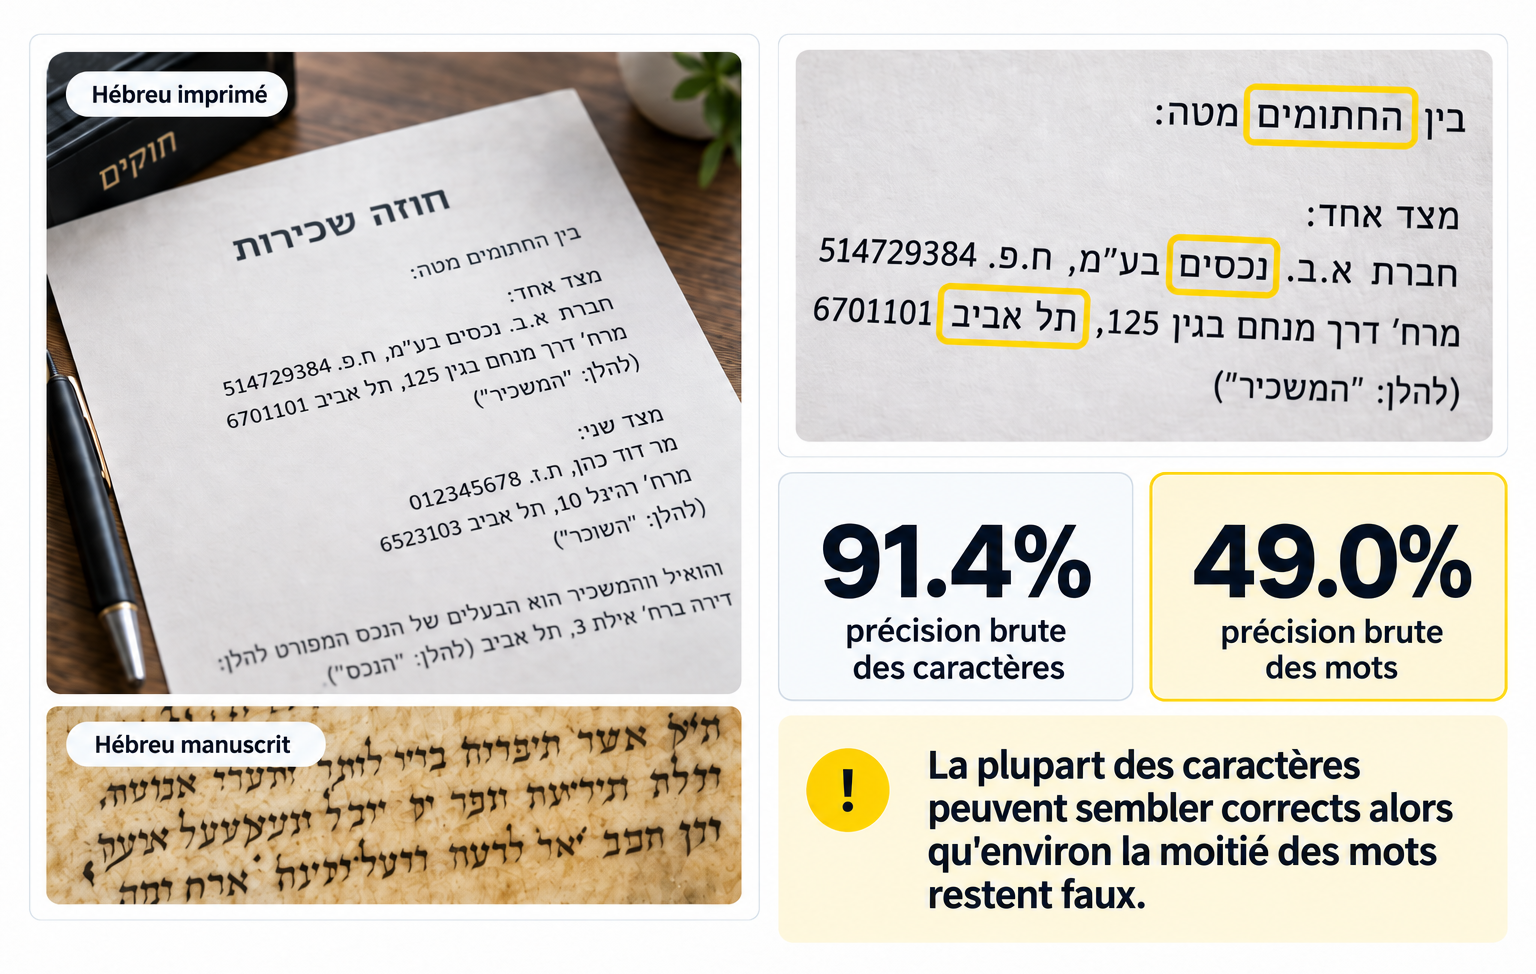
La plupart des éditeurs d'OCR annoncent prendre en charge l'hébreu. Beaucoup moins prennent en charge l'hébreu manuscrit, et aucun ne vous dit que 91 % de précision au caractère peut signifier qu'un mot sur deux est faux.
Depuis le 1er juin 2026, une facture fiscale israélienne au dessus de 5 000 shekels ne vaut rien pour l'acheteur sans un numéro d'allocation délivré par l'administration fiscale. Pas de numéro, pas de déduction de TVA.1 Ce numéro figure sur une page qui se lit de droite à gauche, à côté de texte hébreu, et il peut être vérifié auprès d'un service public. C'est exactement le type de champ qu'un pipeline documentaire devrait capter tout seul.
Regardons maintenant ce sur quoi les grands fournisseurs d'OCR s'engagent. Amazon Textract ne prend pas l'hébreu du tout.2 Google Cloud Vision lit l'hébreu imprimé, mais sa prise en charge du manuscrit couvre neuf écritures et l'hébreu n'en fait pas partie.3 Azure lit l'hébreu imprimé et s'arrête là.4 Cet article fait le tour de ce qui marche, de ce qui ne marche pas, et de ce que disent vraiment les chiffres publiés.
Ce que disent vraiment les chiffres publiés
Les résultats de l'OCR hébreu paraissent excellents ou catastrophiques selon la métrique qu'on lit, et l'écart entre les deux est toute l'histoire.
Sur l'écriture Rachi imprimée, un réseau AutoML atteint plus de 99,8% de précision à la lettre, avec un taux d'erreur descendu à 0,164% après affinage livre par livre.8 Sur des documents manuscrits, deux modèles publics Transkribus annoncent 4,4% et 4,36% de taux d'erreur par caractère, entraînés respectivement sur 159 000 mots de registres communautaires du dix neuvième siècle et un peu moins de 5 000 mots de registres funéraires séfarades.10 Ce sont de bons chiffres.
Regardez maintenant les journaux hébreux historiques de la collection JPress, numérisés à grande échelle. L'OCR brut atteint 91,44% de précision au caractère. Sur le même matériau, la précision au mot est de 48,98%.11
C'est le chiffre à retenir. Une page peut être juste à 91% au niveau du caractère et renvoyer quand même un champ inexploitable, parce qu'un champ est un mot ou un nombre, et qu'un seul caractère faux le détruit. Sur une facture, 91% de précision au caractère sur un numéro d'identité à neuf chiffres signifie qu'un numéro sur deux environ sera juste. Toute la discipline qui consiste à mesurer l'extraction au champ plutôt qu'au caractère existe pour cette raison.
Les modèles de vision de dernière génération ne comblent pas l'écart non plus. CHURRO, un benchmark de 2025 construit sur 155 corpus historiques et 46 groupes de langues, cite l'hébreu parmi les langues où tous les modèles peinent : sur son sous ensemble manuscrit, l'hébreu obtient 42,3% pour le modèle dédié et 30,4% pour Gemini 2.5 Pro, et l'étude note qu'un ensemble oracle n'atteint que 59,1% sur ce groupe de langues.12 La métrique y est une similarité normalisée et non un taux d'erreur par caractère, donc elle n'est pas comparable aux chiffres Transkribus, mais la direction ne fait aucun doute.
Pourquoi l'hébreu casse les OCR conçus pour le latin
Quatre propriétés de l'écriture causent l'essentiel des ennuis, et aucune n'est exotique.
1. Le sens de lecture: L'hébreu se lit de droite à gauche, et la norme Unicode impose aux implémentations conformes d'appliquer l'algorithme bidirectionnel.5 Cela compte parce que les vrais documents sont mixtes : une ligne de facture contient des mots hébreux, des références produit en caractères latins et des chiffres, chacun avec son propre sens. Une réorganisation ratée donne des caractères justes dans une chaîne fausse. Un montant inversé n'est pas une coquille, c'est un autre nombre.
2. Les formes finales: Cinq lettres changent de forme en fin de mot, et Unicode encode ces variantes comme des caractères distincts plutôt que de les déduire du contexte.5 Un moteur de reconnaissance a donc 27 classes et non 22, dont cinq sont les quasi jumelles de lettres qu'il doit déjà distinguer.
3. Les voyelles absentes: Les points voyelles, le niqqud, sont des signes combinants le plus souvent omis.5 Un mot se lit à partir de ses consonnes et du contexte. Deux conventions orthographiques coexistent, le ktiv male qui ajoute des lettres voyelles et le ktiv haser qui ne le fait pas, si bien que le même mot s'écrit légitimement avec un nombre de lettres différent. Tout dictionnaire ou modèle de langue calé sur une convention se trompe sur l'autre. Les textes liturgiques ajoutent par dessus les signes de cantillation, une trentaine, placés au dessus, en dessous ou entre les lettres.6
4. Les lettres qui se ressemblent: Ce n'est pas un problème théorique. Quand Eliyahu Koren a dessiné son caractère pour la Bible dans les années 1950, il cherchait à séparer les paires que les lecteurs confondent, et les trois qu'il a nommées sont bet et kaf, gimel et nun, dalet et resh.7 Une étude mesurée de l'OCR sur l'écriture Rachi a trouvé ses propres pires confusions : nun avec kaf, tet avec ayin, samekh avec mem, tav avec het.8 En manuscrit c'est pire : le trait du dalet a été mis en oblique précisément pour le séparer du resh, et à l'écriture rapide il y revient quand même.9
Ajoutez les caractères typographiques. L'écriture Rachi, une semi cursive séfarade fondue en caractères au quinzième siècle, porte l'essentiel du commentaire rabbinique et a été imprimée sur plus de cinq cents ans par des fonderies variées.8 L'écriture manuscrite moderne est la cursive ashkénaze, encore un autre alphabet pour un modèle entraîné sur de l'imprimé carré.
Quels outils prennent l'hébreu, et lesquels prennent l'hébreu manuscrit
Les éditeurs répondent oui à « prenez vous l'hébreu ? » bien plus souvent qu'à « prenez vous l'hébreu manuscrit ? ». Voici ce que dit leur propre documentation.
Trois conséquences. Si vos documents sont en hébreu manuscrit, les clouds généralistes ne sont pas des candidats et un modèle entraîné pour la tâche l'est. Si vos documents sont en hébreu imprimé avec diacritiques, vérifiez les diacritiques spécifiquement plutôt que de les supposer inclus dans la langue. Et si vous faites tourner Tesseract depuis un paquet Linux, vous utilisez presque certainement la variante rapide, qui échange de la précision contre de la taille.13
Les documents hébreux qui portent vraiment l'activité
Les archives et les manuscrits captent l'attention de la recherche. Le volume est ailleurs, et il est plus abordable, parce que les documents métier portent des champs qui se vérifient tout seuls.
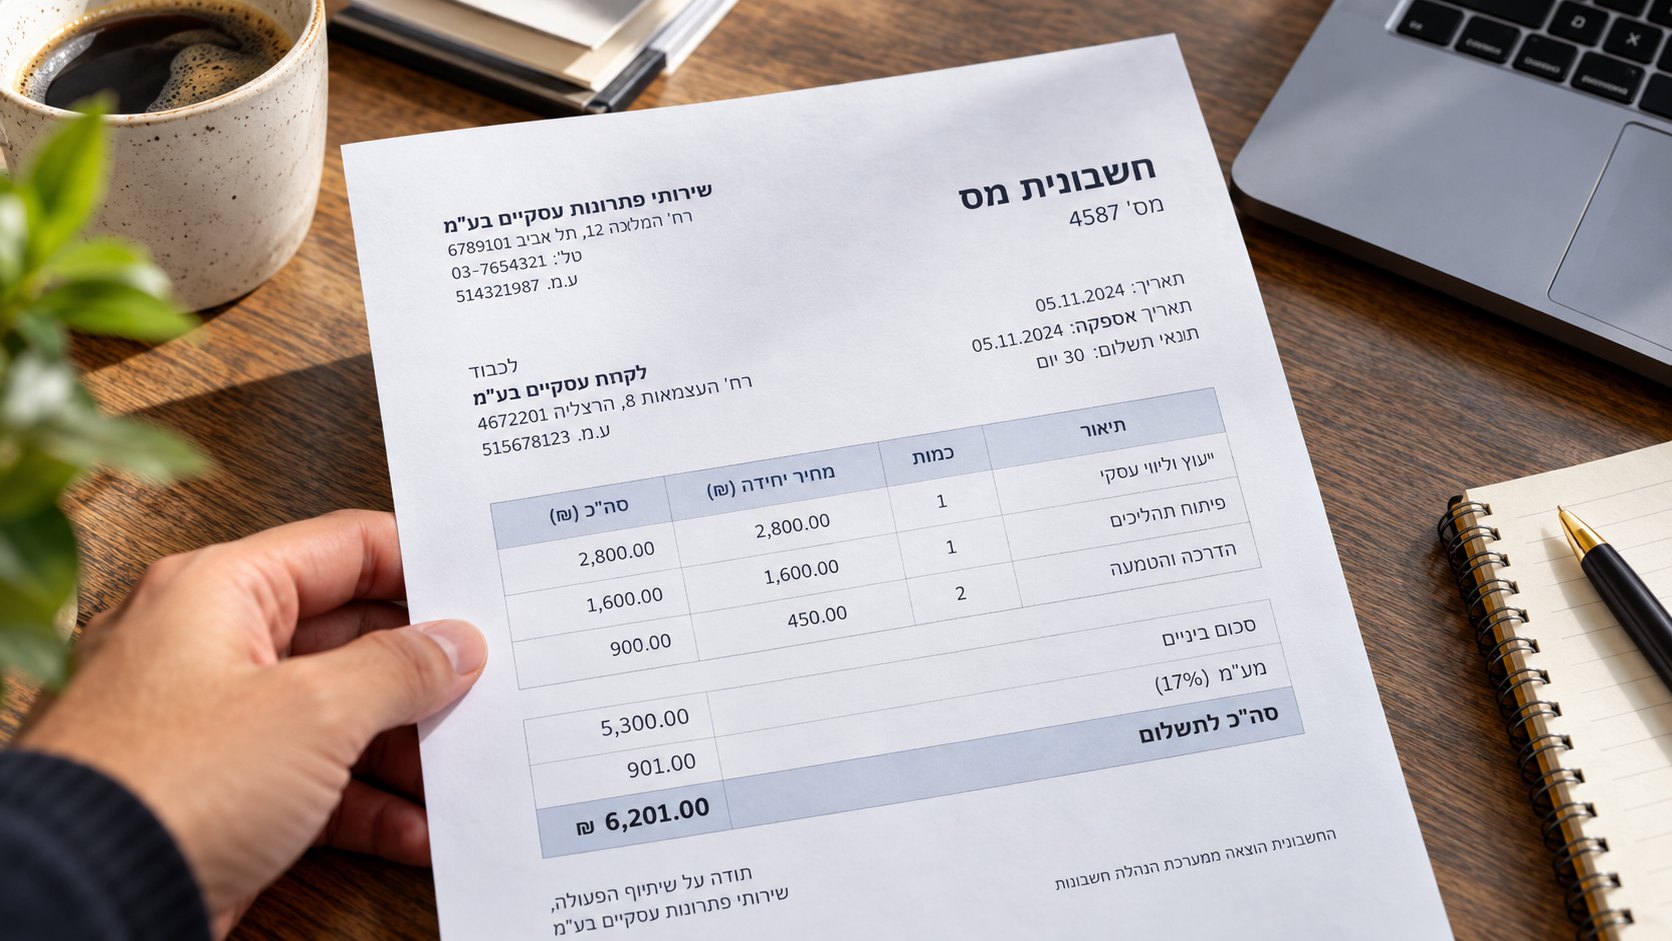
i) La facture fiscale. La réforme du numéro d'allocation, baptisée Invoice Israel, conditionne la déduction de la TVA en amont à la présence sur la facture d'un numéro délivré par l'administration fiscale. Le seuil est passé de 20 000 shekels en 2025 à 10 000 en janvier 2026 puis 5 000 en juin 2026, en sautant une étape intermédiaire prévue et en arrivant des années avant l'échéance de 2028 annoncée au départ.14 À 5 000 shekels, la mesure couvre l'essentiel du commerce entre entreprises. L'administration fiscale publie aussi un service de vérification de ce numéro,1 ce qui veut dire qu'un pipeline d'extraction peut lire le champ puis le confirmer, au lieu de faire confiance à sa propre lecture.
ii) La carte d'identité. La teudat zehut est imprimée en hébreu et en arabe, porte un numéro à neuf chiffres dont le dernier est une clé de contrôle calculée par l'algorithme de Luhn, et affiche les dates dans les calendriers grégorien et hébraïque.15 La clé de contrôle est le point important : un chiffre mal lu casse l'arithmétique, donc le pipeline sait qu'il s'est trompé sans qu'un humain regarde. Notre modèle d'extraction de documents d'identité applique exactement ce genre de contrôle.
iii) Le bulletin de paie. L'amendement 24 à la loi israélienne sur la protection du salaire impose depuis février 2009 un bulletin détaillé pour chaque salarié, et l'omission des mentions obligatoires constitue une infraction pénale assortie d'une amende.16 Cela fait des bulletins de paie hébreux une classe de documents normalisée par la loi, à fort volume et structurée, c'est à dire la plus facile à bien automatiser.
La même logique vaut pour les relevés de compte et les reçus. Aucun de ces documents n'exige une reconnaissance de caractères parfaite. Ils exigent une lecture vérifiable.
Comment fiabiliser l'extraction en hébreu
L'approche qui marche n'est pas un meilleur moteur OCR hébreu. C'est un pipeline qui part du principe que la lecture est parfois fausse et qui est construit pour s'en apercevoir.
Koncile est une plateforme d'extraction documentaire par IA plutôt qu'un moteur OCR. Les champs se décrivent en langage naturel, donc un modèle de facture hébraïque est écrit par ceux qui lisent ces factures, sans gabarit à entraîner ni produit supplémentaire à acheter pour un nouveau type de document. Les documents sont classés avant extraction, pour qu'une facture et un bulletin de paie n'aillent pas au même lecteur. Chaque valeur extraite porte un score de confiance, ce qui transforme un champ hébreu incertain en élément à relire plutôt qu'en erreur silencieuse, et le texte manuscrit est typé dans son propre champ au lieu d'être mélangé à l'imprimé.
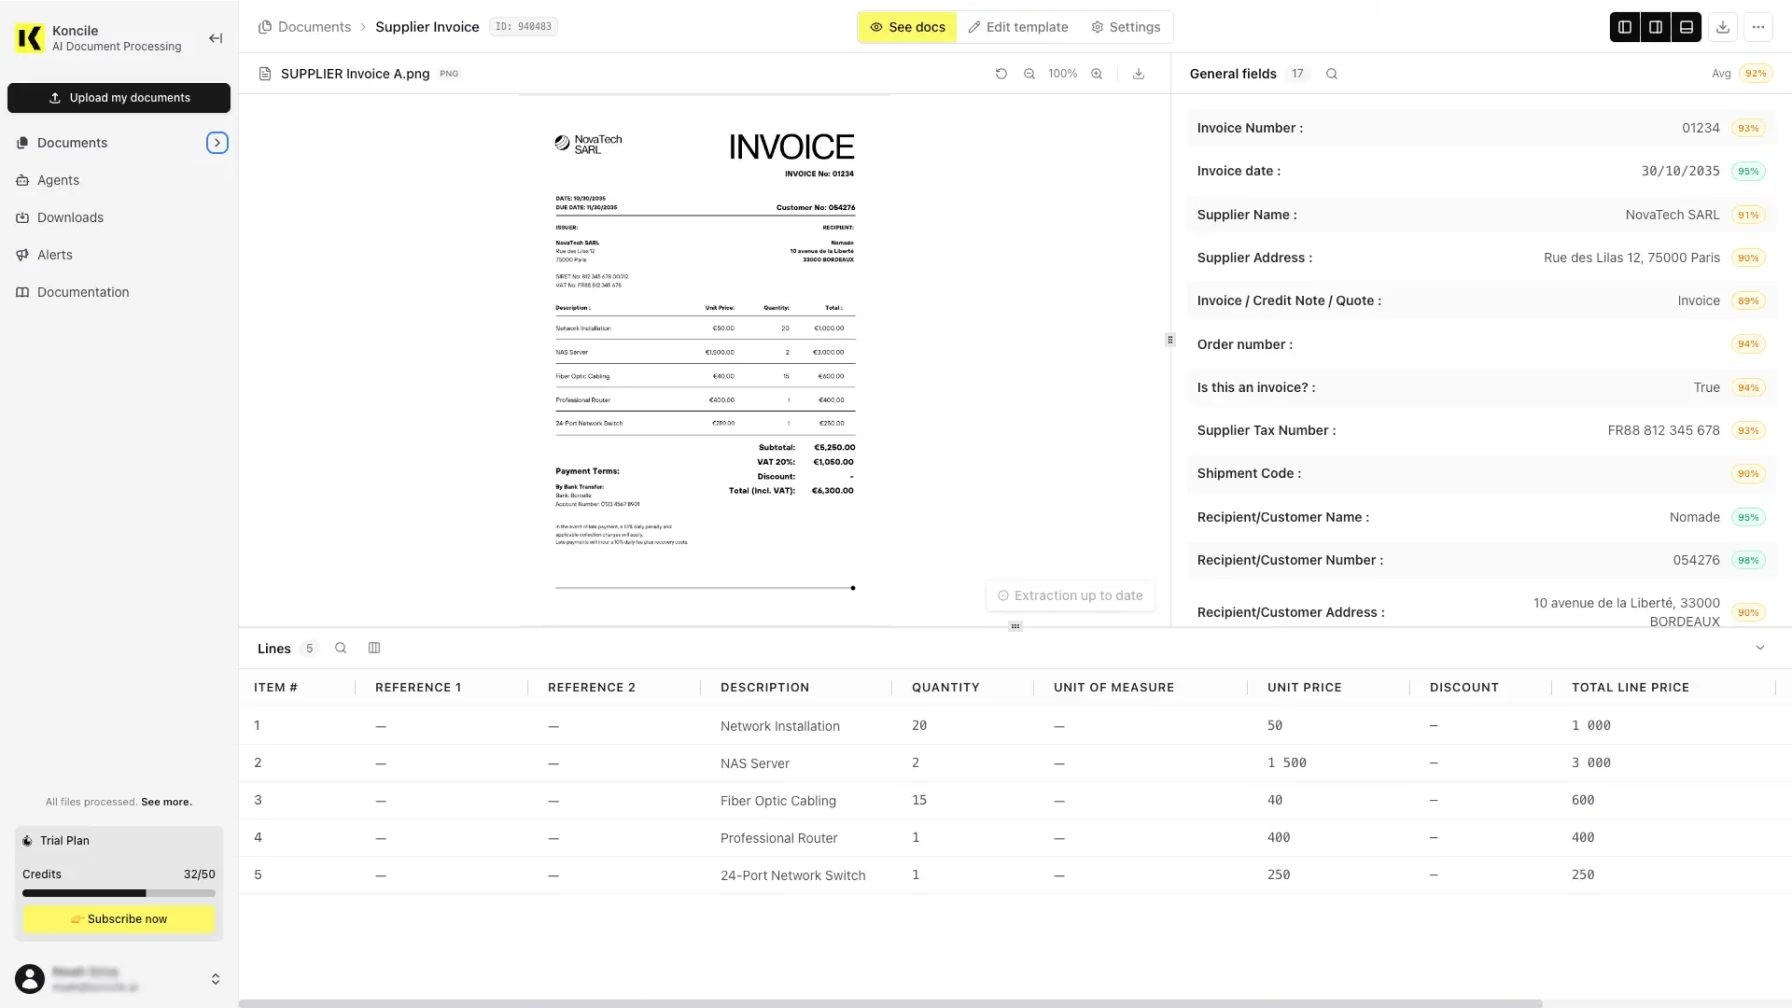
Par dessus viennent les règles métier : recalculer la TVA à partir des lignes, passer la clé de Luhn sur un numéro d'identité, vérifier un numéro d'allocation auprès du service fiscal, confronter le nom d'une pièce à celui d'une autre. C'est cette couche qui transforme 91% de précision au caractère en un processus exploitable, et c'est la même que celle derrière notre détection de fraude documentaire, qui vérifie si un document a été altéré et pas seulement ce qu'il dit.
La limite, dite franchement : aucun éditeur, nous compris, ne devrait vous promettre l'hébreu manuscrit au niveau où il promet l'imprimé latin. Testez sur vos propres documents, mesurez au champ, et regardez le taux de relecture plutôt que le chiffre de précision mis en avant.
Questions fréquentes
Sources
- Administration fiscale israélienne, gov.il, demande de numéro d'allocation pour une facture fiscale, consulté en septembre 2026.
- Amazon Web Services, quotas et limites Amazon Textract, langues prises en charge.
- Google Cloud, langues prises en charge par Cloud Vision, tables imprimé et manuscrit.
- Microsoft Learn, Azure AI Document Intelligence, langues prises en charge.
- Consortium Unicode, Unicode 17.0 Core Specification, chapitre 9.
- Cantillation hébraïque, signes encodés de U+0591 à U+05AF.
- Koren Type, les paires de lettres qu'Eliyahu Koren cherchait à séparer.
- Mahpod et Keller, Auto-ML deep learning for Rashi scripts OCR, arXiv 1811.01290, université Bar Ilan, 2018.
- Hébreu cursif, le problème du dalet et du resh à l'écriture rapide.
- Transkribus, modèles pour l'hébreu et le yiddish manuscrits, 5 novembre 2025.
- Suissa, Zhitomirsky-Geffet et Elmalech, correction d'erreurs OCR sur des textes hébreux historiques, arXiv 2307.16213, 2023.
- CHURRO, modèle de vision et langage pour la reconnaissance de textes historiques, arXiv 2509.19768, 2025.
- Tesseract, dépôt tessdata, les trois variantes de modèles.
- Herzog Fox & Neeman, panorama des évolutions de TVA applicables en 2026, 11 janvier 2026 ; Sovos, calendrier accéléré du numéro d'allocation, 9 décembre 2025.
- Carte d'identité israélienne, numéro à neuf chiffres avec clé de Luhn.
- Afik & Co., entrée en vigueur de l'amendement 24 à la loi sur la protection du salaire, février 2009.
Documentation des éditeurs consultée en septembre 2026. La prise en charge des langues et les tarifs changent souvent et sont à revérifier avant de s'y fier.
Nos retours terrain sur l'automatisation documentaire
OCR hébreu : ce qui marche sur les documents professionnels
La plupart des éditeurs d'OCR annoncent prendre en charge l'hébreu. Beaucoup moins prennent en charge l'hébreu manuscrit, et aucun ne vous dit que 91 % de précision au caractère peut signifier qu'un mot sur deux est faux.
Détecter un faux relevé de compte : nos 9 méthodes
Le relevé de compte est un document particulièrement sujet à la fraude. Chez Koncile, on détecte jusqu'à 1,4 % de relevés modifiés ou altérés sur un jeu de 150 000 relevés. On parle beaucoup des deepfakes générés par l'IA, mais se focaliser uniquement là dessus aujourd'hui serait une erreur.
OCR par intelligence artificielle vs OCR classique : ce qui change vraiment pour vos documents
Un benchmark a mesuré la précision de Gemini 1.5 Pro sur des documents financiers à environ 50%, tandis que GPT-4o atteint 84% sur du contenu juridique. C'est ce que les discours «passez à l'OCR par intelligence artificielle» laissent de côté. Voici une comparaison factuelle entre OCR classique, IA généraliste et OCR par LLM dédié.
Les 10 meilleurs outils OCR Open Source en 2026
Le classement des OCR open source s'est inversé au cours des dix-huit derniers mois. Un modèle de 0,9 milliard de paramètres lit désormais les documents avec plus de précision qu'un modèle de 235 milliards de paramètres. PaddleOCR-VL obtient un score de 96,34 % sur OmniDocBench v1.6, tandis que Qwen3-VL-235B affiche 89,78 %. Voici les 10 meilleurs moteurs OCR open source en 2026 et comment choisir entre eux.
Top 10 des logiciels de détection de fraude documentaire en 2026
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.