Détecter un faux relevé de compte : nos 9 méthodes
Neuf méthodes pour détecter un relevé bancaire falsifié, généré ou modifié par l'IA, tirées de l'analyse de 150 000 relevés.
Le relevé de compte est un document particulièrement sujet à la fraude. Chez Koncile, on détecte jusqu'à 1,4 % de relevés modifiés ou altérés sur un jeu de 150 000 relevés. On parle beaucoup des deepfakes générés par l'IA, mais se focaliser uniquement là dessus aujourd'hui serait une erreur.
Les faux que l'on rencontre sur les relevés de compte sont de nature très diverse. Les faux entièrement générés par IA, où le document complet est créé de toutes pièces par une intelligence artificielle, restent une minorité des cas observés. On y trouve ensuite des faux natifs générés par IA, c'est à dire des PDF en apparence authentiques produits directement en format numérique, ainsi que des altérations d'image, des captures ou scans retouchés à l'aide d'outils de type Photoshop, légèrement plus nombreuses.
Viennent ensuite les faux issus de « template farms », des documents reconstruits à partir de gabarits imitant les relevés des principales banques, et les documents modifiés puis rescannés, un fichier falsifié, imprimé et rescanné pour effacer les traces numériques de la manipulation.
Enfin, et de loin en tête, on trouve les PDF natifs édités via des outils de modification de PDF (Adobe Acrobat, éditeurs en ligne, ou désormais l'IA), la technique la plus répandue car très accessible.
Comment les faux relevés sont fabriqués
Répartition des falsifications par mode opératoire
On présente ici 9 méthodes qu'il est possible de déployer afin de détecter la falsification. L'objectif était de se mettre dans l'état d'esprit des fraudeurs, en pensant à leurs outils, leurs capacités et leurs intentions.
On répond également aux questions : (i) est ce que c'est accessible techniquement, notamment grâce à l'IA, (ii) est ce que cela requiert une masse de relevés importante a priori, et (iii) le temps de développement et de déploiement (est ce que le passage à l'échelle est facile). Ces méthodes et technologies reposent sur une analyse de 150 000 relevés de compte, dont 36 % de documents scannés et 64 % de documents natifs (c'est à dire en format numérique, non pris en photo), essentiellement d'Union européenne et des États-Unis.
À qui s'adresse cette méthode
Avant de commencer, on indique que cette méthode peut fonctionner pour une détection individuelle de fraude : vous avez quelques relevés et vous souhaitez avoir une opinion fiable sur l'authenticité du document. Mais elle est surtout destinée aux entreprises qui veulent réaliser de la détection de fraude à grande échelle.
Pourquoi c'est différent ? Car tout ne se voit pas à l'œil nu, et cela nécessite parfois un programme informatique (script). Mais également car l'objectif final est bien d'avoir un score qui va combiner chacune de ces différentes méthodes.
Tous les exemples de faux proposés dans cet article sont issus d'une base réelle, donc véridiques. Ils ont néanmoins été caviardés et anonymisés.
Méthode 1. Détecter des incohérences contextuelles
Le premier réflexe que l'on peut avoir pour contrôler le relevé de compte : vérifier la cohérence mathématique des transactions, par exemple en additionnant l'ensemble des lignes en débit et en crédit pour vérifier leur cohérence avec les totaux calculés par la banque. Le fraudeur aurait tout simplement oublié de mettre à jour la totalité du relevé. C'est fréquent, on le voit sur 9 relevés dans notre base. Dans la même logique, il est possible de contrôler les sommes des débits et des crédits qui sont cumulées en bas de chaque page.
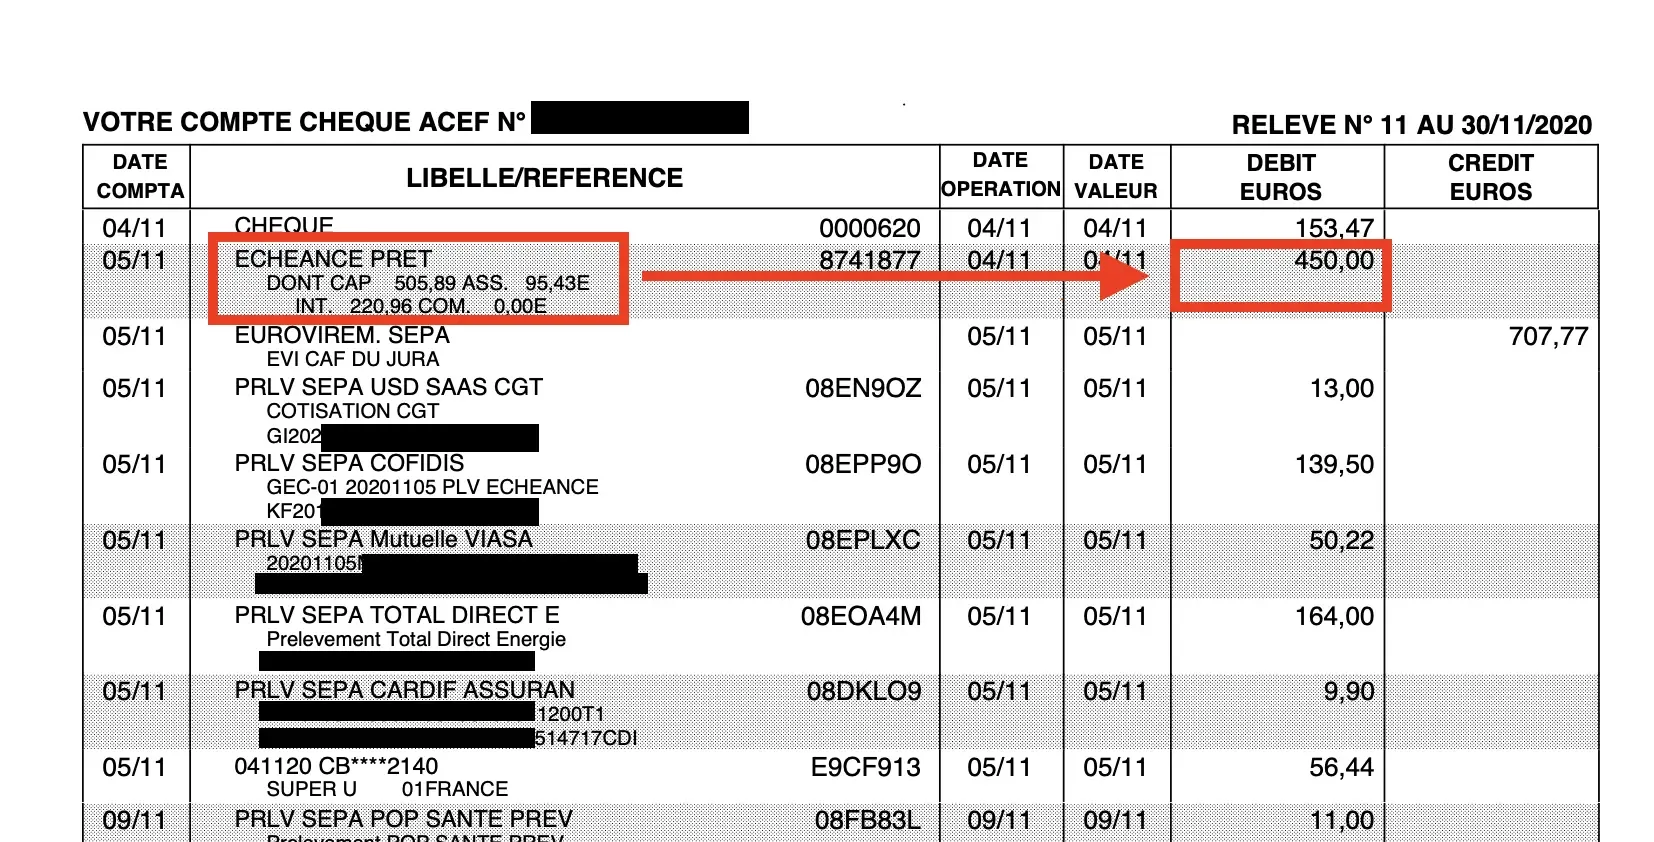
Deuxième méthode, trouvez des incohérences au niveau de chaque transaction. Par exemple, sur notre exemple ci dessous, on voit que le montant du débit en euros (450 euros) n'est pas cohérent avec la décomposition du montant qui se trouve dans le détail de la transaction elle même (505,89 euros de capital remboursé). Le fraudeur n'a pas pris la peine de le modifier.
Sans doute, de manière plus ciblée, la détection d'incohérence peut s'appuyer uniquement sur l'analyse des quelques transactions qui sont sujettes à des modifications ou altérations. Dans le cas des dossiers de crédit, il va s'agir surtout des lignes relatives aux revenus et aux charges importantes comme les crédits déjà existants ou le loyer.
Troisième méthode, vérifier l'identité du titulaire du document. Lorsqu'il s'agit d'une société, il est possible de croiser les informations déclarées avec les bases de données officielles, comme celle du RCS en France. En un seul appel API, on peut ainsi vérifier si la société existe toujours, est en activité, ou si elle a été placée en cessation ou en redressement judiciaire, un indice fort de fraude.
Enfin, l'IBAN est vraiment à exploiter. À notre avis, il est souvent inutile de vérifier que l'IBAN est « conforme » à la norme (conversion des lettres en chiffres, le nombre obtenu doit donner 1 en modulo 97), mais soit, un fraudeur peut toujours se tromper en falsifiant ce nombre. En revanche, un IBAN révèle l'identité de la banque et peut donc être recoupé avec le relevé.
Techniquement, comment faire ?
Différentes options sont possibles selon la nature de vos fichiers. Si vous n'avez que des PDF dits « natifs », c'est à dire issus des applications bancaires, et non des scans, vous pouvez construire une extraction complètement sans OCR, grâce à des outils type pdfplumber. Si vous avez des scans, il faut absolument réaliser une étape de parsing préalable via une solution OCR. Si vous avez les deux, ce qui est probable, vous pouvez passer par une étape d'orientation vers le bon traitement. Une étape LLM est ensuite indispensable pour combiner les différents champs extraits.
Résultats attendus et faiblesses
La difficulté est réelle, car une seule erreur d'océrisation peut engendrer des faux positifs. De même, de nombreuses fraudes ne relèvent pas de ces modifications : la modification du nom, typiquement, est fréquente. Une personne s'attribue le relevé d'un tiers en remplaçant simplement le titulaire, et toutes les lignes restent parfaitement cohérentes entre elles. 36 fichiers de notre base comportaient des anomalies de ce type. C'est important. Mais une partie des faux passe ce contrôle sans difficulté : il suffit au fraudeur d'avoir pris le temps de recalculer les soldes. D'où les méthodes suivantes.
Méthode 2. Détecter des incohérences dans les métadonnées du PDF
Qu'est ce que les métadonnées d'un PDF ? Un PDF est un ensemble d'objets en texte. Plusieurs d'entre eux, dont le dictionnaire Info (/Info), indiquent des informations de base sur le document : qui a produit le fichier (quel logiciel), à quelle date, et si le PDF a reçu des modifications.
La norme PDF n'impose pas forcément de les remplir, mais pour l'immense majorité, on trouve un Creator et un Producer qui révèlent d'où provient le fichier. Il y a également la date de création (CreationDate) et la date de modification (ModDate) qui sont intéressantes à exploiter.
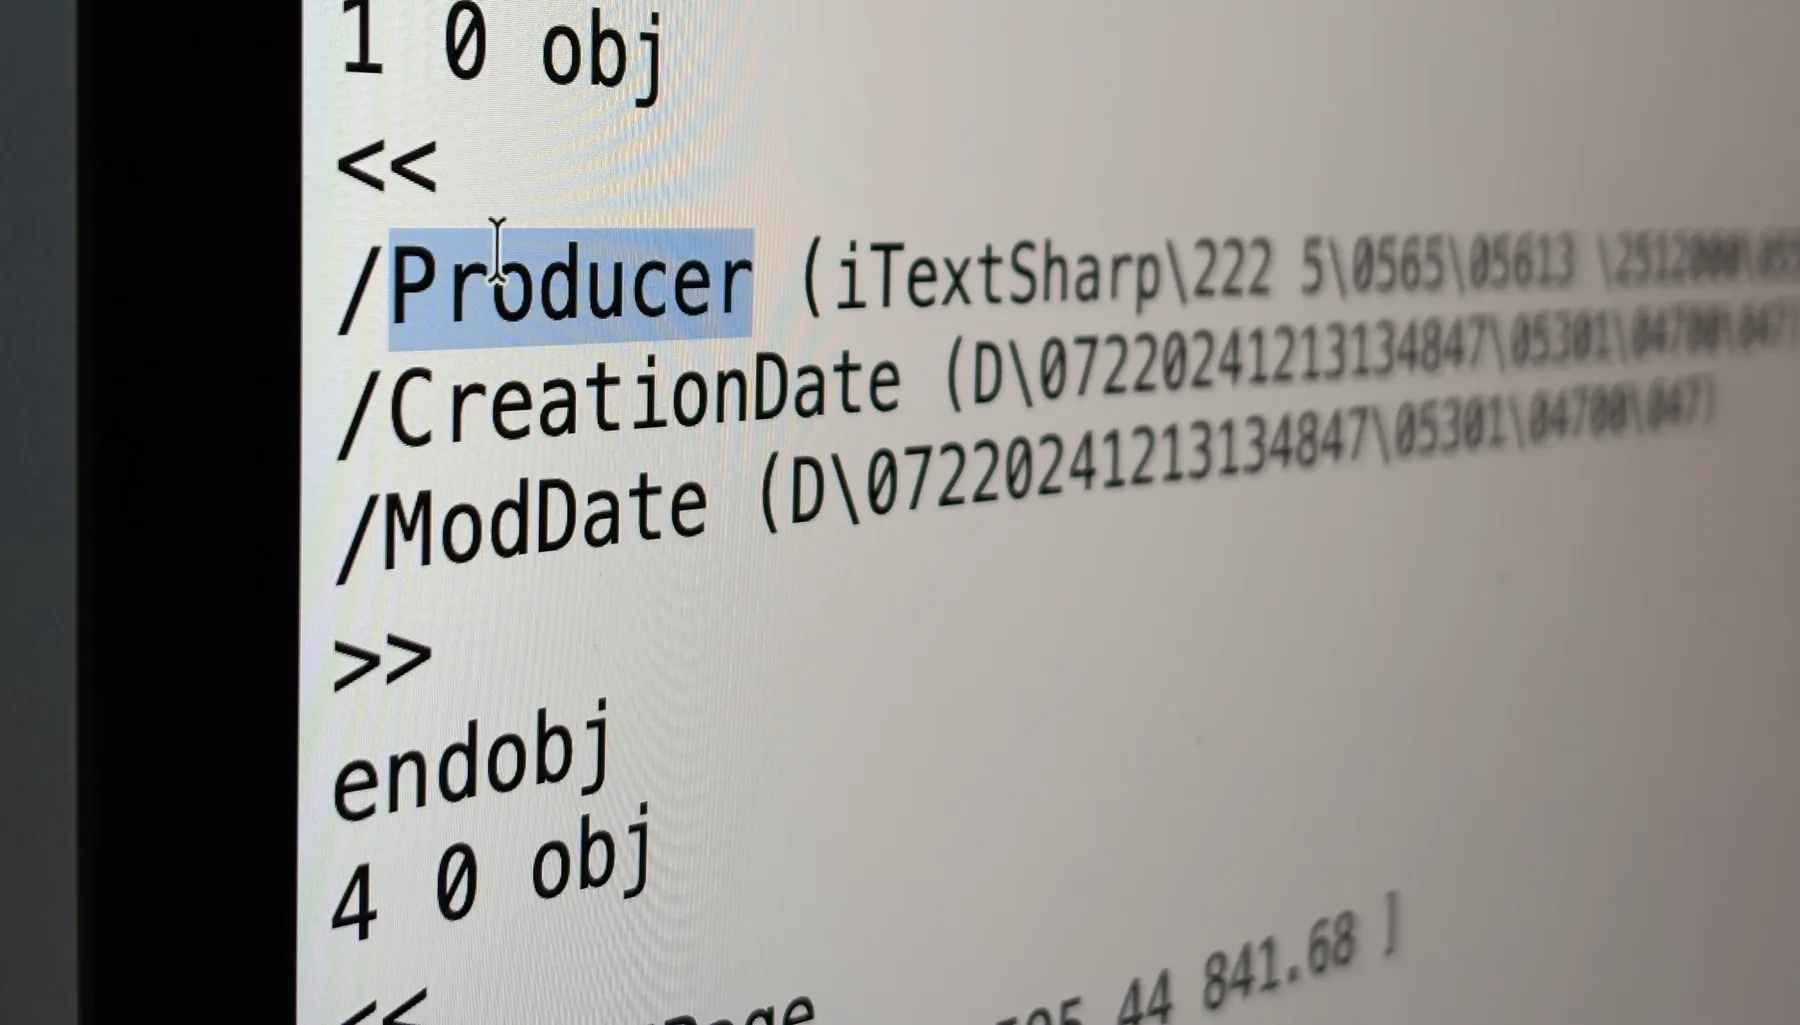
Les fichiers contiennent très souvent toute une série de métadonnées complémentaires, comme les données XMP donnant d'autres informations sur le créateur du fichier (par exemple Author pour les fichiers générés par Word) ou encore les opérations qui ont été réalisées sur le fichier.
Pourquoi c'est intéressant ? Car beaucoup de fraudeurs les laissent en clair dès qu'ils modifient un fichier. La suite Adobe, ou les différents éditeurs de PDF, y inscrivent très souvent ces informations.
Techniquement : simple à mettre en place, complexe à finaliser vu le nombre d'exceptions à connaître
Extraire les métadonnées est un jeu d'enfant. Des librairies telles qu'ExifTool sont rapidement invoquées par les LLM pour extraire toutes les métadonnées. Attention tout de même à faire un parseur suffisamment intelligent : on voit très souvent des métadonnées cachées (à titre d'exemple un peu technique : (i) lors des doubles couches EOF, la métadonnée est souvent en double, ou (ii) des métadonnées enchâssées dans d'autres objets qui ne sont pas le flux /Info ou /Metadata).
Mais savoir quelles sont les métadonnées vraiment problématiques est plus subtil. On peut dès lors dire que Photoshop doit faire lever un drapeau rouge, mais la liste des éditeurs est quasi infinie. Il faut donc procéder à des catégorisations intelligentes en fonction des PDF. On a déterminé chez Koncile 9 types de PDF.
Les neuf familles d'outils PDF
Classées de la plus suspecte à la plus fiable
Dans le détail, du plus rassurant au plus suspect sur un relevé de compte :
- Génération institutionnelle (OpenText Exstream, Quadient Inspire, Compart, AFP2PDF) : la chaîne d'émission d'une banque, c'est ce qu'on attend.
- Bibliothèque de génération applicative (iText, Apache FOP, PDFlib, Chromium) : normal, beaucoup d'espaces clients génèrent ainsi.
- Numérisation (scanners, CamScanner, Adobe Scan) : pas un signal sur cet axe, le fichier vient du titulaire.
- Réimpression ou réenregistrement local (Microsoft Print to PDF, Aperçu sur Mac, navigateur) : fréquent, signal moyen.
- Outil d'assemblage grand public (iLovePDF, PDF24, Smallpdf) : signal moyen, à condition de vérifier qu'il s'agit bien d'un assemblage.
- Bibliothèque de réécriture (pypdf, qpdf, MuPDF) : red flag, moyen à ce stade, on y revient plus bas.
- Suite bureautique ou outil de composition (Word, LibreOffice, Canva, InDesign) : red flag, une banque n'émet pas ses relevés sous Word.
- Éditeur de PDF ou d'image (Adobe Acrobat, Foxit, Nitro, Photoshop) : red flag, ce sont les outils de modification par excellence.
- Aucun éditeur déclaré : red flag sur un PDF natif, probablement nettoyé.
Attention avant de signaler : le contexte doit être pris en compte. Plusieurs justificatifs passent très souvent par iLovePDF pour être assemblés sans qu'aucune page n'ait été modifiée. Il faut donc prendre en compte l'existence d'un assemblage dans cette appréciation. Et un lot mêle presque toujours des scans et des natifs : sur un scan, l'éditeur déclaré parle de la numérisation, pas de l'émission. Ce qu'on cherche vraiment, ce sont les outils d'édition, Acrobat ou Photoshop en tête, et les bibliothèques de modification de bas niveau dont on reparle plus loin.
Les limites : des données déclaratives facilement modifiables par les fraudeurs
Vous l'avez compris, les fraudeurs peuvent aussi facilement modifier eux mêmes ces métadonnées. On l'avait déjà analysé chez des outils illégaux de création de relevés de compte, qui nettoient proprement les métadonnées et mettent de fausses informations à la place, comme si le document émanait d'une suite ERP de banque.
D'où la nécessité d'aller plus loin que ce que le fichier déclare. Un PDF ne se résume pas à son dictionnaire de métadonnées : c'est un fichier source complet, qu'on peut ouvrir en texte brut. Et dans ce fichier brut, la façon dont les objets sont écrits, compressés et enchaînés trahit l'outil qui a réellement produit les octets, quoi qu'affiche le champ Producer. Un fraudeur maquille les métadonnées, il ne réécrit pas le style d'écriture de son éditeur. On y revient plus bas, dans la partie sur la version brute des PDF, et dans notre article sur les signaux cachés de la fraude documentaire.
Méthode 3. Chercher les traces liées à l'émission par un LLM
Les LLM et autres intelligences artificielles peuvent intervenir à plusieurs niveaux dans la fraude : la création d'un faux de zéro ou l'édition d'un fichier existant. On distingue dans les deux cas un faux natif, c'est à dire le fichier « numérique » initial, non scanné, et les fichiers scannés ou pris en photo, donc complètement aplatis.
Détecter les fausses photographies de relevés de compte générées par un LLM
Heureusement, les LLM ont des barrières assez fortes aujourd'hui pour empêcher de créer de faux relevés de compte. Le cas est donc marginal, voire inexistant.
Quand l'image sort tout de même d'une IA, elle porte le plus souvent une signature de provenance. Deux mécanismes existent. Les métadonnées C2PA (Content Credentials), un bloc signé ajouté au fichier image qui indique quel modèle l'a produit : c'est ce qu'OpenAI attache aux images de ChatGPT. Et le watermark invisible, une modification imperceptible des pixels conçue pour résister au recadrage et à la compression : c'est le principe de SynthID, appliqué par Google aux images de Gemini. Les deux se détectent simplement, avec un outil de vérification en ligne pour un cas isolé (Content Credentials Verify, SynthID Detector), ou un détecteur intégré au pipeline pour du volume.
C'est un contrôle facile à mettre en place, mais il ne prouve rien dans l'autre sens. Une capture d'écran, une conversion ou un passage dans un éditeur suffisent à faire disparaître les métadonnées C2PA. Un fraudeur aguerri sait contourner les refus des grands modèles, et il existe des générateurs moins regardants sur les obligations de marquage, notamment celles de l'AI Act européen, qui n'apposent aucun signal. L'absence de watermark n'est donc jamais une preuve d'authenticité.
Détecter les relevés de compte natifs produits par les LLM
Si un relevé natif a tout de même été composé par une IA, il porte les traces de sa fabrication, et ce sont toujours les mêmes. Un LLM n'a pas de chaîne d'édition bancaire : il écrit un script, presque toujours en Python, qui s'appuie sur une bibliothèque de génération grand public. On retrouve donc en Producer des pypdf, MuPDF, ReportLab ou FPDF, ou bien LibreOffice et Word quand le modèle est passé par un document texte avant conversion, souvent avec des champs laissés par défaut. Aucune banque n'émet ses relevés ainsi. Une fois ces outils rangés dans vos catégories d'éditeurs, le faux généré par IA tombe dans le même filet que les autres. Il faut simplement les avoir anticipés dans la liste.
Méthode 4. Chercher les traces liées à la modification par un LLM
Détecter les modifications de photographies authentiques de relevés par un LLM
Là encore, le refus des grandes IA est votre premier garde fou, et obtenir un résultat réaliste en retouchant une photo existante reste difficile. Le vrai changement vient de l'inpainting : on sélectionne une zone de l'image, un montant ou un nom, et l'IA la régénère en respectant la police, le style et le grain du reste.
C'est ce que proposent Midjourney ou le remplissage génératif d'Adobe. Le reste de la photo est authentique, seule une petite zone est fausse, et le modèle s'applique justement à la rendre cohérente avec son voisinage.
C'est difficile à détecter, et la recherche reste limitée sur ce type de retouche : ce n'est pas le même terrain que la retouche classique sous Photoshop, où des modèles comme TruFor donnent de bons résultats. Des faiblesses subsistent tout de même dans le grain et la texture de la zone régénérée. Et quand un signal de provenance n'est présent que sur une partie de l'image, c'est la signature d'un insert.
Détecter les relevés de compte natifs modifiés par les LLM
Pour les fichiers natifs modifiés par une IA, nous avons mené une étude assez poussée chez Koncile pour comprendre comment ces fichiers étaient réécrits. Le constat est que ce sont toujours les mêmes patterns.
L'IA passe par une bibliothèque PDF de bas niveau, pypdf, MuPDF ou qpdf, pour ouvrir le fichier, changer une valeur et le réenregistrer. Attention, cette information ne figure pas forcément dans les métadonnées classiques : MuPDF, par exemple, conserve le dictionnaire Info tel quel, et le Producer continue d'afficher la chaîne bancaire d'origine. Un simple détecteur de métadonnées ne suffit donc pas.
La bonne nouvelle, c'est que ces bibliothèques ne savent pas se cacher. Elles laissent des traces à plusieurs niveaux : une signature en clair dans les premières lignes du fichier (« Written by MuPDF »), un style d'écriture du PDF qui leur est propre, dans la forme des dictionnaires ou l'ordre des objets, et un niveau de compression particulier, visible surtout quand une seule partie du fichier a été réécrite et cohabite avec des objets compressés autrement. Parfois même, l'outil ajoute une nouvelle couche au lieu de tout réécrire, et l'information d'origine reste lisible en dessous. Détecter ces bibliothèques est indispensable : c'est ce qui permet de savoir quel fichier a été modifié.
Méthode 5. Fouiller la version brute des PDF pour trouver les anomalies typiques de la falsification
Les PDF natifs sont une mine d'informations, y compris ceux qui ne contiennent qu'une image. Il suffit d'ouvrir le fichier en texte brut. Un relevé émis par une banque et jamais retouché présente une cohérence interne que le faux perd presque toujours quelque part. Quatre endroits où regarder.
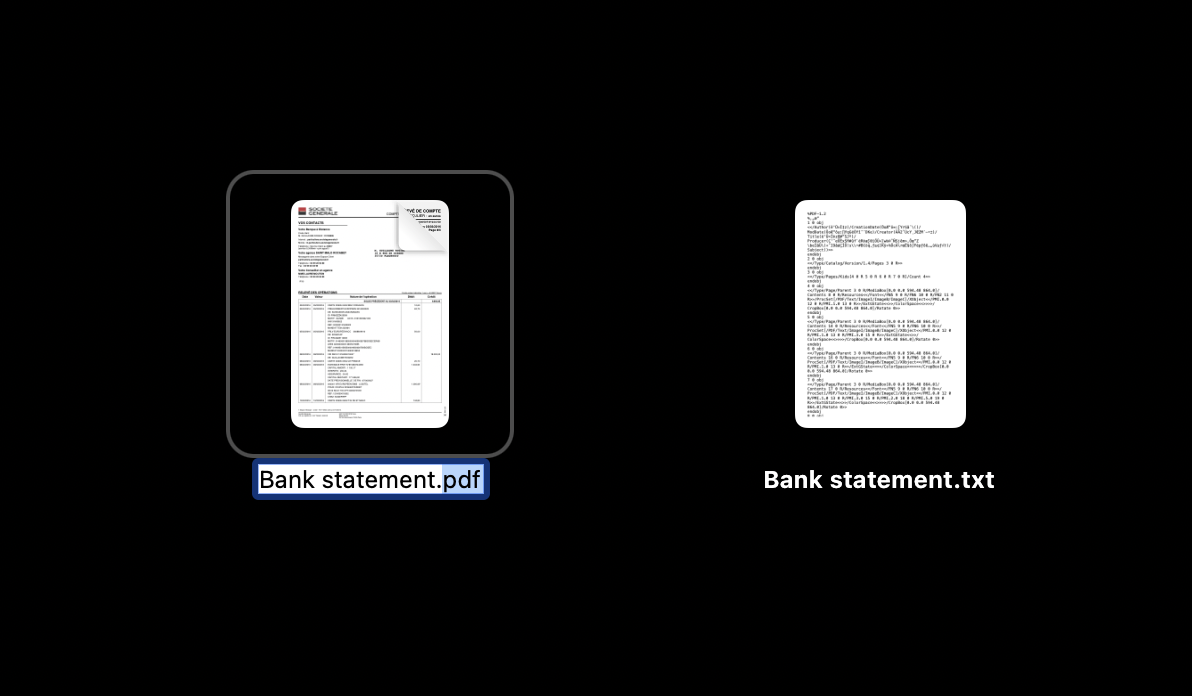
Les polices. Une police peut être intégrée à un PDF de trois façons : appelée par son nom sans être embarquée, embarquée en entier, ou embarquée en sous ensemble avec seulement les glyphes utilisés. Une chaîne bancaire traite toutes ses polices de la même manière. Une police intégrée autrement que les autres, c'est souvent celle qu'un éditeur a ajoutée pour réécrire un montant.
Les compressions. Un PDF est du texte dont les flux (polices, images, contenu des pages) sont compressés. Trouver plusieurs niveaux de compression dans un même fichier n'est pas normal. C'est la trace typique d'un qpdf ou d'un pypdf qui a réécrit le fichier entier en recopiant certaines parties telles quelles et en recompressant celles qu'il a modifiées.
Les couches EOF. Quand un éditeur modifie un PDF sans le réécrire, il ajoute une couche en fin de fichier, marquée par un nouveau %%EOF, qui contient les objets remplaçant les anciens. C'est le cas le plus riche : on compare la couche d'avant et celle d'après, et on se demande pourquoi une police a été ajoutée, pourquoi un bloc de texte, parfois pourquoi un carré blanc. Attention, beaucoup de couches sont bénignes : une signature électronique s'ajoute ainsi, et un fichier linéarisé en compte deux par construction. Ce n'est pas le nombre de couches qui compte, c'est ce qu'elles contiennent.
Les objets dormants. Enfin, certains objets restent dans le fichier sans plus être référencés nulle part, comme l'ancien contenu d'une page réécrite. Ils dorment, et ils racontent ce que le document disait avant.
Méthode 6. Constituer votre propre bibliothèque de modèles habituels pour chaque banque
Ce travail est un peu lourd, mais il peut s'avérer payant. Le principe : pour chaque banque, mémoriser à quoi ressemble un relevé brut, tel qu'il sort de sa chaîne d'émission. Pas seulement le Creator et le Producer déclarés, mais tout ce qu'on vient de voir dans le fichier source : la façon dont les polices sont intégrées, le niveau de compression des flux, l'ordre des objets, le nombre de couches EOF. Un relevé authentique de la même banque reproduit ce profil à l'identique. Un faux, même soigné, s'en écarte presque toujours sur un point, et chaque écart devient un signal. C'est cette bibliothèque de profils par émetteur que nous constituons et enrichissons en permanence chez Koncile.
La même logique vaut pour les images, et c'est la seule vraie réponse aux relevés « aplatis », modifiés numériquement puis imprimés et rescannés pour effacer toute trace dans le fichier. Cette fois, on stocke les polices telles qu'elles apparaissent en photo : une couche OCR pose une boîte autour de chaque caractère, puis on compare lettre par lettre le tracé observé avec celui que l'on connaît pour cette banque. Un « 4 » ou un « 7 » dessiné un peu différemment du reste, et l'écart est trop grand pour être un hasard de numérisation. Chez Koncile, nous accumulons cette connaissance très précise de la formation des lettres sur chaque relevé rencontré.
Méthode 7. Utiliser les 2D-DOC, Datamatrix et QR codes intégrés
Certains documents embarquent leur propre preuve d'authenticité sous forme de code : le 2D-DOC en France, un Datamatrix normalisé par l'ANTS, ou plus rarement un QR code signé. Le code contient les valeurs clés du document (titulaire, adresse, montants, date) signées avec la clé privée de l'émetteur, et n'importe qui peut vérifier cette signature avec la clé publique correspondante.
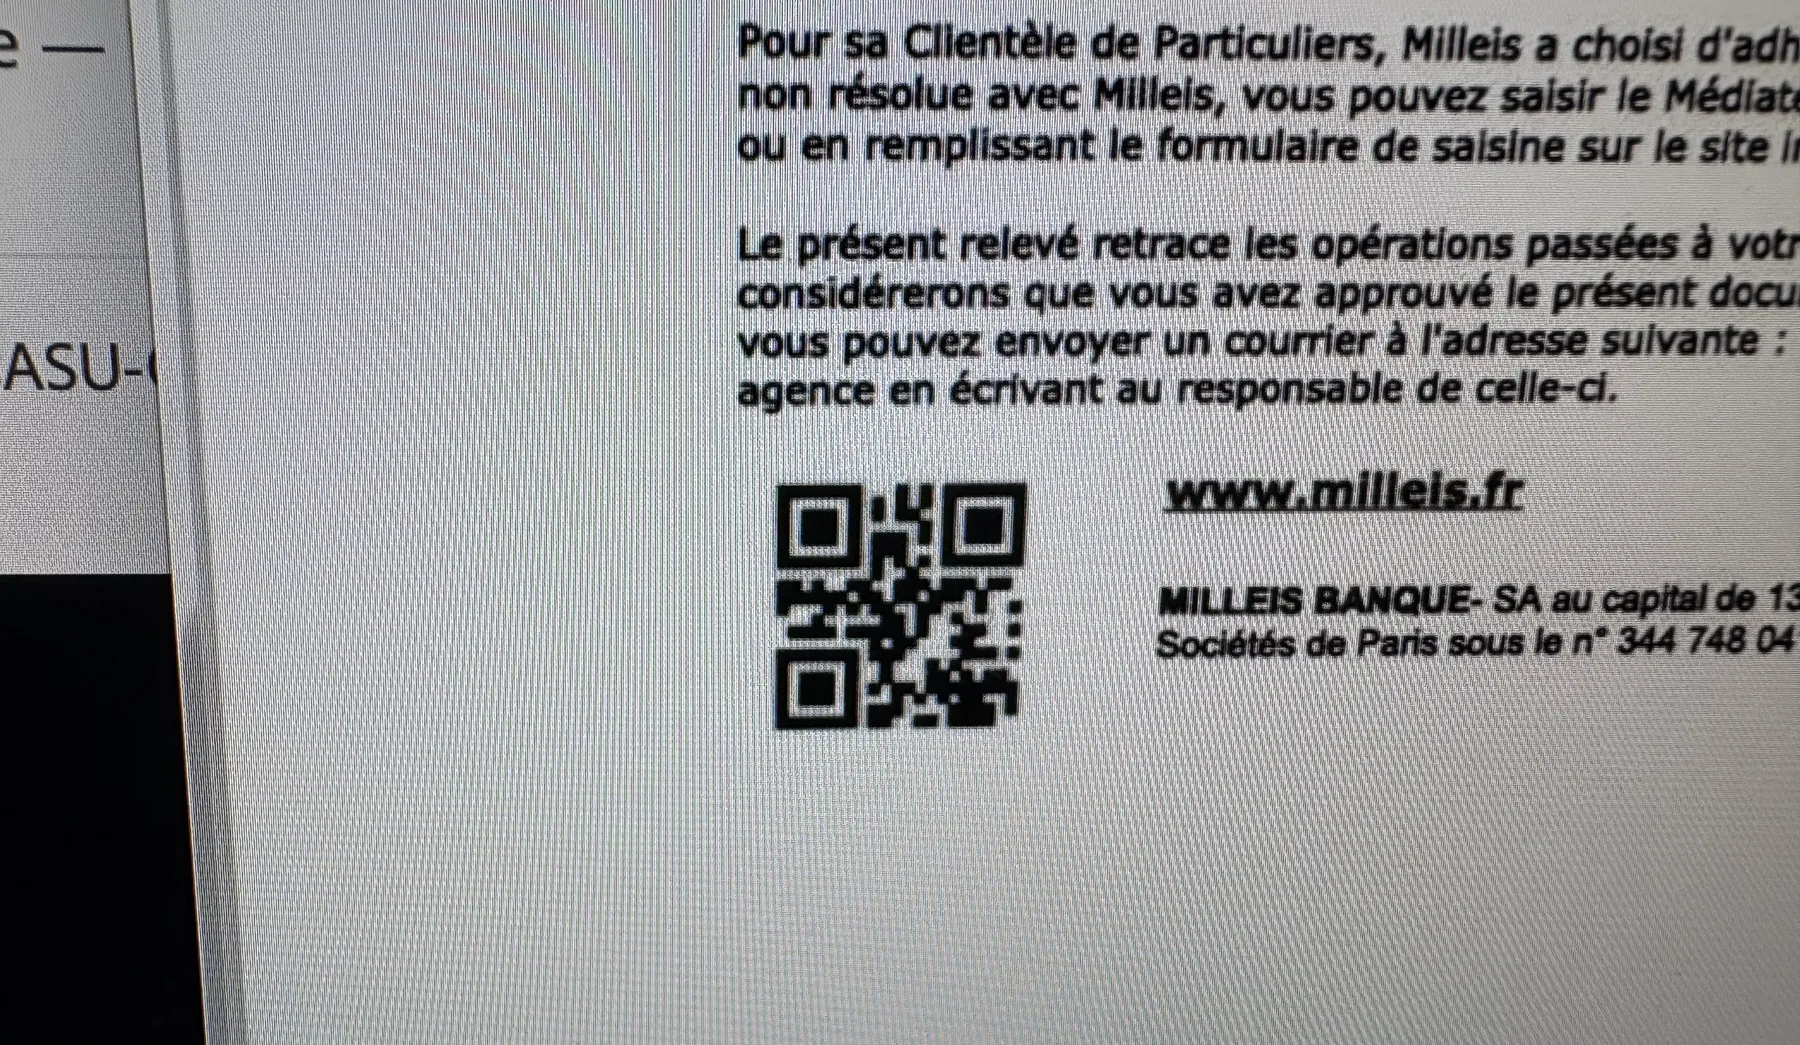
C'est un contrôle puissant, parce qu'il repose sur de la cryptographie et non sur des indices : impossible de fabriquer un code valide sans la clé de l'émetteur, et le code survit à l'impression comme au rescan. Le vrai contrôle ne s'arrête pas à « le code est valide » : il faut comparer les valeurs lues dans le code avec celles imprimées sur le relevé, car un fraudeur peut très bien recopier un code authentique sur un document dont il a changé les chiffres. Encore rare sur les relevés de compte, le 2D-DOC est déjà répandu sur les factures d'énergie et les avis d'imposition. Quand il est là, il faut le lire, et un QR code non signé ne vaut rien en comparaison.
Méthode 8. Utiliser un détecteur d'altérations d'images
Pour détecter une altération d'image, il faut passer par du machine learning, pas par un LLM : un LLM ne voit pas ces retouches. C'est plus technique, pas accessible à tous, et cela demande un gros dataset, mais c'est ce qui fait la différence sur les relevés scannés. Des projets universitaires comme TruFor ont montré de très bons résultats sur les falsifications faites avec les outils d'édition d'image classiques, Photoshop, GIMP ou Canva. Leur principal problème : leurs licences interdisent en général l'usage commercial, y compris pour les besoins internes d'une entreprise.
Ce que ces modèles attrapent, ce n'est pas l'inpainting vu plus haut, mais l'outil préféré des faussaires : le clone stamp, ou tampon de duplication. Il copie une zone existante du document, un « 4 » par exemple, et la recolle ailleurs en restant cohérent avec le reste. Les logiciels qui le proposent laissent souvent des métadonnées derrière eux, ce qui suffit pour les fraudeurs peu soigneux. Quand ce n'est pas le cas, le modèle repère des similarités de pixels entre deux endroits de l'image, comme si une zone avait été copiée collée.
Reste un souci : le modèle trouve des ressemblances, il ne sait pas si elles comptent. Copier une zone blanche n'a aucun intérêt pour un fraudeur. D'où un système en deux temps : un détecteur généraliste qui isole les zones suspectes, puis une couche LLM qui juge si ces zones sont pertinentes à modifier, un montant, un nom, une date. C'est là que la fraude est identifiée.
Méthode 9. Détecter les documents issus des template farms
Les template farms sont un phénomène très répandu, et les relevés de compte en sont la cible favorite. Ce sont des sites qui vendent des gabarits imitant les relevés des principales banques : on part d'un vrai document, on l'édite, on y ajoute ses propres lignes. Nous en avons identifié plusieurs dizaines chez Koncile.
Pour les détecter, une seule méthode : les passer en revue et accumuler de la donnée sur leurs fichiers, métadonnées et construction du PDF. C'est le même principe que la bibliothèque par banque, mais tournée vers les faux : une base dédiée aux template farms, enrichie à chaque document suspect rencontré, avec un travail de veille pour repérer les principales plateformes et comprendre comment elles génèrent leurs fichiers.
Et dans 100 % des cas, on reconnaît des traces. La raison est simple : répliquer parfaitement la chaîne d'émission d'une banque est extrêmement rare, parce que le travail n'est jamais complètement terminé. Or une chaîne d'émission, ce n'est pas seulement le Creator et le Producer. C'est aussi la bibliothèque utilisée, le style d'écriture du PDF, les compressions, l'enchaînement des objets, la façon dont les polices sont intégrées, l'appel, la compression et le placement des images, la présence de XObjects, de formulaires ou d'une signature électronique. Un gabarit reproduit l'apparence, jamais toute la chaîne. Il suffit de recouper.
En synthèse
Trois enseignements à retenir.
Combinez les méthodes. Aucune ne suffit seule. Il faut à la fois des contrôles contextuels (soldes, IBAN, titulaire), l'analyse des métadonnées, la fouille du fichier brut et, pour les scans, l'analyse d'image. Chaque test apporte sa contribution à un score de fraude global, et c'est ce score qui décide, pas un test isolé.
Calibrez vos tests. Chaque test doit être passé à grande échelle sur une grosse masse de documents, c'est la seule manière de mettre au jour les faux positifs. Un simple test de métadonnées mal calibré peut en produire 10 à 20 %. C'est un travail d'itération, jamais vraiment terminé.
Exigez des PDF natifs quand vous le pouvez. Sur les relevés de compte, c'est ce qui permet d'exploiter tout ce qui précède, et c'est d'autant plus utile si vous n'avez pas d'ingénieur en machine learning dans l'équipe. L'analyse d'image n'est pas la plus difficile, des bibliothèques open source existent, mais elles sont livrées brutes : il faut les enrichir et affiner les modèles sur vos propres documents avant qu'elles deviennent utiles.
Nos retours terrain sur l'automatisation documentaire
Détecter un faux relevé de compte : nos 9 méthodes
Le relevé de compte est un document particulièrement sujet à la fraude. Chez Koncile, on détecte jusqu'à 1,4 % de relevés modifiés ou altérés sur un jeu de 150 000 relevés. On parle beaucoup des deepfakes générés par l'IA, mais se focaliser uniquement là dessus aujourd'hui serait une erreur.
OCR par intelligence artificielle vs OCR classique : ce qui change vraiment pour vos documents
Un benchmark a mesuré la précision de Gemini 1.5 Pro sur des documents financiers à environ 50%, tandis que GPT-4o atteint 84% sur du contenu juridique. C'est ce que les discours «passez à l'OCR par intelligence artificielle» laissent de côté. Voici une comparaison factuelle entre OCR classique, IA généraliste et OCR par LLM dédié.
Les 10 meilleurs outils OCR Open Source en 2026
Le classement des OCR open source s'est inversé au cours des dix-huit derniers mois. Un modèle de 0,9 milliard de paramètres lit désormais les documents avec plus de précision qu'un modèle de 235 milliards de paramètres. PaddleOCR-VL obtient un score de 96,34 % sur OmniDocBench v1.6, tandis que Qwen3-VL-235B affiche 89,78 %. Voici les 10 meilleurs moteurs OCR open source en 2026 et comment choisir entre eux.
Top 10 des logiciels de détection de fraude documentaire en 2026
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.

Tesseract OCR : toujours le meilleur OCR open source en 2026 ?
Parmi les nombreuses solutions disponibles sur le marché, Tesseract est souvent cité comme l'un des meilleurs logiciels OCR open source. Mais est-il toujours la meilleure solution en 2026 ? Nous analyserons ses performances, avantages, inconvénients et les alternatives OCR open-source.