Traitement de documents et détection de fraude : construire ou acheter ?

Les 39 difficultés à anticiper avant de construire sa propre solution de traitement de documents et de détection de fraude.
Auteur et Co-fondateur Koncile
par 
Tristan Thommen
Dernière mise à jour : 
September 30, 2026
 - 
8
 minutes

Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.

Extraire et structurer les données de documents, l'enrichir, détecter la fraude… Avec l'IA, construire de bout en bout sa solution de traitement de documents ou de détection de fraude n'a jamais paru aussi simple. Cela dit, acheter une solution prête à l'emploi se révèle souvent une meilleure option. Acheter permet de garantir que sa solution utilise les technologies de pointe, gère l'ensemble des erreurs et difficultés techniques que vous rencontrerez inévitablement, gère l'infrastructure pour la montée en puissance, les aspects réglementaires et de sécurité…

Suite à de multiples discussions avec nos prospects et clients confrontés à ces questionnements (construire ou acheter), nous avons réuni la liste complète des trente-neuf difficultés que vous devrez vous attendre à surmonter si vous décidez de construire. Même à l'ère de l'IA où le build est plus facile que jamais, le build reste plus coûteux et difficile qu'il n'y paraît : maintenance, gestion d'erreurs, infrastructure, sécurité… L'IA est certes pleine de promesses, mais aussi pleine d'illusions. Cet article doit vous aider à faire la part des choses.

Construire est devenu rapide

Avant 2025, construire une solution interne de traitement de documents nécessitait une équipe dédiée pendant plusieurs mois. Aujourd'hui, un Claude Code ou autre agent de codage permet de construire un prototype en quelques jours : réception et tri des documents, lecture de PDFs et images, extraction des champs par appel à un modèle de langage, contrôle de cohérence des données et métadonnées, vérification d'authenticité du document, exposition sur une API pour transmission des résultats vers l'ERP ou l'outil métier dans son format, avec une reprise possible en cas d'échec. Sur 100 documents de test, le résultat est bon, et le décideur peut avoir légitimement le sentiment que c'est la solution : construire en interne.
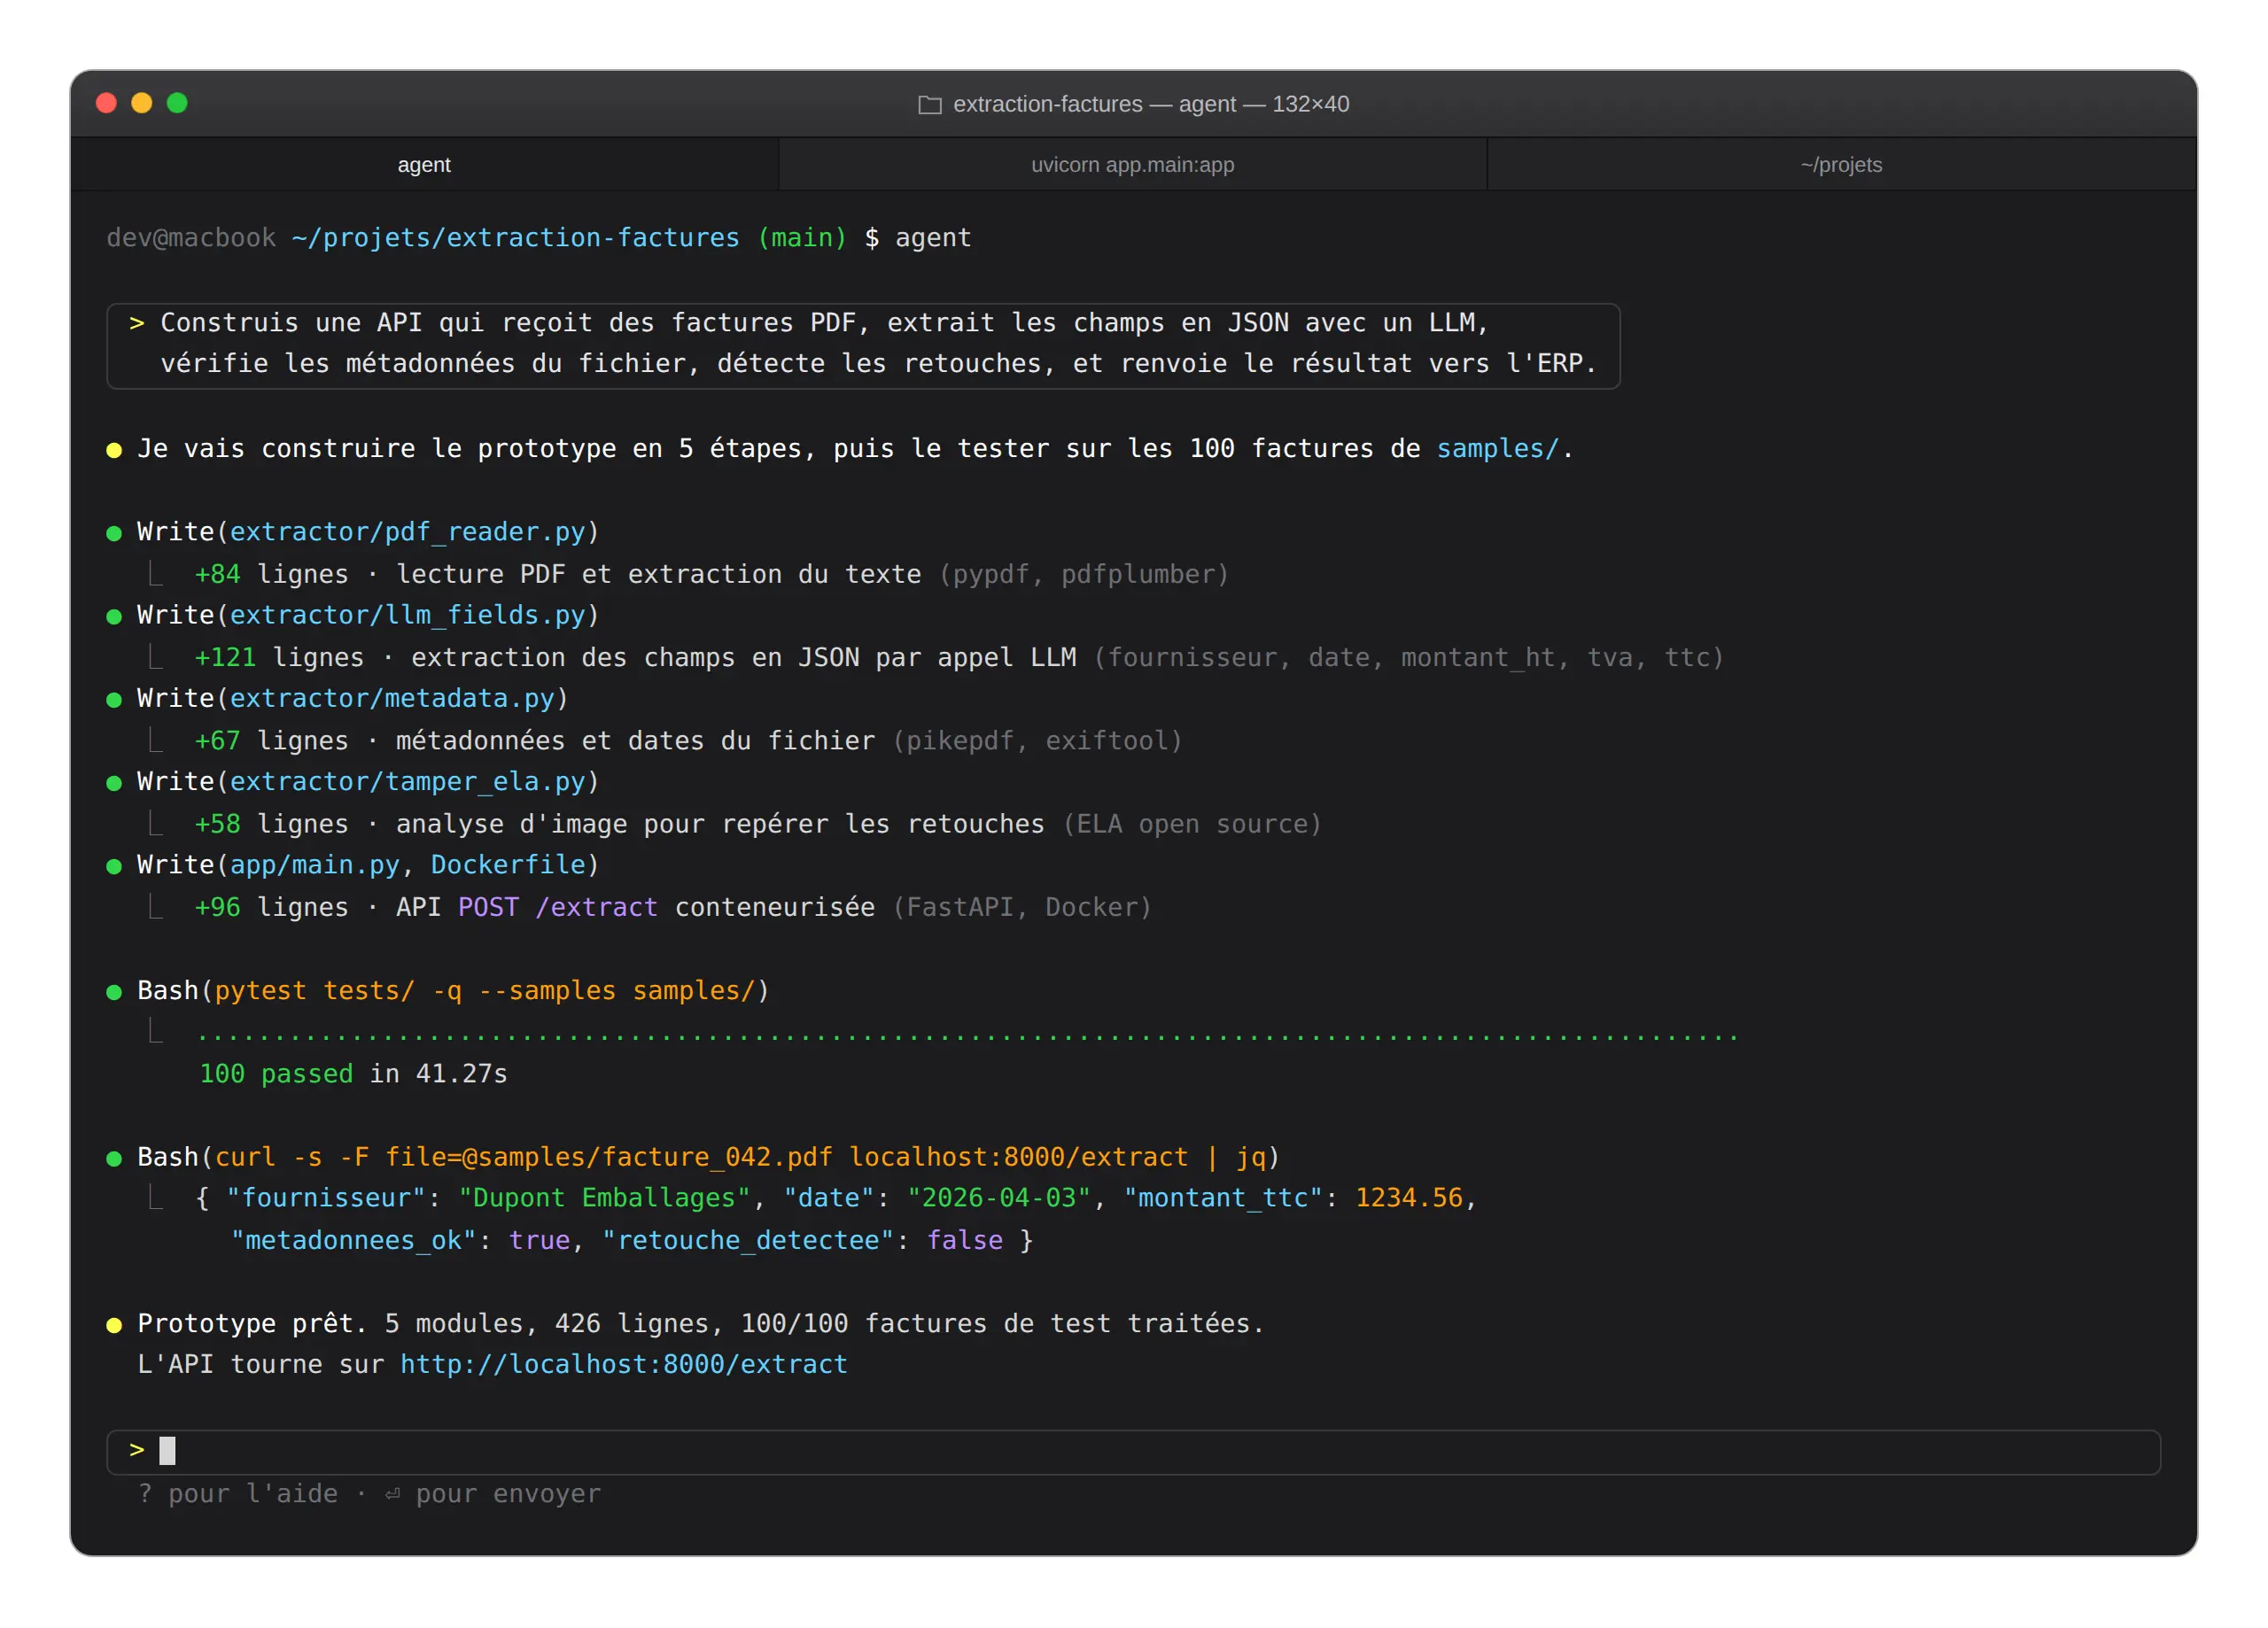
Capture d'écran d'un terminal macOS où un agent de codage construit une API d'extraction de factures PDF en 5 modules, testée avec succès sur 100 documents.

Typiquement, un agent de codage va développer quelque chose peu ou prou de ce type :

pypdf, pdfplumber

Lecture du PDF et extraction du texte

appel LLM

Extraction des champs en JSON à partir d'un prompt

pikepdf, exiftool

Lecture des métadonnées et des dates du fichier

ELA open source

Analyse d'image pour repérer les retouches

FastAPI

Une API autour du tout, conteneurisée

La stack fait sens et le code produit est propre, et les outils de ce type ont donc rendu ce prototypage accessible à des équipes restreintes, voire même peu techniques. C'est ce qui est grisant et motivant. C'est ce qui donne le sentiment de pouvoir tout construire en interne. Et c'est aussi ce qui peut constituer un nouveau risque dans la prise de décision.

Trente-neuf difficultés qui apparaissent en production

À la suite de nombreux échanges avec des équipes tentées par le build, nous avons réuni une liste de trente-neuf défis et sujets qui reviennent régulièrement et que vous devrez vous attendre à relever si vous optez pour le build. Aucun défi n'est en soi insurmontable, mais ensemble ils constituent une charge inattendue qu'il vaut mieux avoir anticipée pour ne pas découvrir des bugs en production après quelques semaines. Nous ne comptons plus les fois où un prospect est revenu vers nous quelques mois après avoir tenté de construire, pour finalement acheter. Un temps précieux perdu à cause de l'illusion de facilité que peut procurer l'IA et de la difficulté associée à anticiper dans le détail les défis que l'on va devoir relever.
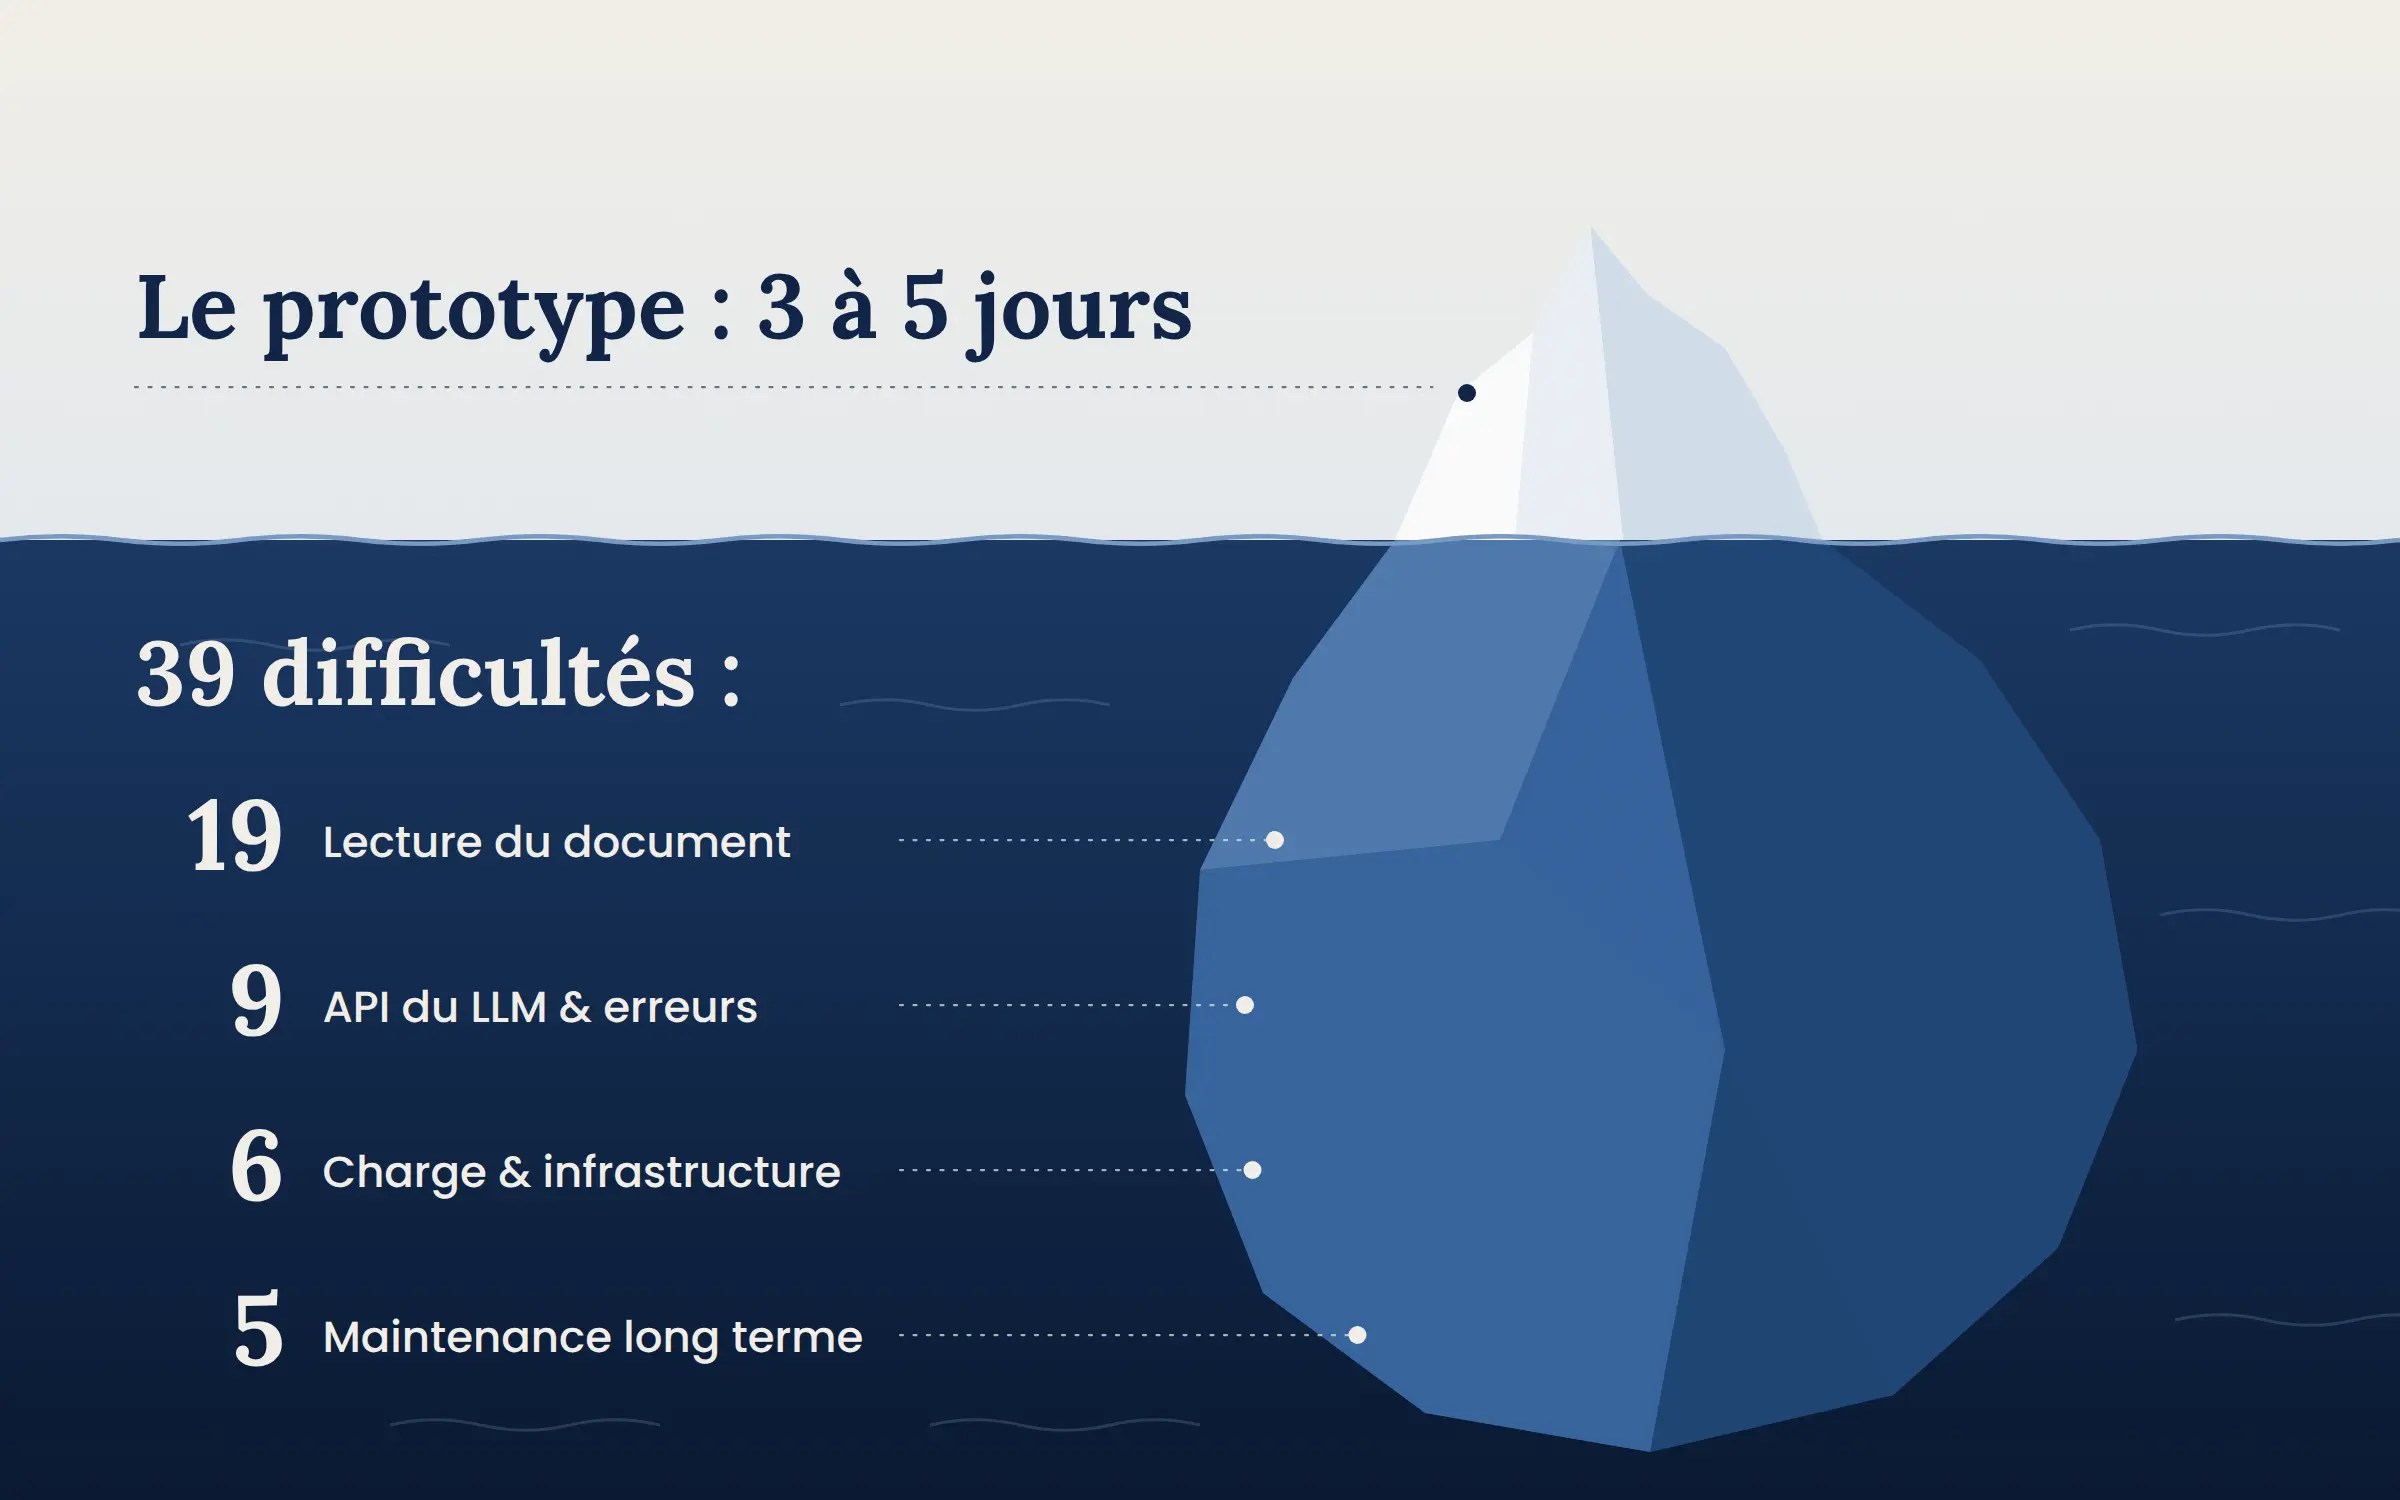
Iceberg illustrant le build d'un outil de traitement de documents : la partie visible correspond au prototype, réalisé en 3 à 5 jours, et la partie immergée aux 39 difficultés qui apparaissent en production (19 liées à la lecture du document, 9 à l'API du LLM et aux erreurs, 6 à la charge et à l'infrastructure, 5 à la maintenance à long terme).

19 défis liés à la lecture du document lui-même

01

Une ligne de tableau à cheval sur deux pages, avec l'en-tête répété et le pied de page intercalés au milieu de la ligne.

02

Un tableau quadrillé où la valeur déborde de sa cellule et empiète visuellement sur la colonne voisine.

03

Un tableau sans filets, où seul l'alignement indique la fin d'une colonne, avec un libellé long qui casse cet alignement.

04

Des en-têtes sur deux niveaux, avec une cellule fusionnée qui couvre trois colonnes.

05

Du manuscrit, et le cas plus difficile d'une annotation qui barre un prix imprimé et en écrit un autre à côté. L'OCR lit les deux valeurs. Choisir laquelle retenir relève d'une règle métier.

06

Des cases cochées, avec la distinction entre une case vide, une case cochée à la main et une croix pré-imprimée, voire raturée et rajoutée à côté.

07

Une liasse de 40 pages contenant 12 factures, sans indication claire de l'endroit où l'une finit et où la suivante commence.

08

Une page sur trois pivotée de 90 ou 180 degrés à l'intérieur du même fichier.

09

Un tampon ou une signature posé sur le montant à lire.

10

Des montants négatifs écrits (1 234,56), -1 234,56, ou 1 234,56- avec le signe à la fin, comme le font certains exports d'ERP.

11

Des séparateurs décimaux mélangés : 1,234.56 et 1.234,56 dans le même lot, quand les fournisseurs relèvent de pays différents.

12

Des dates ambiguës : 03/04/2026 peut désigner le 3 avril ou le 4 mars. La réponse dépend de l'émetteur et ne figure pas dans le fichier.

13

Des unités qui ne se comparent pas : « 12 x 75 cl » et « 9 L » désignent la même quantité sur deux lignes différentes. Sans parler du conditionnement des produits (cartons, bouteilles, sacs etc.) qui a tendance à fausser les quantités et prix à extraire.

14

Le même produit sous quatre libellés chez trois fournisseurs, avec un code EAN présent une fois sur deux.

15

Des confusions de caractères entre 0 et O, 1 et l, 5 et S, rn et m. Visibles dans un libellé, invisibles dans une référence produit.

16

Une couche texte qui contredit l'image, sur un scan mal océrisé comme sur un document retouché.

17

Des polices non embarquées, qui donnent un texte illisible à l'extraction alors que le document s'affiche correctement.

18

Une photo prise au téléphone, avec sa perspective, son ombre portée, son reflet de flash sur papier glacé.

19

Des formats inattendus : TIFF multipage, HEIC d'iPhone, .msg avec pièces jointes imbriquées, archive protégée par mot de passe.

Le découpage d'une liasse de documents et la lecture de l'écriture manuscrite sont deux sujets à part entière. Chacun des autres points est un défi que vous aurez à relever seulement lorsque vous rencontrez l'erreur, en production.

9 défis liés à l'API du modèle de langage et à la gestion d'erreurs

01

Des limites de débit avec des fenêtres de reprise variables, et la vague de relances qui suit l'envoi d'un gros lot.

02

Des timeouts sur les documents longs, sans indication permettant de savoir si le travail est perdu ou encore en cours.

03

Du JSON mal formé : tronqué en plein objet, avec une virgule finale, ou enveloppé dans un bloc de code.

04

Une valeur inventée pour un champ absent du document. La réponse est bien formée et plausible, donc rien ne signale l'erreur.

05

Un refus déontologique sur un document contenant une pièce d'identité par exemple.

06

Une fenêtre de contexte dépassée sur une liasse de plusieurs centaines de pages, qui oblige à découper avec recouvrement puis à recoller.

07

Deux exécutions qui donnent deux résultats différents sur le même document, ce qui complique tout rapprochement et tout audit.

08

Une panne de fournisseur, qui pose la question d'un second fournisseur de backup avec un format de prompt différent et une qualité à recalibrer.

09

L'absence de score de confiance par champ, qui oblige à relire tous les documents, ou aucun.

6 défis liés à la montée en charge et à l'infrastructure

01

Une charge très irrégulière, par exemple plusieurs dizaines de milliers de pages un lundi matin et presque rien le lendemain.

02

Le même fichier envoyé plusieurs fois par plusieurs personnes, ce qui suppose une détection de doublon portant sur le contenu réel et non sur le seul nom du fichier.

03

Un document bloqué en traitement, avec la question de savoir qui s'en aperçoit et au bout de combien de temps.

04

Une reprise sur erreur partielle : sur un lot de plusieurs milliers de fichiers, quelques dizaines échouent et il faut pouvoir rejouer uniquement ceux-là.

05

Des documents inattendus dans le flux : un accusé de réception, une image de signature en pièce jointe, un document d'un autre type glissé dans le lot.

06

Le stockage, la rétention et la suppression à la demande, avec la trace (logs) de qui a consulté quoi.

5 défis liés à la maintenance sur le long terme

01

Un nouveau modèle sort tous les 2 ou 3 mois. Il est meilleur sur certains documents et moins bon sur d'autres, et le savoir suppose un jeu de référence annoté et un banc de test pour rester à la pointe.

02

Une version de modèle est retirée alors que le prompt était calé dessus, ce qui oblige à tout recalibrer.

03

Sans jeu de référence, aucun test de non-régression n'est possible. L'effet d'une modification de prompt reste inconnu jusqu'à ce qu'un utilisateur signale un problème.

04

Une amélioration du moteur pose la question de l'historique : faut-il retraiter les documents déjà passés, les originaux ont-ils été conservés, sait-on quelle version a produit quelle valeur.

05

Une dépendance aux équipes techniques pour le paramétrage de nouveaux cas d'usage, et donc nécessairement des cycles de déploiements plus longs. À moins de développer aussi une interface visuelle en langage naturel pour que les utilisateurs métier non techniques soient en mesure de paramétrer rapidement un nouveau cas d'usage par eux-mêmes.

Pris isolément, chacun de ces défis peut se régler en quelques heures. Pris ensemble, ils interagissent et transforment un projet qui se devait rapide et efficace en une usine à gaz coûteuse à développer, maintenir et sécuriser. Autant le savoir avant de se lancer.

La maintenance ne s'arrête jamais

Un outil de traitement de documents s'entretient. Les modèles évoluent tous les quelques mois, les émetteurs changent leurs formats sans prévenir, les exigences de sécurité évoluent, les attentes clients changent. Un projet interne engage donc une charge permanente qui va bien au-delà de la construction initiale.

Cette charge est la moins visible au moment de la prise de décision, et la plus douloureuse. Surtout si elle est découverte après coup. Elle recouvre plusieurs éléments distincts :

  • Suivre les modèles disponibles, les évaluer sur ses propres documents, et arbitrer entre qualité, coût et latence.
  • Maintenir un jeu de référence annoté, sans lequel aucune amélioration ne se mesure.
  • Absorber les changements de format des émetteurs, qui ne préviennent pas.
  • Tenir la sécurité et la conformité, souvent devenues une condition pour signer un client.
  • Rester disponible pour les incidents, y compris pendant les congés et les périodes chargées.

Ce travail n'a pas de fin. Il occupe durablement une partie d'une équipe, sur un sujet qui n'est presque jamais le métier de l'organisation.

Vérifier que le document est authentique

Les faux documents sont de plus en plus fréquents, et les fraudeurs de plus en plus malins. Comment s'assurer qu'un dossier de demande de prêt ou de dédommagement de sinistre est bien authentique ? Dans ce domaine, le build devient quasiment impossible : analyse d'image et de pixels, étude des métadonnées et centaines de règles métier très spécifiques, comparaison à des bases de données internes de documents de référence, analyse fine de la cohérence du document, comparaison à des données récupérées dans des bases externes.

Un modèle de langage comprend bien qu'il a affaire à un bulletin de paie et en sort le net à payer. Il ne mesure pas les écarts de compression entre deux zones d'une image, il ne compare pas l'outil déclaré dans les métadonnées à ce que produit habituellement un émetteur donné, et il ne repère pas une couche d'objets ajoutée dans le fichier après son émission. Et tout cela doit se faire métier par métier, type de document par type de document, cas d'usage par cas d'usage. Bon courage.

Ce qui manque crucialement aux LLM est la base de comparaison et la connaissance métier fine : savoir ce qu'un émetteur donné produit normalement demande d'avoir observé un grand nombre de ses documents authentiques. Les signaux faibles de la fraude documentaire et les trois méthodes de détection détaillent ce mécanisme.

Quand construire reste la bonne décision

Mais alors, quand construire ? Construire garde du sens dans plusieurs situations. Voici les quatre questions à se poser pour décider :

  1. D'où viennent les documents ? Produits en interne, le format est maîtrisé et le problème reste sous contrôle. Reçus de tiers, l'hétérogénéité et la sécurité deviennent les sujets critiques.
  2. Que faut-il en faire après lecture ? S'il s'agit d'alimenter un tableau de bord interne, le risque reste faible. Mais s'il faut déclencher un paiement, accorder un contrat ou refuser un dossier, alors même avec une bonne fiabilité il y a un risque inhérent considérable et difficilement maîtrisable avec une solution maison.
  3. À quelle fréquence les formats changent-ils ? Un format stable se traite avec un développement ponctuel. Un format qui bouge chaque trimestre suppose que des non-développeurs puissent suivre.
  4. Le traitement documentaire fait-il partie du métier ? Si c'est le produit vendu, il se construit. Sinon, il entre en concurrence avec le reste de la feuille de route technique.

Construire se défend quand

  • Le document est produit en interne, très structuré et stable.
  • Le volume est faible et prévisible, avec un seul format.
  • La donnée lue alimente un usage sans enjeu de contrôle.
  • Le traitement documentaire fait partie du produit vendu.

Acheter se défend quand

  • Les documents viennent de tiers dont le format n'est pas maîtrisé.
  • La donnée lue déclenche une décision engageante.
  • Les formats évoluent souvent et des métiers doivent pouvoir suivre.
  • La sécurité et la conformité sont demandées par les clients.
  • L'équipe technique a d'autres priorités.

Le plus court chemin pour se faire une idée consiste à tester sur ses propres documents, en choisissant les plus difficiles plutôt que les plus lisibles.

Tester sur vos documents

Questions fréquentes
Faut-il construire ou acheter un traitement documentaire ?

Construire est devenu rapide, un prototype demande quelques jours. La comparaison se joue sur ce qui suit : 39 difficultés qui apparaissent en production, le rapprochement des valeurs avec d'autres sources, le contrôle d'authenticité et l'entretien permanent. Construire garde du sens sur un document produit en interne, stable, à faible volume et sans enjeu de contrôle.

Peut-on construire un extracteur de documents avec un agent de codage ?

Oui, un prototype fonctionnel demande 3 à 5 jours. Il lit le PDF, extrait les champs par un appel à un modèle de langage, contrôle les métadonnées et expose une API. Les défis arrivent au-delà du prototypage lors d'un déploiement en production avec du volume, de l'hétérogénéité de formats, des dépendances externes, de la maintenance, des sujets d'infrastructure et de sécurité de la donnée.

Pourquoi un projet de traitement documentaire prend-il plus de temps que prévu ?

Parce que l'estimation initiale porte sur la lecture du document, alors que la charge réelle vient de la variété, du volume, et du rapprochement. Des dizaines de défis reviennent régulièrement en production. Chacun se règle en quelques heures, pris ensemble ils interagissent et génèrent une complexité et une difficulté souvent mal appréciée par les décideurs.

Un taux de précision de 85 % est-il suffisant ?

Cela dépend du cas d'usage. Pour les cas où il faut avoisiner les 100 % de fiabilité, les modèles de langage sont souvent mal dotés et il faut passer sur une solution spécialisée qui hybride vision par ordinateur et modèle de langage en optimisant en continu. Si un taux autour des 85 % suffit et que l'erreur est tolérable, alors une construction maison via des LLM est envisageable.

Quelle différence entre un OCR et un traitement documentaire intelligent ?

Un OCR convertit une image en texte. Un traitement documentaire intelligent identifie le type de document, découpe les liasses, extrait des champs définis à l'avance, fait du rapprochement de données, rend un score de confiance par valeur, contrôle la cohérence de l'ensemble, détecte la fraude documentaire.

Un modèle de langage peut-il vraiment vérifier qu'un document est authentique ?

Non. Un modèle de langage lit le sens du document. La vérification d'authenticité repose sur 3 couches différentes spécialisées : l'analyse de l'image, l'examen dédié et éduqué des métadonnées du fichier et la cohérence des valeurs entre elles.

Qu'est-ce qui coûte le plus cher dans un traitement documentaire construit en interne ?

La maintenance et l'optimisation dans la durée, et non pas la construction initiale. Les modèles changent tous les 2 ou 3 mois, les émetteurs modifient leurs formats sans prévenir, les clients veulent paramétrer de nouveaux cas d'usage, et les exigences de sécurité se renforcent. Ce travail occupe durablement une partie d'une équipe sur un sujet qui n'est généralement pas le métier cœur de l'organisation.

Dans quels cas construire reste-t-il la bonne décision ?

Quand le document est produit en interne, très structuré et stable, un développement dédié donne de meilleurs résultats qu'un moteur généraliste. Quand le volume est faible et prévisible, sur un format unique, et que la donnée lue ne déclenche pas de décision engageante. Et quand le traitement documentaire fait partie du produit vendu par l'organisation.

Sources

  1. Observations expertes issues de l'exploitation d'une plateforme de traitement de documents et de détection de fraude : Koncile.
Les agents qui automatisent vos documents
Prenez les devants sur l’automatisation. Découvrez comment Koncile peut simplifier vos opérations.
Découvrir Koncile
Découvrir Koncile
Nos derniers articles

Nos retours terrain sur l'automatisation documentaire

Toutes les ressources
Traitement de documents et détection de fraude : construire ou acheter ?
FEATURE

Traitement de documents et détection de fraude : construire ou acheter ?

Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.

Lire l’article
Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques
FEATURE

Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques

Amazon Textract est formellement éligible HIPAA depuis octobre 2019. La plupart des comparatifs OCR santé ne le vérifient jamais pour les autres outils de leur liste. Voici une reconstruction qui vérifie le statut de conformité directement, et qui regarde ce que les vrais essais cliniques sur les scribes IA ambiants ont trouvé, pas seulement le marketing.
Lire l’article
Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026
FEATURE

Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026

Un freelance qui envoie une douzaine de factures par mois peut dépasser le plafond du forfait le moins cher de Xero dès la troisième semaine, et FreshBooks plafonne à cinq clients. Le chiffre affiché sur une page tarifaire est rarement celui que vous payez réellement. Voici une comparaison honnête de QuickBooks, Xero, Wave et FreshBooks, pensée pour une entreprise d'une seule personne.
Lire l’article
OCR hébreu : ce qui marche sur les documents professionnels
Analyse

OCR hébreu : ce qui marche sur les documents professionnels

La plupart des éditeurs d'OCR annoncent prendre en charge l'hébreu. Beaucoup moins prennent en charge l'hébreu manuscrit, et aucun ne vous dit que 91 % de précision au caractère peut signifier qu'un mot sur deux est faux.
Lire l’article
Détecter un faux relevé de compte : nos 9 méthodes
Analyse

Détecter un faux relevé de compte : nos 9 méthodes

Le relevé de compte est un document particulièrement sujet à la fraude. Chez Koncile, on détecte jusqu'à 1,4 % de relevés modifiés ou altérés sur un jeu de 150 000 relevés. On parle beaucoup des deepfakes générés par l'IA, mais se focaliser uniquement là dessus aujourd'hui serait une erreur.

Lire l’article