Dans la santé, un OCR se juge sur ce qu’il signale, pas sur ce qu’il lit
Ce qu’un OCR doit garantir sur une ordonnance ou une prescription : lecture ligne à ligne, score de confiance par valeur, rapprochement de référentiel, traçabilité. Et pourquoi le contrôle humain reste la règle.
Tous les éditeurs d’OCR annoncent des taux de précision élevés, et la plupart les tiennent. Sur un document de santé, ce n’est pas le bon critère d’achat. Ce qui compte, c’est ce que l’outil fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule.
Sur une facture, une ligne mal lue coûte une correction. Sur une ordonnance, elle coûte un dosage. Le document n’est plus une source de données, c’est une instruction de soin, et le logiciel qui le lit entre dans une chaîne où l’erreur ne se rattrape pas toujours en aval.
C’est ce qui rend les critères d’achat habituels insuffisants. La question n’est pas de savoir ce qu’un OCR sait lire, tous les éditeurs annoncent des taux élevés et la plupart les tiennent. La question est de savoir ce qu’il fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule. Voici ce que nous avons appris en déployant des chaînes de traitement intelligent de documents chez des laboratoires, des hôpitaux, des prestataires de santé à domicile et des pharmacies.
Ce qu’un OCR doit garantir sur un document de santé
Lire la ligne, pas seulement l’en-tête
Beaucoup d’outils savent extraire un nom de patient, une date et un prescripteur. C’est la partie facile : ces champs sont peu nombreux, toujours situés au même endroit, et une erreur y est visible.
Le travail commence au corps du document. Une ordonnance, c’est six, dix, parfois vingt lignes de traitement, chacune avec sa molécule, son dosage, sa forme, sa posologie et sa durée. Une prescription de biologie, c’est une liste d’analyses qu’il faut restituer intégralement, sans en perdre ni en inventer. Un outil qui rend l’en-tête et résume le corps ne vous sert à rien.
Le test à faire est simple : comptez les lignes du document, comptez celles qui ressortent. Sur un lot d’ordonnances manuscrites traité chez un groupe de biologie médicale français, 301 analyses sont ressorties sur 304 présentes. C’est ce ratio-là qu’il faut regarder, pas le taux de reconnaissance de caractères.
Tenir les dosages, les unités et les formes
Le même traitement peut exister en dix dosages. La valeur extraite n’a donc aucun sens séparée de son unité, et une confusion entre deux présentations d’une même molécule produit une ligne parfaitement formée et parfaitement fausse.
Exigez que l’outil restitue systématiquement l’unité avec la valeur, qu’il sache normaliser quand vous le lui demandez, et qu’il signale les cas où l’unité est absente du document plutôt que de la déduire.
Traiter l’écriture manuscrite
Le manuscrit n’est pas un cas marginal dans ce secteur. Ordonnances rédigées à la main, annotations en marge, photos prises au téléphone par le patient lui-même, scans de mauvaise qualité : c’est le quotidien de la plupart des chaînes de traitement.
Un OCR classique, qui reconnaît des caractères sans comprendre ce qu’il lit, décroche sur ces documents. Une lecture sémantique, où le modèle interprète la structure et le sens du document, tient beaucoup mieux, parce qu’elle peut s’appuyer sur le contexte pour trancher entre deux lectures possibles. Sur le lot évoqué plus haut, 23 des 24 ordonnances étaient manuscrites.
La reconnaissance d’écriture manuscrite est une capacité à tester explicitement sur vos propres documents, jamais à supposer parce qu’elle figure sur une fiche produit.
Rapprocher chaque ligne d’un référentiel
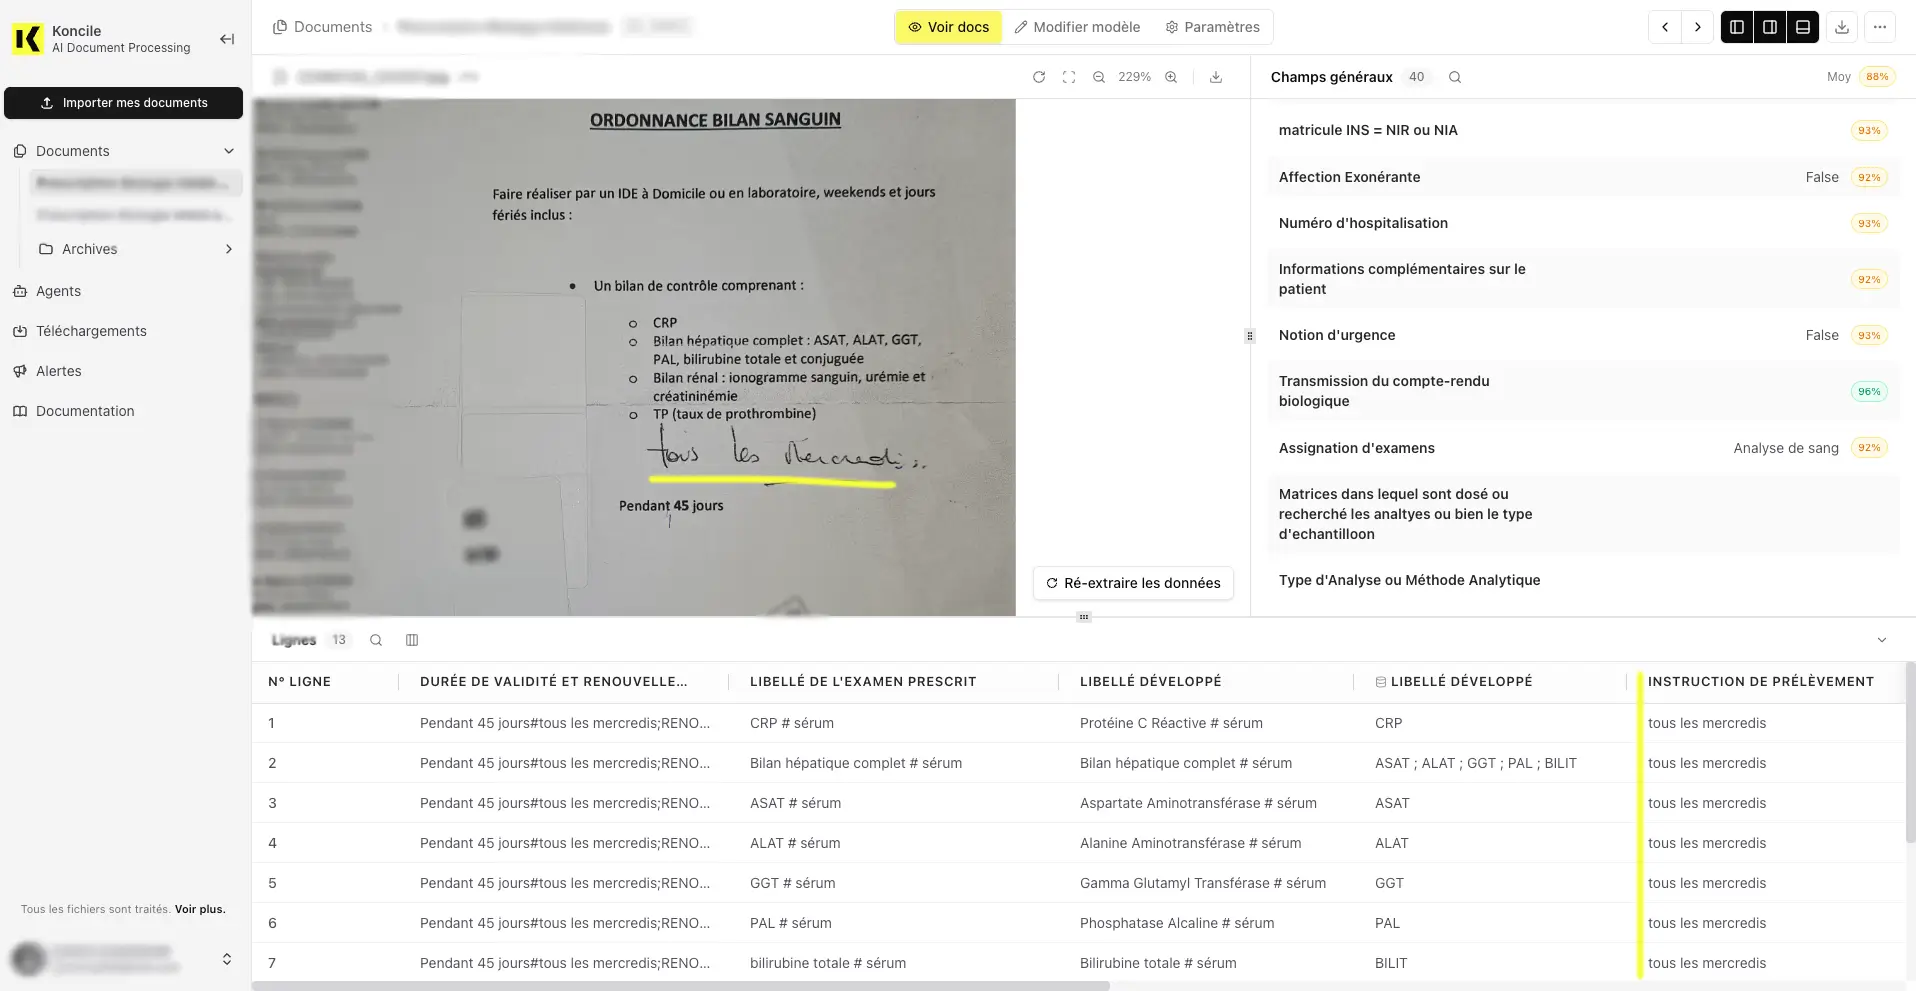
C’est l’exigence la plus souvent oubliée, et celle qui fait échouer le plus de projets. Aucun code produit ne circule sur une ordonnance. Il y a un libellé, écrit à la main par un prescripteur qui a ses habitudes, et il faut le relier à une entrée de votre nomenclature.
Extraire sans rapprocher, c’est déplacer le travail manuel, pas le supprimer. Vos équipes passeront de la saisie à la recherche dans un référentiel, ce qui est à peine plus rapide. C’est un problème de rapprochement de données autant que d’extraction, et il se traite avec ses propres méthodes.

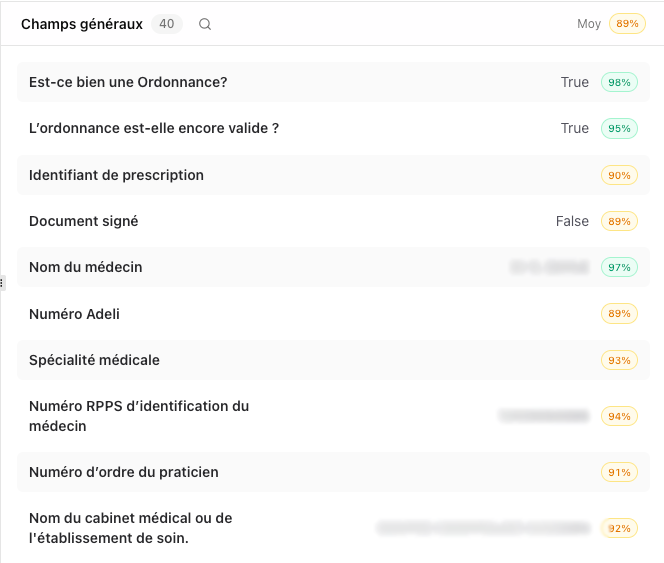
Donner un score de confiance par valeur, pas par document
C’est la distinction qui décide de tout le reste. Un score global au document ne vous apprend rien d’exploitable : il vous dit que quelque chose est peut-être faux quelque part.
Un score par valeur extraite vous dit quelle ligne regarder. C’est la différence entre relire un document entier et vérifier trois champs.
Tracer qui a vu quoi
Sur ces documents, la traçabilité n’est pas une fonctionnalité de confort. Vous devez pouvoir dire, des mois plus tard, quel document a été traité, par quel traitement, avec quel résultat, et qui y a accédé.
Pourquoi un très bon taux ne dispense pas du contrôle humain
Ce que le pourcentage restant représente
Nos déploiements tournent autour de 99 % de lignes correctement extraites. C’est un bon niveau, et c’est exactement pour cela qu’il faut le regarder de près.
Un prestataire qui traite un million de pages par an avec 99 % de réussite produit dix mille lignes erronées dans l’année. Dans ce secteur, une ligne erronée n’est pas une anomalie statistique : c’est une posologie, un patient, un acte facturé. Le pourcentage manquant ne devient jamais négligeable parce qu’il est petit, il devient dangereux parce qu’il est invisible.
Aucun éditeur sérieux ne devrait vous vendre la suppression de la relecture sur ce type de document. Nous ne le faisons pas, et nos clients du secteur ne nous le demandent pas : ils intègrent l’extraction comme une brique supplémentaire dans une chaîne de vérification qui reste la leur.
Toutes les erreurs n’ont pas le même coût
Un nom de prescripteur mal orthographié se corrige au fil de l’eau. Un dosage confondu, une analyse rattachée au mauvais code, un tube prescrit dans le mauvais milieu de prélèvement ne se corrigent pas de la même façon.
C’est pourquoi le bon indicateur n’est pas un taux moyen, mais la répartition des erreurs par criticité. Demandez à votre fournisseur de la produire sur vos propres documents.
Ce qui se passe quand ces exigences ne sont pas posées
Un modèle qui ne sait pas préfère répondre
C’est le comportement le plus dangereux, et le moins connu des acheteurs. Face à une information absente ou illisible, un modèle génératif a tendance à combler plutôt qu’à se taire.
Deux exemples relevés en production. Quand un prescripteur oublie la mention du lieu, le modèle va chercher la ville dans l’en-tête du cabinet et la restitue comme si elle figurait sur l’ordonnance. Quand la civilité indique « Madame », il en déduit le genre du patient, ce qui est faux dans une partie des cas et particulièrement problématique pour les personnes transgenres.
Le cas le plus parlant nous est venu d’un contrôle de pièces d’identité. Le système a rendu ceci : les documents semblent cohérents entre eux, sans signe évident de fraude, mais l’absence d’informations lisibles sur la carte Vitale empêche de vérifier l’identité. Une phrase rassurante sur un dossier qu’il n’avait pas pu vérifier. Un opérateur pressé retient la première moitié.
Un OCR de santé doit être configuré pour préférer le silence à l’invention, et pour remonter explicitement ce qu’il n’a pas pu lire.
Le référentiel qui casse en silence
Un cas qu’il nous a fallu plusieurs itérations à comprendre. Chez un client, une analyse ne remontait jamais. Pas d’erreur, pas d’alerte, simplement une ligne absente à chaque fois.
La cause n’était pas dans le modèle. Le code de cette analyse dans le référentiel du client était NA, et la chaîne d’import l’interprétait comme la valeur « non applicable ». L’entrée disparaissait avant même que le rapprochement commence. Le contournement a tenu en une lettre : le code est devenu NAS, et c’est sous cette forme qu’il apparaît sur la capture du rapprochement, plus haut.
Un autre client constatait des trous de codage inexplicables. Le fichier de nomenclature chargé pour la démonstration était une version simplifiée, amputée d’une partie des entrées.
Dans les deux cas, le moteur d’extraction fonctionnait parfaitement. C’est la chaîne autour qui produisait le défaut, et aucun taux de précision ne l’aurait révélé.
L’écart entre le document et la saisie
Le point de comparaison qu’on oublie de prendre, c’est l’existant. Lorsque nous avons comparé les données extraites automatiquement avec les saisies manuelles d’un prestataire de santé à domicile, environ un dossier sur quarante présentait un écart entre l’ordonnance et ce qui avait été enregistré dans le système.
Ce chiffre n’est pas un argument contre les équipes, c’est la réalité d’une tâche répétitive exécutée sous contrainte de volume. Il dit surtout que la question n’est pas « l’automatisation est-elle assez fiable », mais « par rapport à quoi ».
Le contrôle humain n’est pas un échec de l’automatisation, c’est sa condition
Une brique de vérification, pas un remplacement
Les acteurs de santé qui réussissent leur projet ne branchent pas un OCR pour supprimer une étape. Ils l’insèrent dans un workflow documentaire qui comptait déjà plusieurs contrôles, pour que la vérification humaine s’exerce sur une donnée déjà structurée plutôt que sur un PDF.
Le gain n’est pas la disparition de la relecture. C’est que la relecture porte enfin sur quelque chose de comparable, ligne à ligne, au lieu d’obliger l’opérateur à reconstituer mentalement le document.
Cibler le contrôle au lieu de tout relire
C’est là que le score de confiance par valeur prend son sens opérationnel. Vous définissez un seuil, les lignes en dessous remontent à un opérateur, les autres passent.
Le réglage de ce seuil est une décision métier, pas technique. Il dépend de ce que coûte une erreur dans votre chaîne, et il doit pouvoir être ajusté sans redéploiement.
Chez un prestataire traitant des dizaines de milliers d’ordonnances par mois, la relecture complète prenait 3 minutes 40 par document. Avec une extraction préalable et un contrôle ciblé, le traitement descend à 25 secondes suivies d’une vérification. Sur le volume d’une année, l’économie dépasse 9 000 heures, soit près de six équivalents temps plein. Ces personnes n’ont pas disparu, elles ont cessé de recopier.
Les bonnes pratiques d’intégration
Constituer un jeu de test sans exporter de données patient
C’est le premier obstacle concret, et il est juridique avant d’être technique. Dans la santé, vous n’avez souvent pas le droit de transmettre des documents réels à un prestataire pour un essai, ce qui rend le conseil habituel du « testez sur vos vrais documents » inapplicable tel quel.
Trois voies fonctionnent. Constituer un corpus de documents fabriqués reproduisant vos cas difficiles, ce qui est plus rapide qu’il n’y paraît. Anonymiser en amont, à condition que l’anonymisation porte sur l’ensemble des éléments ré-identifiants et pas seulement sur le nom. Ou monter une procédure de consentement patient, qui prend du temps mais autorise les documents réels.
Prévoyez cette étape dès le cadrage. Un projet qui découvre le problème au moment du pilote perd plusieurs semaines.
Tester sur votre référentiel complet, pas sur celui de la démonstration
C’est la leçon du cas précédent. Chargez votre nomenclature entière, avec ses codes exotiques, ses doublons et ses entrées historiques. C’est là que les défauts apparaissent, jamais sur un extrait de quinze lignes préparé pour la présentation.
Mesurer l’écart avec l’existant avant de décider
Avant de fixer un objectif de précision, mesurez le taux d’écart de votre processus actuel. Vous obtiendrez une base de comparaison honnête, et souvent une surprise.
Définir les seuils de remontée
Décidez explicitement quelles valeurs ne passent jamais sans contrôle humain, quel que soit le score. Les dosages et les identités appartiennent généralement à cette catégorie.
Séparer les environnements et versionner les modèles
Vos règles d’extraction vont évoluer. Elles doivent pouvoir le faire sans toucher à la production, et vous devez pouvoir revenir en arrière. Un fournisseur qui ne propose ni environnement de test séparé ni versionnement vous oblige à choisir entre l’immobilisme et le risque.
Monter en volume progressivement
Un lot, puis un flux limité, puis la bascule. Chaque palier doit avoir son critère de passage, défini avant de commencer.
Ce que la conformité impose en plus
Les questions que vos acheteurs poseront de toute façon
Les directions de la sécurité et les délégués à la protection des données du secteur ont professionnalisé leurs revues fournisseurs. Les questionnaires couvrent désormais le RGPD, la sécurité et, pour les acteurs financiers du secteur, DORA. Certains groupes les font passer par des plateformes dédiées et considèrent la vérification de conformité comme un préalable non négociable à toute sélection.
Anticipez-les. Les points qui reviennent systématiquement :
- où sont hébergées les données, et l’hébergeur est-il certifié HDS
- quelle est la durée de rétention, et est-elle paramétrable
- existe-t-il un moyen de supprimer un document précis, et de vérifier qu’il a bien disparu
- les données traitées servent-elles à entraîner les modèles
- le contrat comporte-t-il les clauses du sous-traitant au sens de l’article 28 du RGPD
À ces questions s’ajoute désormais celle du cadre applicable à l’IA elle-même. Selon l’usage qui en est fait, un système d’extraction inséré dans une chaîne de soin peut relever d’obligations supplémentaires au titre de l’AI Act. Le sujet apparaît encore rarement dans les revues fournisseurs, et il vaut mieux l’instruire au cadrage que le découvrir en comité.
Le numéro de sécurité sociale, un cas à part
Contre-intuitif mais important : le numéro de sécurité sociale n’est pas juridiquement une donnée de santé. Il relève d’un régime propre, plus contraignant à certains égards, parce que sa structure est connue de tous et qu’il permet d’identifier une personne sans ambiguïté. Les usages autorisés sont énumérés par les textes, et ce qui n’y figure pas n’est pas permis.
Si votre chaîne extrait ce numéro, vérifiez que votre finalité entre bien dans les cas prévus. C’est un angle mort fréquent dans les projets de dématérialisation.
Vérifier plutôt que croire
Une bonne pratique observée chez un client exigeant : conserver l’identifiant renvoyé à chaque envoi de document, précisément pour pouvoir aller vérifier, plus tard, que la donnée a bien été supprimée. La capacité de suppression annoncée ne vaut que si vous pouvez la contrôler.
Ce que ça donne en production
Les ordres de grandeur que nous observons chez nos clients du secteur santé, sur des chaînes en production : de l’ordre de 99 % des lignes correctement extraites, avec des documents majoritairement manuscrits ; un temps de traitement par document divisé par plusieurs ordres de grandeur, la relecture ciblée remplaçant la relecture intégrale ; et un écart mesuré d’environ un dossier sur quarante entre les documents et les saisies manuelles antérieures.
Ces chiffres ne disent pas que l’humain est devenu inutile. Ils disent où il doit désormais se placer.
Pour aller plus loin sur les outils du marché, voir notre comparatif des OCR pour le médical.
Évaluer un OCR sur vos propres documents
Si vos équipes ressaisissent des ordonnances, des prescriptions ou des pièces administratives patient, et que vous voulez savoir ce qu’une extraction automatisée donnerait chez vous, nous paramétrons vos champs, vos règles et votre nomenclature. Vous jugez sur votre propre corpus, et vous pouvez commencer par regarder notre extraction pour la santé.
Nos retours terrain sur l'automatisation documentaire
Traitement de documents et détection de fraude : construire ou acheter ?
Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.
Dans la santé, un OCR se juge sur ce qu’il signale, pas sur ce qu’il lit
Tous les éditeurs d’OCR annoncent des taux de précision élevés, et la plupart les tiennent. Sur un document de santé, ce n’est pas le bon critère d’achat. Ce qui compte, c’est ce que l’outil fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule.

Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques
Amazon Textract est formellement éligible HIPAA depuis octobre 2019. La plupart des comparatifs OCR santé ne le vérifient jamais pour les autres outils de leur liste. Voici une reconstruction qui vérifie le statut de conformité directement, et qui regarde ce que les vrais essais cliniques sur les scribes IA ambiants ont trouvé, pas seulement le marketing.
Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026
Un freelance qui envoie une douzaine de factures par mois peut dépasser le plafond du forfait le moins cher de Xero dès la troisième semaine, et FreshBooks plafonne à cinq clients. Le chiffre affiché sur une page tarifaire est rarement celui que vous payez réellement. Voici une comparaison honnête de QuickBooks, Xero, Wave et FreshBooks, pensée pour une entreprise d'une seule personne.
OCR hébreu : ce qui marche sur les documents professionnels
La plupart des éditeurs d'OCR annoncent prendre en charge l'hébreu. Beaucoup moins prennent en charge l'hébreu manuscrit, et aucun ne vous dit que 91 % de précision au caractère peut signifier qu'un mot sur deux est faux.