Qu’est-ce que le Natural Language Processing (NLP) ?
Découvrez comment le NLP comprend et génère le langage, tandis que l’OCR convertit images et PDF en texte exploitable. Combinés, ils accélèrent l’extraction d’informations, réduisent les erreurs et renforcent la qualité des processus.
Le NLP (traitement du langage naturel) permet aux systèmes de comprendre et de produire du texte de façon fiable. Cet article présente l’essentiel : définition, cas d’usage, étapes clés et articulation avec l’OCR pour des processus documentaires plus rapides et précis.
Qu’est-ce que le NLP ?
Le Natural Langage Processing NLP (ou traitement du langage naturel en français) est un domaine de l’intelligence artificielle et du machine learning qui permet, via des algorithmes linguistiques et statistiques, de comprendre le langage naturel humain.
Son objectif principal est donc de permettre aux machines de comprendre, d’interpréter et de produire la langue humaine de manière à la fois pertinente et utile.
La majorité des utilisateurs ont déjà interagi avec le NLP sans en avoir vraiment conscience.
Cette technologie est en effet au cœur des assistants virtuels tels qu’Oracle Digital Assistant (ODA), Siri ou Alexa. Elle leur permet de comprendre les requêtes des utilisateurs et d’y répondre dans un langage naturel. De la même manière, certaines applications de messagerie s’appuient sur le NLP pour analyser le contenu d’un message et proposer automatiquement une réponse adaptée.
NLP vs NLU vs NLG : différences clés
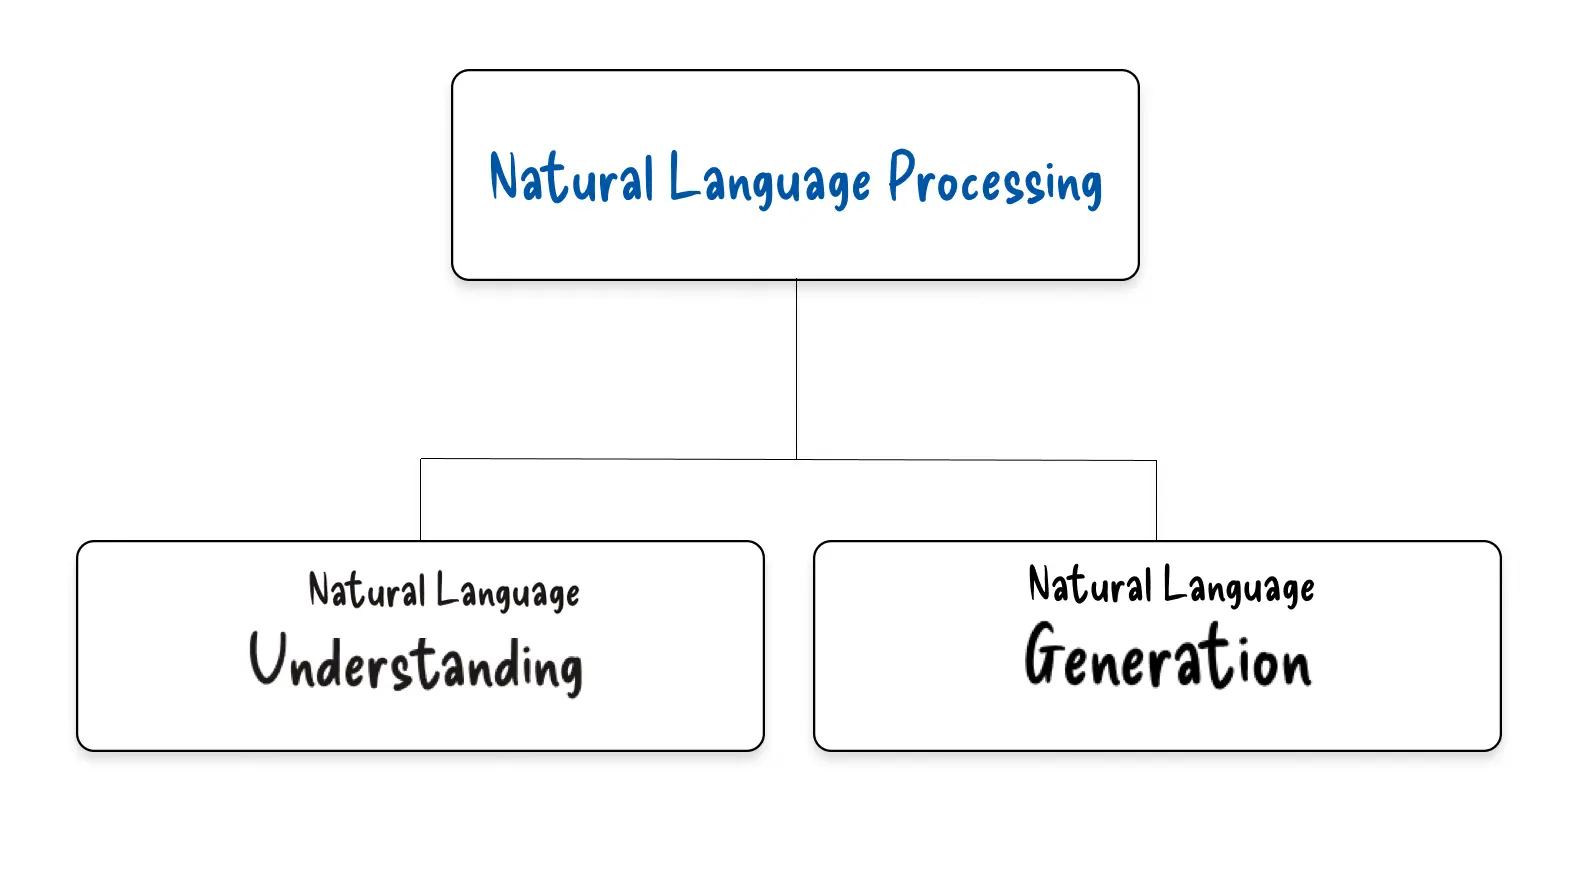
Dans l’univers du traitement automatique du langage, plusieurs termes voisins coexistent et prêtent parfois à confusion. Le NLP (Natural Language Processing), le NLU (Natural Language Understanding) et le NLG (Natural Language Generation) désignent en réalité des approches complémentaires autour du langage naturel.
- NLU (Natural Language Understanding) correspond à la capacité des machines à analyser et comprendre la structure et le sens d’une phrase exprimée par un humain. Il s’agit de l’aspect « compréhension », permettant d’interagir avec les ordinateurs en utilisant des phrases naturelles.
- NLG (Natural Language Generation) se concentre sur la production de texte à partir de données. On parle aussi de « language out » : l’ordinateur génère une description verbale, un résumé ou une explication en langage clair, souvent à l’aide de modèles linguistiques ou de règles (parfois appelées grammaire des graphiques).
- NLP (Natural Language Processing), plus large, englobe à la fois la compréhension et la génération du langage. C’est le domaine d’ingénierie qui vise à construire des systèmes capables de traiter, analyser, produire et manipuler le langage humain.
En parallèle, la linguistique informatique (Computational Linguistics – CL) constitue le champ scientifique qui étudie les aspects théoriques et informatiques du langage humain, tandis que le NLP met l’accent sur l’application concrète et l’ingénierie de solutions exploitables.
Les principales applications du NLP
Le traitement automatique du langage naturel couvre un large éventail d’usages et façonne de plus en plus nos pratiques quotidiennes.
Voici un aperçu de ses usages les plus marquants :
Les 6 étapes clés du traitement du langage naturel (NLP)
Le traitement automatique du langage naturel (NLP) suit un pipeline structuré, combinant des techniques linguistiques, statistiques et d’apprentissage automatique.Voici les grandes étapes qui permettent de transformer un texte brut en informations exploitables.
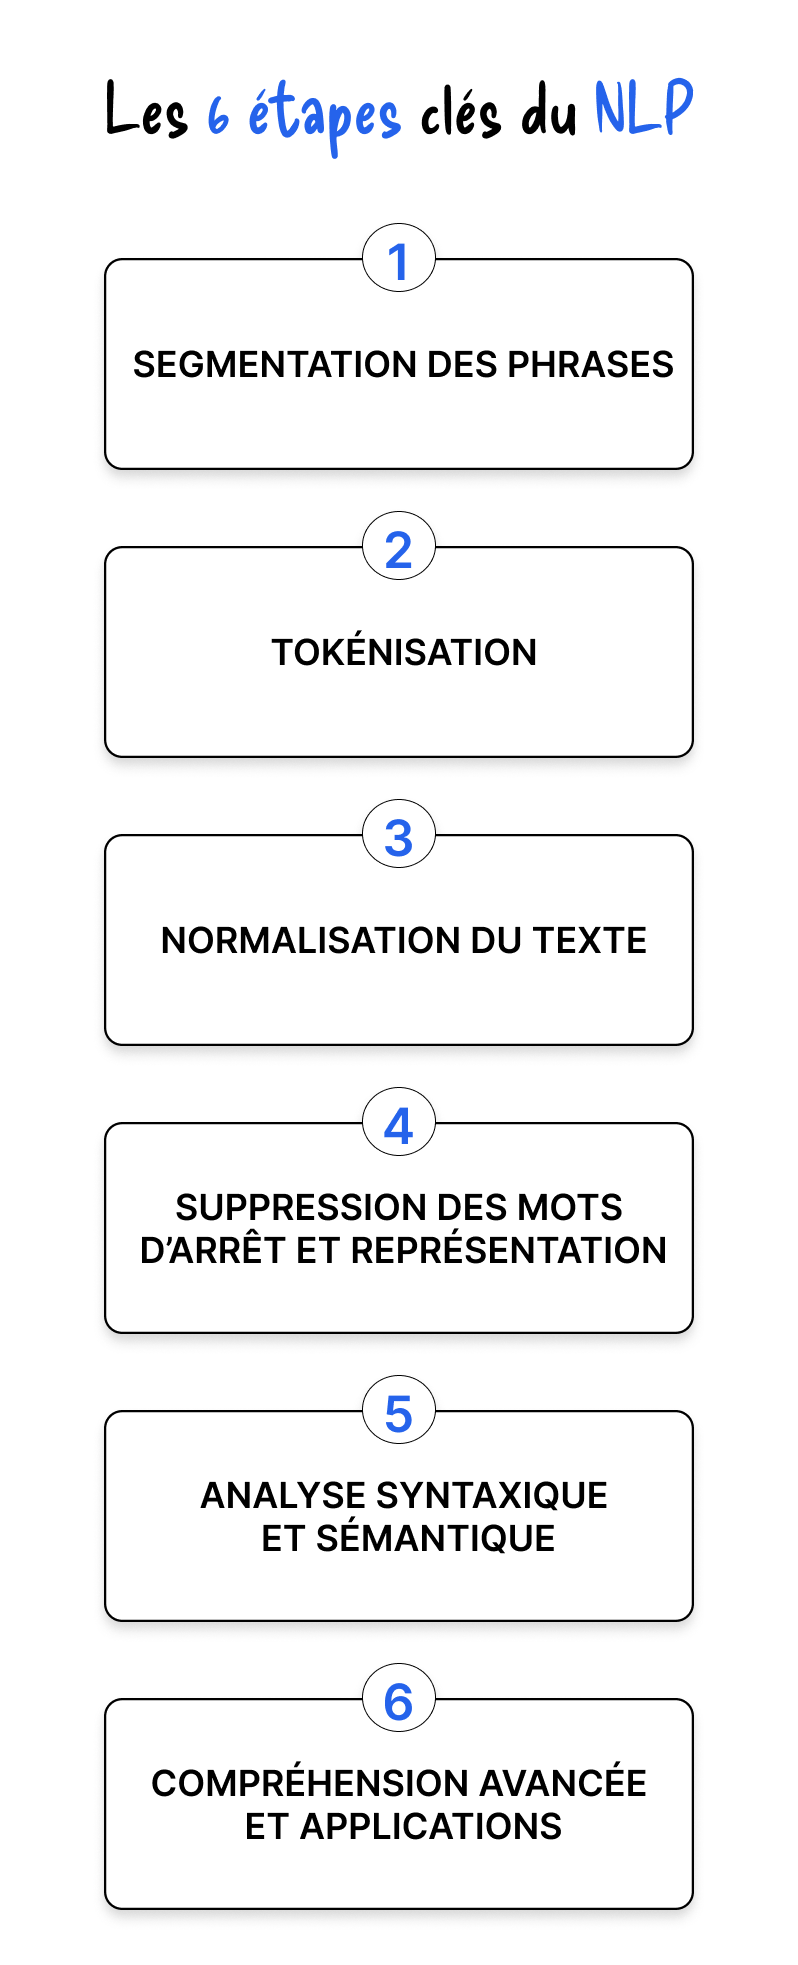
1. Segmentation des phrases
Le processus commence par la segmentation, qui découpe un texte en phrases distinctes. Un algorithme identifie les signes de ponctuation (points, exclamations, interrogations) afin d’isoler des unités de sens complètes.Tout commence par la segmentation, qui consiste à découper un texte en phrases distinctes.
2. Tokénisation
La tokénisation divise chaque phrase en unités élémentaires appelées tokens : mots, sous-mots, chiffres ou ponctuation.
Cette étape prépare le terrain pour l’analyse grammaticale et sémantique.
3. Normalisation du texte
Le texte est ensuite simplifié pour réduire la variabilité linguistique.
Deux techniques principales sont utilisées :
- La racinisation (stemming) : coupe les suffixes pour garder uniquement la racine du mot (“mangé” → “mang”).
- La lemmatisation : ramène le mot à sa forme canonique correcte (“mangé” → “manger”).
Cette étape garantit une meilleure cohérence dans l’analyse des données textuelles.
4. Suppression des mots d’arrêt et représentation
Certains mots fréquents, dits stop words (“et”, “de”, “le”), sont supprimés car ils apportent peu d’information.
Ensuite, le texte est converti en données numériques exploitables :
- via un modèle sac de mots (bag-of-words) ou un TF-IDF,
- ou via des embeddings (Word2Vec, BERT) qui capturent le sens et le contexte des mots.
5. Analyse syntaxique et sémantique
À cette étape, le système cherche à comprendre la structure des phrases :
- PoS tagging : attribuer à chaque mot sa fonction grammaticale (nom, verbe, adjectif…).
- Parsing syntaxique : identifier les relations sujet–verbe–complément.
- NER (Named Entity Recognition) : extraire des entités comme des personnes, des lieux ou des organisations.
6. Compréhension avancée et applications
Enfin, le texte peut être exploité dans des applications concrètes :
- analyse de sentiment (positif, négatif, neutre),
- résumé automatique ou traduction,
- résolution de coréférence (“Jean est arrivé. Il était fatigué” → “Il” = “Jean”).
C’est à ce stade que le NLP devient directement utile dans des cas métiers : chatbots, moteurs de recherche, extraction documentaire (OCR + NLP), assistants virtuels, etc.
Les défis du NLP

Malgré ses avancées spectaculaires, cette discipline se heurte encore à plusieurs obstacles techniques et linguistiques qui limitent son déploiement à grande échelle.
Quand l’OCR rencontre le NLP
La reconnaissance optique de caractères (OCR) est la technologie qui permet de transformer une image contenant du texte imprimé ou manuscrit (facture scannée, contrat signé, note de frais, formulaire, etc.) en texte numérique exploitable.
Cette étape est essentielle pour convertir des documents papier ou des fichiers image en données structurées, prêtes à être traitées par un ordinateur.
Là où l’OCR se limite à capturer fidèlement le texte, le NLP ajoute une couche d’intelligence et de compréhension contextuelle. Il est capable de classer, contextualiser et extraire les informations pertinentes, transformant ainsi un texte brut en données immédiatement exploitables par les systèmes métiers.
En résumé : l’OCR numérise, le NLP comprend.
Ce que permet l’intégration OCR + NLP
L’association de l’OCR et du NLP présente plusieurs atouts pour les entreprises :
FAQ
Nos retours terrain sur l'automatisation documentaire
Les 5 meilleures solutions OCR françaises pour extraire les données de vos documents
Cinq solutions OCR françaises permettent aujourd'hui d'extraire automatiquement les données de vos factures, contrats et documents comptables grâce à la reconnaissance optique de caractères, avec un hébergement localisé en France. On les présente ici.
Traitement de documents et détection de fraude : construire ou acheter ?
Extraire et structurer les données de documents, les enrichir, détecter la fraude : avec l'IA, construire sa solution de bout en bout n'a jamais paru aussi simple. Acheter une solution prête à l'emploi reste pourtant souvent la meilleure option. Voici les trente-neuf difficultés à anticiper avant de se lancer.
Dans la santé, un OCR se juge sur ce qu’il signale, pas sur ce qu’il lit
Tous les éditeurs d’OCR annoncent des taux de précision élevés, et la plupart les tiennent. Sur un document de santé, ce n’est pas le bon critère d’achat. Ce qui compte, c’est ce que l’outil fait quand il n’est pas sûr, ce qu’il vous permet de vérifier, et ce qu’il garantit sur la donnée qu’il manipule.

Meilleurs outils OCR santé : conformité HIPAA et ce que montrent les données cliniques
Amazon Textract est formellement éligible HIPAA depuis octobre 2019. La plupart des comparatifs OCR santé ne le vérifient jamais pour les autres outils de leur liste. Voici une reconstruction qui vérifie le statut de conformité directement, et qui regarde ce que les vrais essais cliniques sur les scribes IA ambiants ont trouvé, pas seulement le marketing.
Meilleurs logiciels de comptabilité pour indépendants et freelances en 2026
Un freelance qui envoie une douzaine de factures par mois peut dépasser le plafond du forfait le moins cher de Xero dès la troisième semaine, et FreshBooks plafonne à cinq clients. Le chiffre affiché sur une page tarifaire est rarement celui que vous payez réellement. Voici une comparaison honnête de QuickBooks, Xero, Wave et FreshBooks, pensée pour une entreprise d'une seule personne.