ETL : tout comprendre sur le processus d’Extract, Transform, Load
L’ETL permet d’extraire, transformer et charger des données pour les rendre exploitables. Ce guide complet vous aide à en comprendre les enjeux, les étapes et les solutions du marché.
Les solutions ETL jouent un rôle central en simplifiant la gestion, le nettoyage, l'enrichissement et la consolidation des données provenant de diverses sources. Dans cet article de blog, nous allons expliquer clairement ce qu’est l’ETL, son processus, quels bénéfices il apporte aux organisations, des exemples concrets d’utilisation, ainsi qu’un panorama de quelques outils ETL populaires avec leurs avantages respectifs.
Qu’est-ce que l’ETL ?
L’ETL, pour Extract, Transform, Load, désigne un processus d’intégration de données qui combine trois opérations essentielles : extraire la donnée depuis différentes sources, la transformer pour la rendre cohérente, puis la charger dans un système cible comme un entrepôt de données ou un data lake.
L’objectif est simple : prendre des données brutes dispersées, souvent hétérogènes, et les convertir en un ensemble structuré et exploitable pour les analyses, les tableaux de bord, la conformité, ou les applications métiers.
L’ETL constitue encore aujourd’hui un pilier de l’ingénierie des données, même s’il cohabite désormais avec des approches plus modernes comme l’ELT ou le streaming.
Les étapes clés du processus ETL
Le processus ETL classique repose sur trois grandes étapes :
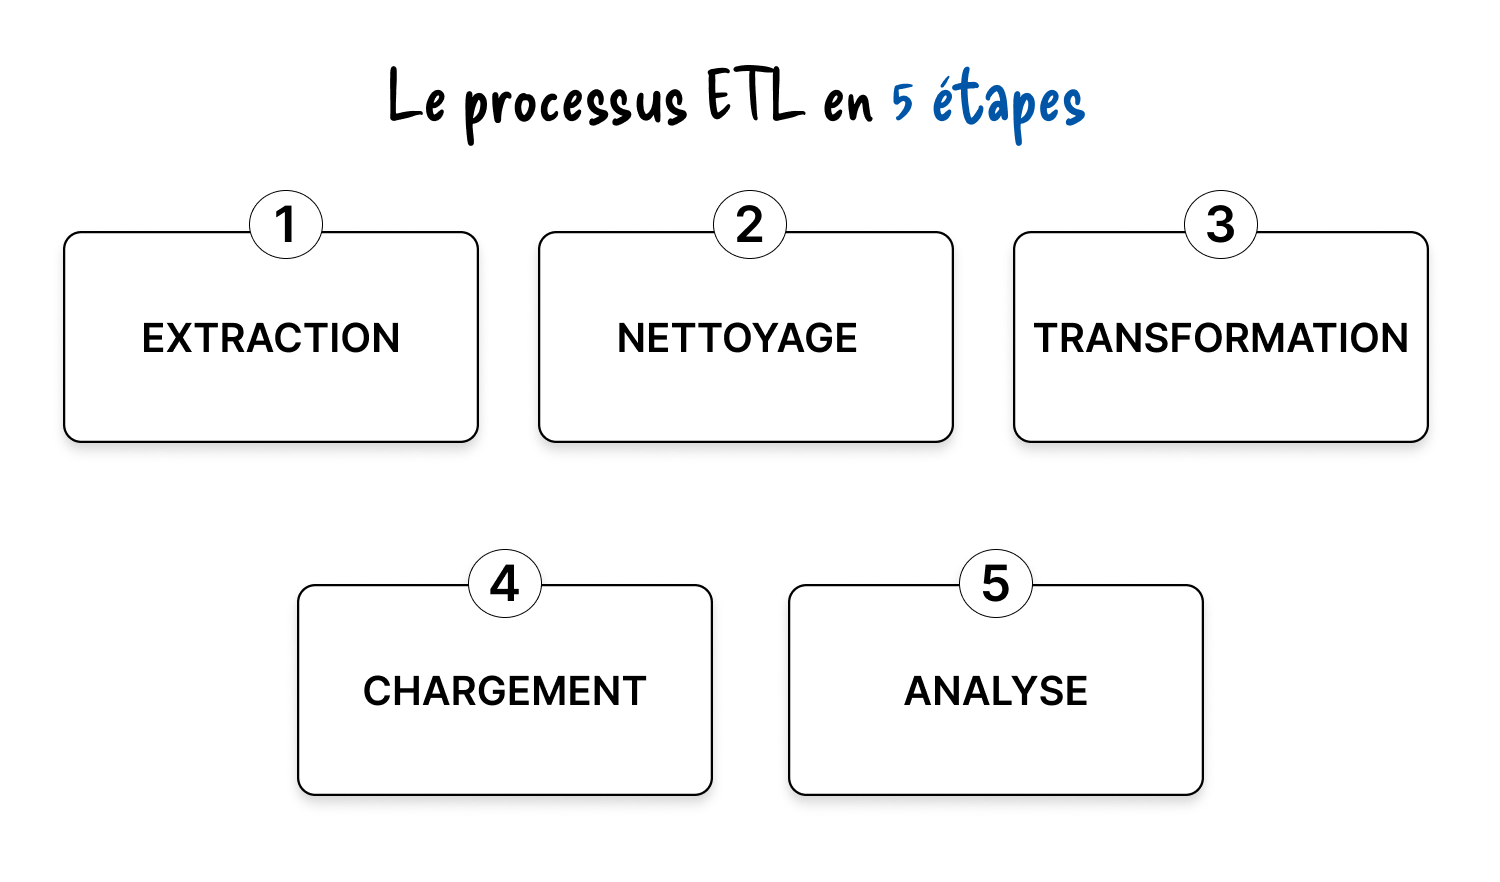
Mais dans la pratique opérationnelle, beaucoup d’équipes data travaillent en réalité selon un cycle en cinq étapes :
- Extraction
- Data cleaning
- Transformation
- Loading
- Analyse & exploitation
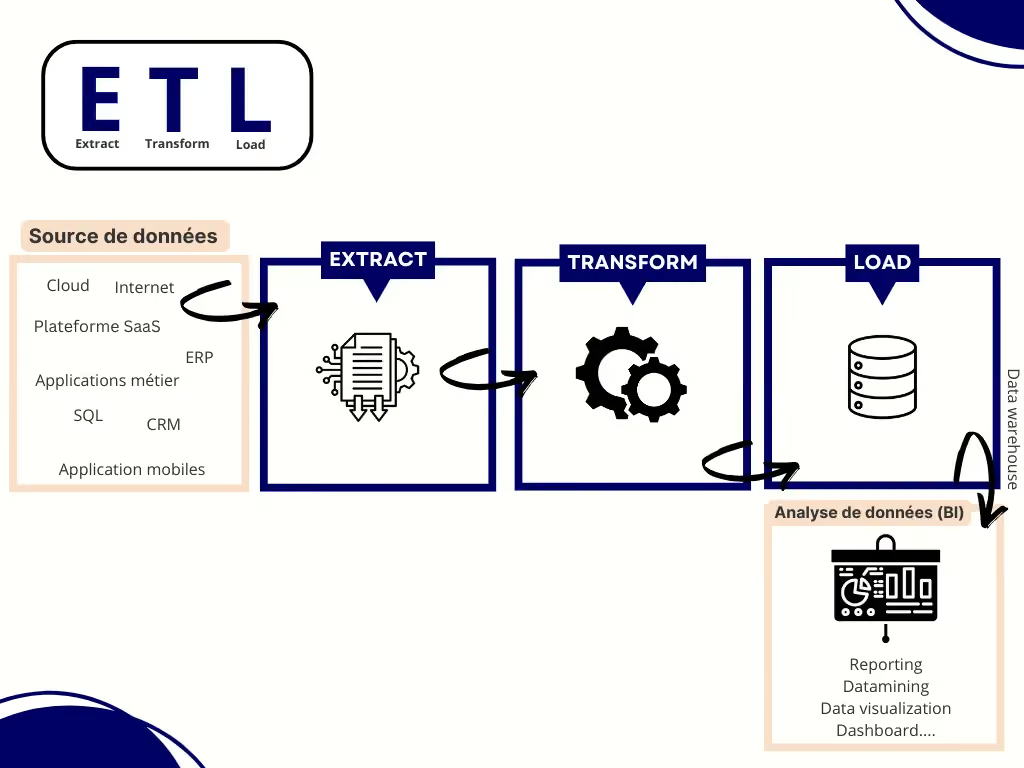
Ces étapes sont orchestrées au sein de pipelines automatisés, sur des cadences variables : batch, temps réel, streaming continu…
1. Extraction : collecter les données à la source
L’extraction consiste à récupérer des données issues de sources internes (ERP, CRM, bases SQL, fichiers Excel, API internes) ou externes (API publiques, services partenaires, open data…).
Ces données peuvent être structurées (SQL), semi-structurées (JSON), ou non structurées (PDF, logs, images, emails…).
Elles transitent généralement par une zone intermédiaire, avant transformation.
Trois grandes méthodes d’extraction existent :
• Extraction complète : tout extraire à chaque cycle. Pratique pour un premier chargement ou de petits volumes.
• Extraction incrémentale : ne prendre que les données nouvelles ou modifiées, indispensable pour les gros volumes.
• Notification de mise à jour : la source prévient lorsque la donnée change. C’est la base du near real time.
2. Data Cleaning : fiabiliser les données brutes
Avant toute transformation avancée, les données doivent être nettoyées. C’est l’une des étapes les plus critiques de l’ETL, car elle conditionne la qualité finale du pipeline.
Le nettoyage inclut :
• Suppression des doublons
• Correction des valeurs erronées
• Gestion des valeurs manquantes
• Normalisation (encodages, formats de dates, unités…)
• Détection d’anomalies simples
Une donnée mal nettoyée peut fausser un modèle, un reporting ou un calcul métier. Cette étape assure la cohérence et la qualité globale du pipeline.
3. Transformation : standardiser, enrichir et structurer
La transformation adapte les données aux besoins métiers, aux contraintes techniques ou aux modèles d’analyse.
Elle inclut notamment :
• Conversions de formats (dates, devises, unités…)
• Jointures entre plusieurs sources
• Calculs métiers : marges, indicateurs globaux, regroupements…
• Création de champs dérivés utiles aux analyses
• Chiffrement ou masquage des données sensibles (RGPD, conformité)
• Normalisation ou dénormalisation des schémas selon la stratégie choisie
Le but est d’obtenir une donnée hautement qualitative, exploitable telle quelle dans un entrepôt ou un data lake.
4. Loading : charger et synchroniser les données dans le système cible
Une fois transformées, les données sont envoyées vers un système cible : data warehouse, data lake, moteur d’analytique, outil de BI, ou encore applications métiers.
Plusieurs stratégies de chargement existent :
• Chargement complet : remplacement total à chaque cycle
• Chargement incrémental : ajout / mise à jour des données modifiées
• Chargement par lots (batch) : exécution planifiée
• Streaming : alimentation en flux continu
• Bulk load : transfert massif optimisé
À ce stade, les données deviennent accessibles pour les équipes métiers, la BI, ou les modèles de machine learning.
5. Analyse & exploitation : créer de la valeur
Une fois centralisées et nettoyées, les données servent à :
• Construire des dashboards fiables
• Alimenter les reporting automatisés
• Déclencher des alertes ou des workflows
• Entraîner des modèles prédictifs
• Croiser des volumes massifs de données métiers
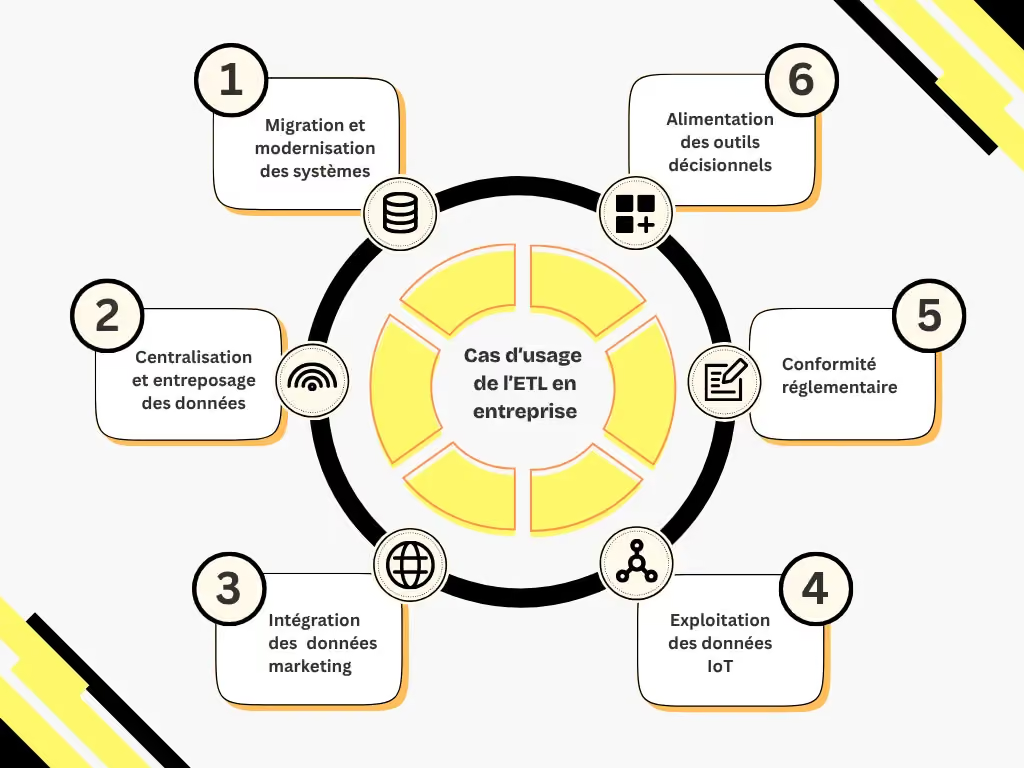
L’ETL rend possible l’exploitation de données multi-sources au service de la performance opérationnelle.
Les principaux cas d’usage de l’ETL
L’ETL intervient dans la majorité des projets où la donnée doit être synchronisée, nettoyée, consolidée ou gouvernée.
Migration et modernisation des systèmes
Lors d’un changement d’ERP, de CRM ou d’infrastructure, l’ETL gère la migration des données depuis les anciens systèmes. Il permet également de synchroniser plusieurs systèmes sans interrompre les opérations.
Centralisation des données et Data Warehousing
L’ETL collecte des données hétérogènes (ERP, CRM, fichiers, API…) et les transforme afin d’alimenter un entrepôt de données.
Cette centralisation permet des analyses transversales fiables.
Intégration marketing multicanal
L’ETL structure les données clients issues de sources variées : e-commerce, réseaux sociaux, campagnes, CRM…
Il ouvre la voie à :
• Une meilleure segmentation
• Des analyses du parcours client
• Des actions personnalisées
IoT et exploitation des capteurs
Dans l’industrie ou la logistique, les objets connectés produisent des volumes massifs de signaux.
L’ETL sert à :
• Collecter en continu
• Standardiser
• Enrichir
• Préparer les données pour la maintenance prédictive ou l’optimisation opérationnelle
Conformité réglementaire
L’ETL assure :
• Identification des données sensibles
• Transformation ou anonymisation
• Traçabilité complète
• Aide à la conformité (RGPD, HIPAA, CCPA…)
Les bénéfices de l’ETL pour les entreprises
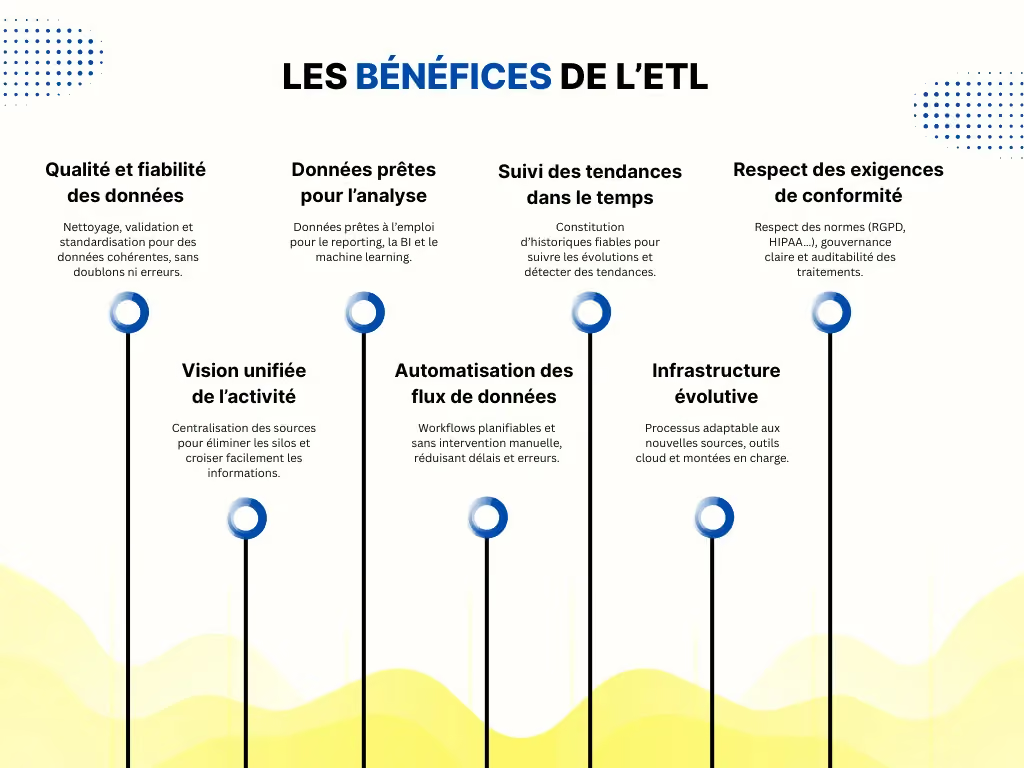
Les avantages concrets incluent :
• Amélioration de la qualité des données
• Automatisation des flux et réduction des tâches manuelles
• Vision consolidée de l’activité
• Accélération des analyses et de la prise de décision
• Réduction des erreurs humaines
• Meilleure gouvernance de la donnée
Les défis de l’ETL et comment les anticiper
Même si l’ETL est puissant, plusieurs points d’attention doivent être anticipés.
Gérer des sources hétérogènes
Chaque source a son propre format et rythme de mise à jour.
Un pipeline peut devenir instable si un schéma change ou si une API devient intermittente.
Définir des règles de transformation robustes
Les données peuvent être :
• Incomplètes
• Mal formatées
• Soumises à des règles métiers changeantes
Une mauvaise transformation peut invalider des analyses.
D’où l’importance des tests, de la documentation et de la gouvernance.
Passer à l’échelle
Lorsque les volumes augmentent, les pipelines doivent rester rapides et fiables.
Cela implique :
• Traitement incrémental
• Parallélisation
• Optimisations techniques
• Éventuel passage à l’ELT ou au streaming
Maintenir des pipelines évolutifs
Les pipelines doivent être :
• Modulaires
• Testables
• Adaptés aux changements réguliers
• Faciles à faire évoluer
Sans cela, les coûts de maintenance explosent.
Assurer qualité et traçabilité
Il faut intégrer :
• Des contrôles automatiques
• Du data profiling
• De la data lineage pour suivre l’historique de chaque donnée
Les différents types d’outils ETL
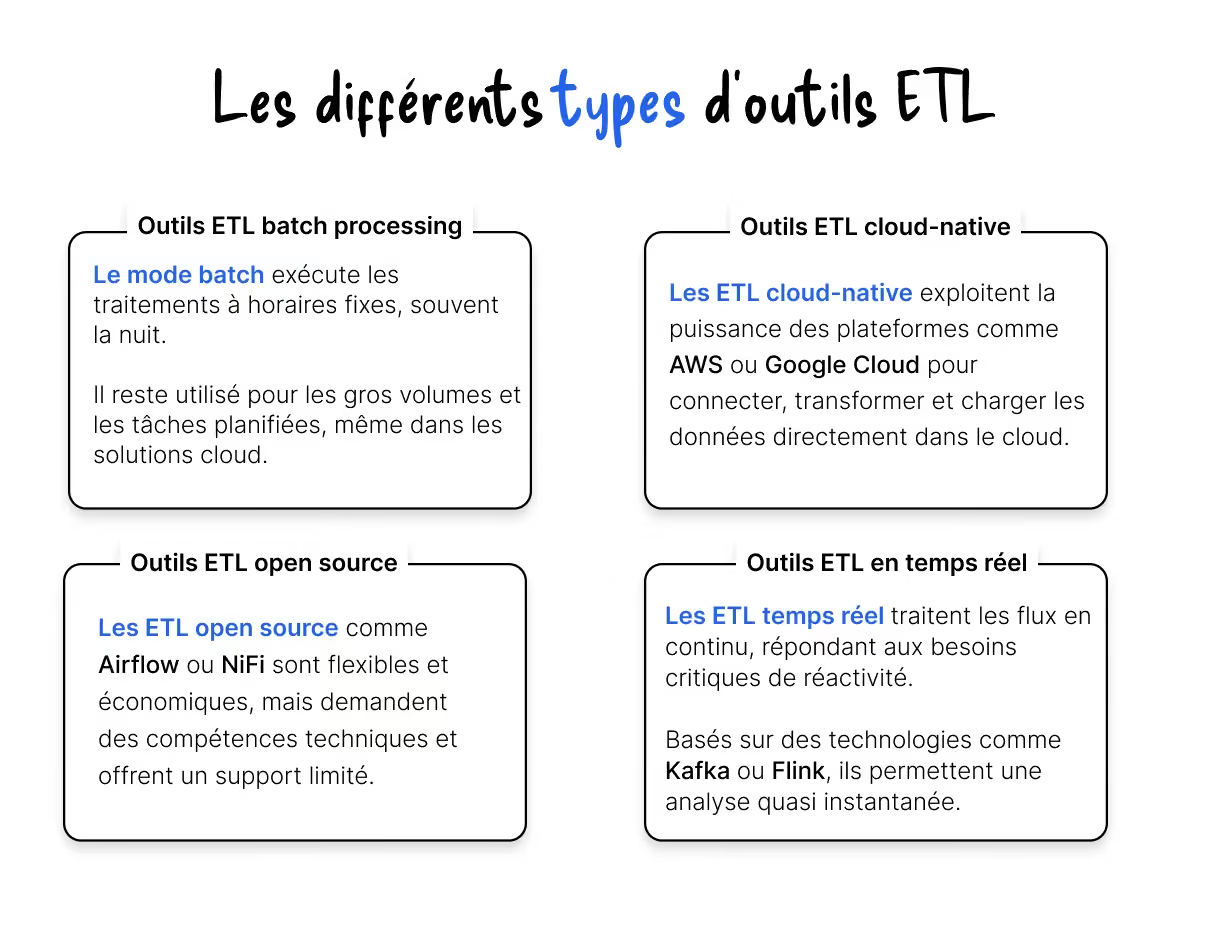
Quatre grandes familles existent :
• Outils ETL traditionnels (Talend, Informatica)
• Outils cloud natifs (AWS Glue, Azure Data Factory)
• Outils open source (Apache NiFi, Airbyte)
• Outils orientés streaming (Kafka Streams, Spark Streaming)
Chaque famille répond à des besoins techniques distincts.
Aperçu de trois outils ETL populaires
Le marché propose aujourd’hui de nombreux outils ETL, allant des logiciels OCR open source aux plateformes commerciales complètes.
Voici trois outils représentatifs aux positionnements complémentaires : Talend, Apache NiFi et Informatica.
Talend
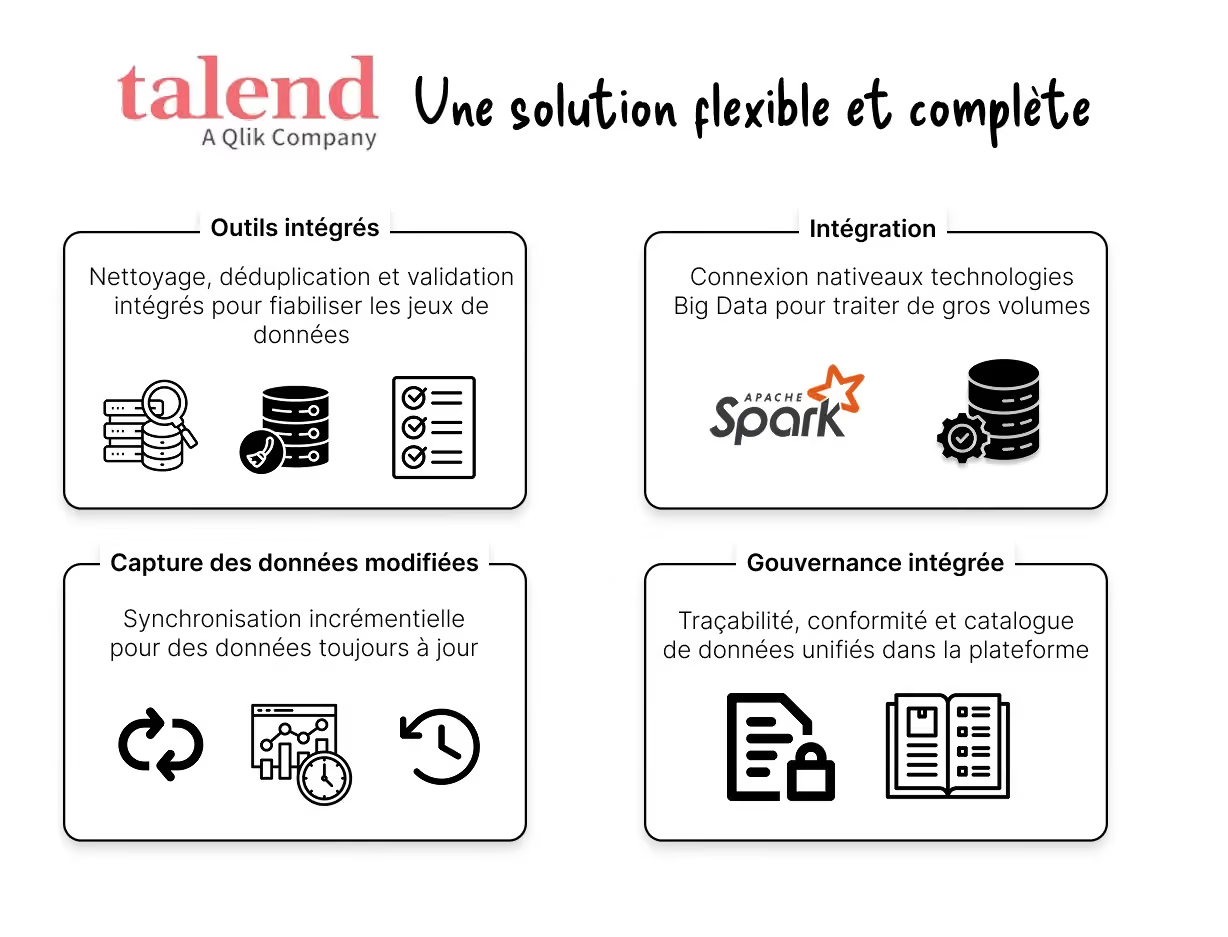
Talend est une solution largement utilisée pour l’intégration de données, disponible en version open source (Talend Open Studio) et commerciale (Talend Data Fabric).
Talend est apprécié pour sa polyvalence et sa capacité à s’adapter à des architectures hybrides, y compris avec des outils de data science.
Apache NiFi
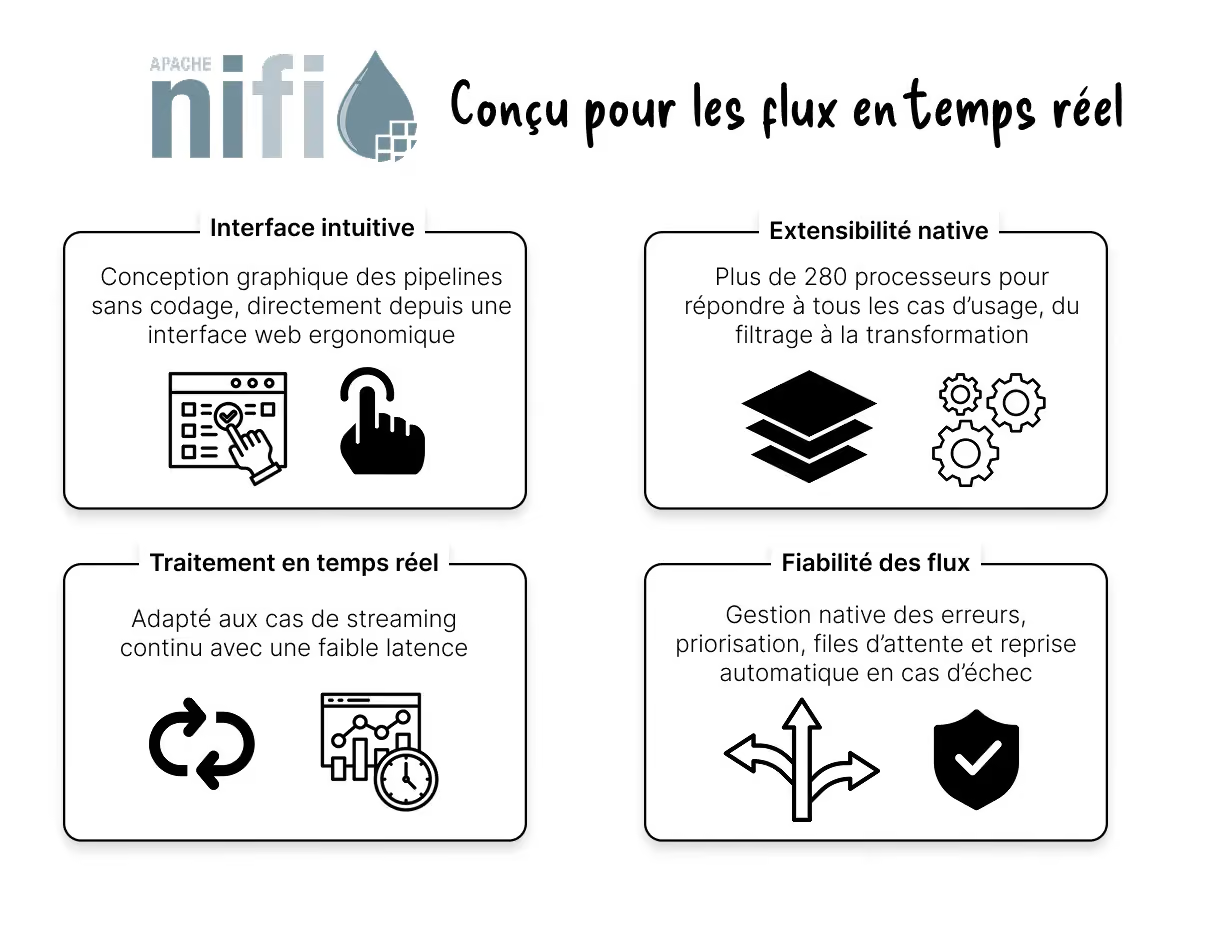
Apache NiFi est un outil open source axé sur le traitement des données en flux continu. Il permet de concevoir visuellement des pipelines via une interface web intuitive, sans codage.
NiFi est particulièrement adapté aux environnements nécessitant une réactivité immédiate, tout en offrant une grande modularité.
Informatica PowerCenter
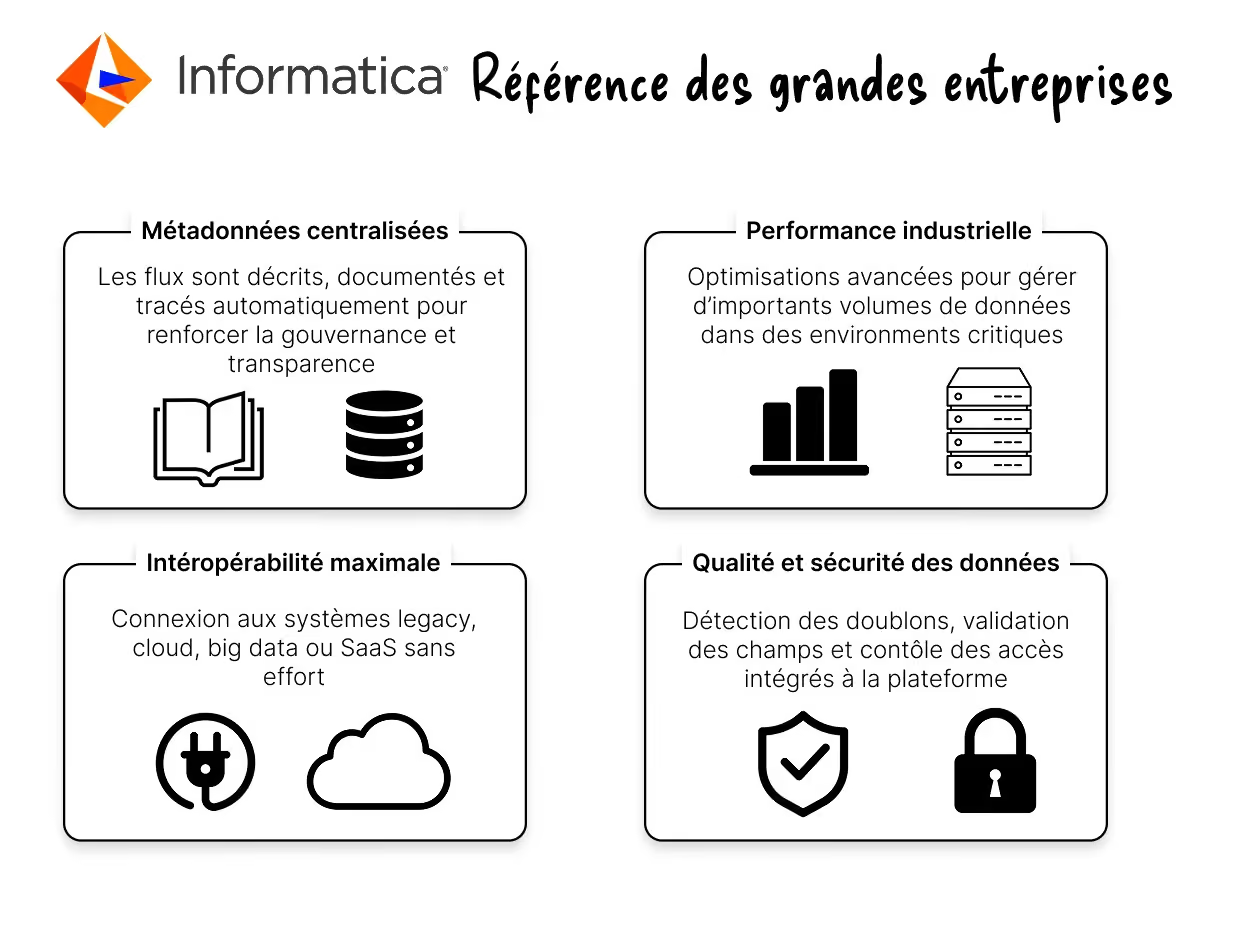
Informatica PowerCenter est une solution commerciale reconnue pour ses performances en environnement de production. Elle repose sur un moteur piloté par les métadonnées, facilitant la documentation et la gouvernance des flux
Informatica est privilégié par les grandes structures pour des projets critiques où la robustesse et le support sont essentiels.
Conclusion
L’ETL demeure un pilier de la gestion des données modernes.
Malgré l’essor du streaming ou de l’ELT, il reste indispensable pour garantir qualité, cohérence, centralisation et gouvernance.
Le choix d’un outil dépendra toujours du contexte métier, des volumes, des contraintes opérationnelles et du niveau d’automatisation souhaité.
FAQ
Nos retours terrain sur l'automatisation documentaire
Top 10 des logiciels de détection de fraude documentaire en 2026
Voici un comparatif des 10 meilleurs logiciels de détection de fraude documentaire et des six contrôles qu'un faux document de 2026 doit encore réussir à passer. Chaque chiffre de précision avancé sur ce marché est souvent autodéclaré et non vérifié de manière indépendante. Pendant ce temps, des services de fraude documentaire vendent, ouvertement et sur le web, des documents conçus spécifiquement pour déjouer des éditeurs de détection.

Tesseract OCR : toujours le meilleur OCR open source en 2026 ?
Parmi les nombreuses solutions disponibles sur le marché, Tesseract est souvent cité comme l'un des meilleurs logiciels OCR open source. Mais est-il toujours la meilleure solution en 2026 ? Nous analyserons ses performances, avantages, inconvénients et les alternatives OCR open-source.
Des développeurs créent MacDoc, un outil illégal de création de faux passeports
En février 2026, la justice américaine a fermé OnlyFake, un outil de génération de faux documents largement utilisé. Quelques semaines plus tard, un service identique a rouvert sous le nom de MacDoc. Ses faux parviennent à déjouer les contrôles “KYC” de grandes institutions comme Paypal, Airbnb ou Coinbase.
Deepfakes documentaires : détecter les faux que vos contrôles laissent passer (2026)
En 2026, la fraude documentaire a un nouveau visage : le deepfake documentaire, un faux entièrement généré par IA. D'après l'Identity Fraud Index 2026 de Shufti, c'est la catégorie de fraude qui progresse le plus vite, avec une hausse annualisée estimée à près de 3 900 %. Leur particularité : ils sont propres en surface. Voici comment détecter ceux qui passent encore vos contrôles.
5 meilleures solutions OCR françaises pour extraire vos données de documents
Cinq solutions OCR françaises permettent aujourd'hui d'extraire automatiquement les données de vos factures, contrats et documents comptables grâce à la reconnaissance optique de caractères, avec un hébergement localisé en France. On les présente ici.